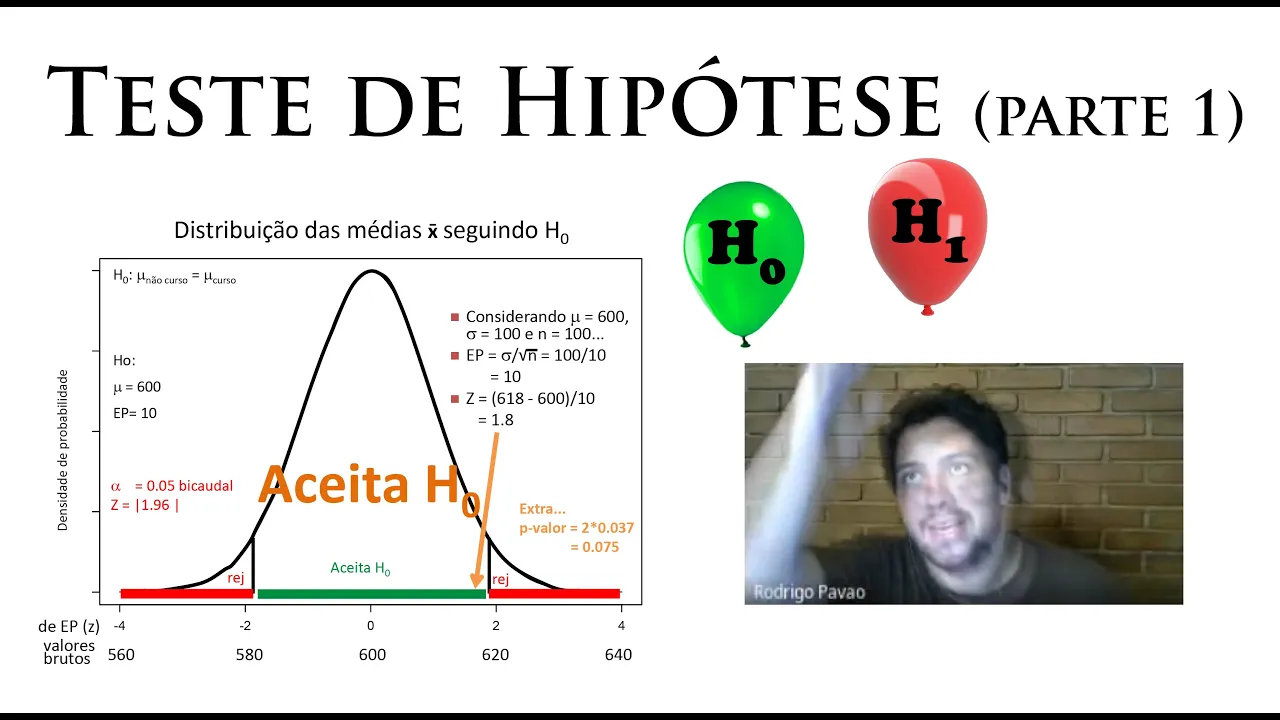
a gente tá trabalhando com amostras né e a gente tá tentando fazer uma inferência sobre população eu vou pegar uma população que eu sei que tem uma média mi e um desvio Sigma eu vou fazer uma amostragem dessa população e chegar numa amostra que vai ter um tamanho n nem precisa ter coletado o que que a gente já sabe sobre o x Barra dessa amostra a gente já sabe que o x Barra vai vir dessa distribuição de probabilidade que é uma distribuição de probabilidade centrada No Mi e com desvio padrão Sigma dividido por R de n isso aí é aquele conceito super importante distribuição das médias amostrais né que a gente falou bastante na aula três a gente fez simulações e tal mostrando que essa coisa funciona deixando isso aqui um pouco mais tangível né e depois a gente usou a distribuição das médias amostrais para começar a fazer inferências partir então de uma amostra que tem esse tamanho n uma MDA x Barra e um desvio s a gente já sabe que essa amostra tem uma incerteza associada x Barra o melhor estimador de mi onde tá centrada essa incerteza né esse desvio padrão S dividido por √ n é o melhor estimador do Sigma n que vem daqui né é a mesma coisa a gente só colocou o melhor estimador dessa média e o melhor estimador desse erro padrão aqui substituindo pelas estatísticas da amostra e com base nessa Incerteza de x Barra a gente construiu o intervalo de confiança de X bar o então o x Barra né então onde ele vai est centrado mais ou menos um t um t ou um z a gente tá colocando T porque é um caso mais geral né o t é uma distribuição que serve tanto para amostras pequenas quanto amostras grandes dessa tabela T de Student ou faz no R lá o comando qt para conseguir chegar no T correspondente o t crítico mínimo e o t crítico máximo que estão Associados a essa probabilidade central de 95% Mas enfim x Barra mais o t de erros padrões né então ele já é é um escalador de erro padrão multiplicado pelo próprio erro padrão né o s dividido pela raiz do n o intervalo gerado por essa ferramenta vai cobrir o mi populacional em 95% das amostras geradas né Então essa é a lógica do intervalo de confiança que é uma primeira inferência que a gente tá fazendo sobre a população a partir de uma estatística mostral Esse é o conteúdo da aula quatro então a gente já passou por esse primeiro pedaço aqui que é a parte de estimação né então estimo que a média de população seja um número tal com intervalo de confiança tal e tal e agora a gente vai fazer a segunda parte de usos da referência estatística que é fazer teste de hipótese eu quero falar ah a média da população é maior do que tanto com P valor tanto vamos esmar isso e passo a passo conseguir fazer esses testes de hipótese efetivamente então a ideia aqui é usar a mesma distribuição das médias a mostrar para fazer o teste de ptes então podemos usar a distribuição das médias amostrais para estimar a probabilidade da Média populacional está em alguma região e o objetivo aqui é distinguir entre dois cenários um cenário associado a uma variabilidade ao acaso o seu x bar não é exatamente o mi Porque tem uma variação ao acaso que é esperada n suas medidas de média mas tem um outro lado que olha tem alguma coisa além do acaso né Tem algum fenômeno outro interessante acontecendo aí o acaso sempre vai tá lá né mas existe alguma outra coisa algum outro fenômeno acontecendo Então el tá querendo distinguir entre esse caso que seja só o acaso a a hipótese nula né o Então essa hipótese que não existe nada de interessante aí é só o acaso que estaria gerando o que você observou só a sua evidência Ela poderia ser gerada apenas pelo Acaso apenas pela hipótese nula e tem um outro caso que seria Olha Putz pela hipótese nula isso aqui aconteceria com uma chance muito pequena então is daí a gente rejeita essa hipótese nula só dando cena nos próximos capítulos aqui el está querendo distinguir Entre esses dois cenários e a gente precisa definir os limiares dessa dessa distinção que seria os casos muito raros né esses casos improváveis e aqui no meio seria esses casos prováveis e aonde que a gente coloca esse Limiar Põe aqui põe mais para cá Põe mais para cá esse é um ponto que a gente precisa definir onde que é esse Limiar para conseguir falar que o que aconteceu ali é por acaso ou parece que tem alguma coisa a mais algum efeito interessante ali todo mundo que trabalha com pesquisa pesquisa experimental usa teste de hipótese né quem tá fazendo EC aí certamente já penou um pouco com análise de dados e já teve que usar alguma ferramentinha aí para fazer testes de hipótese e a gente vai apresentar essa essa questão aqui através de um exemplo e esse exemplo vai ser de novo com notas do ENEM eu já vou dar para vocês aqui como que a nossa população se comporta as notas do ENEM seguem uma distribuição normal com 100600 e Sigma 100 daí tem uma empresa que oferece curso para estudantes prestar Enem e ela fala que os estudantes que fizeram esse curso tem uma nota mais alta do que esse 600 eles aplicaram esse curso para 100 alunos e tiveram uma média de 618 é claro que você tem que falar Poxa para conseguir fazer inferência esses 100 alunos eles têm que ter sido pegos completamente ao acaso qualquer elemento dessa população poderia ter sido incluído nessa amostra Então seria uma amostra representativa Tá mas vamos supor que foi feito bem né então que eles conseguiram escolher 100 alunos ao acaso e tiveram lá a nota média do Enem desses 100 alunos foi 618 e a gente tá querendo testar se essa afirmação é válida né então será que esse curso efetivamente melhor as notas e como que a gente pode testar isso usando as nossas ferramentas de inferencia primeiro a gente tem que lembrar né O que que é a nossa hipótese nula como C seo aqui existe a possibilidade de que esse 618 tenha surgido por mera flutuação estatística por mero acaso isso poderia ter acontecido tá então essa vai ser a nossa hipótese nula e depois a gente vai fazer o quê construir uma distribuição esperada das médias se a hipótese nula for verdadeira e é ali que a gente vai usar a distribuição das médias né distribuição das médias amostrais a gente já tem um Sigma a gente já tem um mi e a gente já tem o N Ou seja a gente tem todos os elementos para conseguir construir a nossa distribuição das médias então a gente conr essa distribuição considerando esses dados que a gente já tem o mi o Sigma e o n e daí é só construir o erro padrão né o Sigma dividido por R do n Então chega no erro padrão 10 e depois a gente aplica aquela transformação Z né ou seja para pegar esses dados que estão em escala de dado bruto pontuação do Enem para chegar numa escala de erro padrão né é uma escala de erro padrão que a gente tem acesso a gente usa lá o p enorme q enorme do qt PT ou usa a tabela t ou usa a tabela Z a gente tá sempre trabalhando com o dado normalizado né que ele tem em média zero e desvio o padrão um ou seja aqui a gente pega esse dado e joga para essa escala de erro padrão né então qual que é a distância entre 618 e 600 na unidade de erro padrão que é 100 ou seja tem 1. 8 erro padrão nesse Z que a gente consegue buscar na nossa tabela Quando que o z pode ser maior do que 1. 8 e a gente encontra que isso acontece em 3.
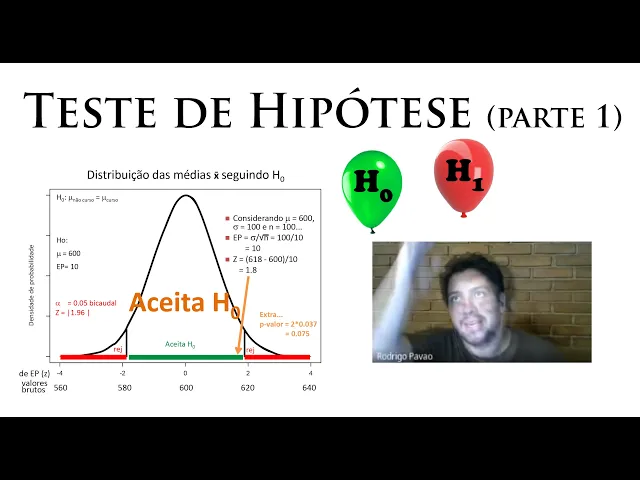
7% e Dev você fala Poxa essa probabilidade é baixinha né ao acaso eu encontraria um número igual ou maior 6 18 eu falo Poxa parece improvável que seja o acaso acho que o curso efetivamente funciona a gente pode discutir mas quanto que deveria ser esse Improvável né tem a convenção de usar 5% né então se a probabilidade aqui for menor do que 5% você poderia então rejeitar a hipótese nula e cair na sua hipótese alternativa né que o nosso caso aqui era que o curso melhorava né Geralmente se usa 5% mas tem gente que usa um pouco menor essa é uma convenção mesmo e esse aqui é o caminho todo para fazer um teste de hipótese parece que tá tudo tranquilo a gente vai fazendo passo a passo parece que tá tudo bem mas tem que usar uma formalidade muito clara para não fazer besteira e aqui tão os cinco passos para formalizar isso e fazer de uma forma bem analítica passo a passo passo um que é estruturar a hipótese nula ou h0 anotação que se dá para hipótese nula e apenas o acaso está regendo a variabilidades do seu dado né que não tem nada de interessante ali que é só o acaso né isso tem que lembrar na hora de definir uma hipótese nula e o passo dois é definir a hipótese alternativa que é o oposto da nula né então seria tem alguma coisa interessante ali o curso muda a nota do do cara o terceiro passo é estruturar a distribuição regida pelo Acaso estruturar a distribuição Caso h0 seja verdadeira Aí passo quatro é encontrar nessa distribuição regida pela pela hipótese n Quais são as regiões em que se aceita ou rejeita o h0 daí é colocar lá ah o 5% de um lado ou divide bota 2,5 para cada lado e define Então a partir daquele critério por um lado eu aceito por outro lado eu rejeito a minha hipótese nulo e depois por último por último que você faz o seu teste de significância da hipótese nula quer pegar a sua evidência pegar sua média e ver aonde que ela caiu se ela caiu na parte de aceitação ou na parte de rejeição da hipótese nula Tá então vamos olhar o passo primeiro estruturar a hipótese nula ou h0 tipicamente o que se usa como hipótese nula é que as médias são iguais a média de quem faz o curso é igual a média de quem não faz o curso o segundo passo estruturar a hipótese alternativa ha tem duas opções usar uma alternativa unicaudal ou direcional uma coisa maior que a outra ou usar uma estratégia bicaudal ou não direcional vai falar ó Isso aqui é só diferente então aqui é uma estratégia unicaudal a média um é menor do que a média dois ou a média um é maior do que a média dois a média da população que não tem acesso ao curso é menor do que a média da população que faz aquele curso né então ess seria numa alternativa direcional ou unicaudal né apenas um lado da distribuição apenas uma cauda da distribuição a alternativa bicaudal ou não direcional seria ó a média do um é diferente da média do dois a média média da população que não faz o curso pode ser tanto mais alta quanto mais baixa que a média do curso eu tinha falado que a hipótese nula tem que ser complementar a hipótese alternativa né então aqui é complementar do igual é o diferente né se a gente quisesse colocar a alternativa como não curso é menor do do que a média do curso a gente teria colocar um menor igual aqui né Tá então é só se ligar que a hipótese nula e a hipótese alternativa tem que ser sempre complementares e daí você vai usar o quê a unicaudal ou a bicaudal a unicaudal Exige uma lógica Clara você tem que saber muito bem como seu sistema funciona você tem que ter uma teoria muito boa sobre o seu sistema uma justificativa sobre como o seu sistema funciona aqui eu coloquei um caso em que tem uma lógica Clara poeira aumenta a falha do HD do computador é nenhuma evidência de colocar poeira dentro do HD possa fazer o HD funcionar melhor então é muito razoável você usar um teste unicaudal Num caso como esse e aqui um outro caso seria a empresa do curso diz ah a gente tá interessado em saber se o nosso curso ajuda isso aqui já é uma justificativa muito fraca pois o curso pode melhorar ou pode piorar um professor de um curso uma disciplina que não tá bem organizada pode te ensinar conceito errado pode te desmotivar pode te prejudicar de várias formas assim como pode te ajudar a gente não tem uma justificativa Clara para falar que um determinado método ajuda ou atrapalha tá então essa aqui é uma justificativa fraca num caso como esse tem que usar uma estratégia mais conservadora que não depende dessa lógica permitida então mudança pros dois sentidos né o curso pode melhorar ou atrapalhar é mais razoável usar bicaudal né então não direcional que nem essa né a média do curso pode ser mais alta ou mais baixa então eu usaria uma bicaudal associada a uma hipótese nula então de igualdade entre as médias fizemos passo um passo dois que é definição das hipóteses agora vamos o passo três que é estruturar uma distribuição regida pela hipótese nula é desenhar uma distribuição inha colocando o mi da hipótese nula o Sigma e e o Sigma não né colocando o erro padrão né que é o que é o Sigma dividido pela ra n a média era 600 o Sigma era 100 você chega no erro padrão 10 tá então eu tem um mi 600 onde ele tá centrado e um erro padrão 10 e aqui eu coloquei essa distribuição normal em duas escalas uma escala de erro padrão né que é essa escala z ou escala t esse dado normalizado né que ele vai ter média zero e desvio padrão um que no caso nosso é a média da da população que faz o Enem que não tem acesso a aquele curso a gente tá colocando a distribuição das médias aqui né tem o desvio padrão um né então aqui tá colocado menos dois desv padrão que tá aqui 20 pontos menor do que a média né simplesinho né só colocando essa distribuição Rida pela hipótese nula nas duas escalas e daí uma vez que a gente definiu isso a gente vai pro passo quatro é identificar nessa distribuição Quais são as regiões em que se aceita ou se rejeita a hipótese nula e a gente vai fazer isso usando o alfa o nível de significância Geralmente se usa o nível de significância de 5% que eu falei né Essa é a convenção às vezes é um pouco mais baixo em vez de 5% usa 1% às vezes até mais baixo e raramente mais alto do que 5% então seria colocar o 5% espalhado em dois lados 2,5 para esse lado e 2,5 para esse lado quando a gente adota esse Alfa de 5% a gente já tá assumindo um erro poe nula for verdadeira você espera rejeitar sua hipótese nula em 5% dos casos Então se só o acaso reinar ali você já rejeitaria a hipótese nula em 5% dos casos Afinal a gente tá pegando lá distribuição regida pela hipótese nula tá jogando 2,5 de cada lado aente já tá assumindo um erro esse erro a gente chama de erro tipo um ou falso positivo e esse 5% é a taxa de erro tipo um ou a taxa de falso positivo Então isso é uma coisa que você define a priori né então vou fazer um experimento vou usar um alfa 5% e eu já sei que se for só o acaso que tá regendo as minhas medidas eu já sei que eu vou ter uma chance de fazer um erro de 5% caso a hipótese nula seja verdadeira então tá aqui a nossa distribuição a gente pegou aquele 5% bicaudal a gente tá usando tabela normal né o n É gigante né o n é 100 Então tudo bem usado normal é uma boa aproximação e a gente botou lá o z em 1. 96 tanto negativo quanto positivo e ali vai ser a nossa área de rejeição colocando o alfa de 5% numa distribuição normal a gente vai ter que o valor crítico é o 1. 96 negativo e positivo dentro desse intervalo - 1.
96 até 1. 96 a gente aceita a nossa hipótese nula e se a nossa média cair pro lado de lá mais negativo que - 1. 96 ou mais positivo do que 1.
96 a gente rejeita a nossa hipótese nula a gente fala Olha tem alguma coisa além do acaso fizemos o passo quatro agora a gente cai no Passo cinco que agora de fato é olhar a nossa amostra né olhar a média que a gente encontrou é ver onde que a nossa média encontrada cai e nossa evidência empírica cai na área de aceitação ou na área de rejeição se ele cair na área de aceitação a gente aceita ou mantém a hipótese nula que a hipótese mais parcimoniosa é a variação a acaso Se ela cair na área de rejeição a gente rejeita a hipótese nula o resultado não parece surgir por variação ao acaso então a gente estava com aquele desenhinho com a nossa distribuição regida pela nula as nossas regões e daí a gente pega o nosso x Barra né o 618 numa escala de valor bruto você já vê que ele cai um pouquinho mais para cá né o 2 seria o 620 ele tá um pouquinho mais para baixo mas o jeito melhor aqui é olhar em função do dado normalizado né que a gente já sabe que aqui é exatamente 1. 96 né E você viu ali que deu 1. 8 se deu 1.
8 ele tá para dentro da área de aceitação tá aceitou hipótese nulo Esse é o resultado do seu teste e finalizou se quiser dar um passo Extra você calcula o p valor para fazer na tabelinha tabela Z tabela T é bem difícil de chegar no P valor exato isso é uma coisa que surge usando o método computacional né aliás no método computacional ele só te dá o p valor e você tem que comparar ele com o alfa você mesmo né então você tem que saber que o seu Alfa é 5% se só olha queele seu P valor e compara com o seu alfa e o p valor é aquele valorzinho que a gente tinha encontrado lá você lembra que quando a gente tinha rodado pela primeira vez tinha dado 0. 37 que é aquele valorzinho associado a 1. 8 como você tá usando um teste bicaudal você tem que pegar pegar esse 0.
37 e multiplicar por 2 e então você chega num P valor de 7,5 por. Tá o que que significa esse P valor 75% você poderia encontrar um valor igual ou mais extremo do que aquele que você encontrou na sua média pelo por acaso com probabilidade de 7,5 por. Ou seja é 7,5 de encontrar pelo poro acaso um valor igual a esse 618 ou mais extremo tá é isso que o p valor diz então esse é um valor que só se refere a hipótese nula Então seria Qual que é a chance de encontrar aquela sua média ao acaso então a gente encontraria aqui algo como 7,5 por né é que não não é a média né a média ou mais extremo né Se você pegar a área embaixo de um ponto é É zero né então você tem que definir o intervalo e é o intervalo do valor que você encontrou pro mais extremo né pro mais distante do zero por mais distante da Média fizemos aqui um teste de hipótese aceitamos a nossa hipótese nula e definimos nosso P valor passando por esses cinco passos estruturar hipótese nula estruturar hipótese alternativa e estruturar a distribuição regida pela hipótese nula usando o mi e o erro padrão identificar as áreas de aceitação e rejeição da hipótese nula Com base no Alfa e por último conduzir o teste de significância é ver onde caiu a sua evidência empírica Onde caiu o seu x Barra na área de aceitação ou na área de rejeição e dependendo de onde caiu você toma a decisão aceita a hipótese nula Ah eu poderia encontrar isso pelo Acaso com uma chance grande P valor acima de 5% se cair naa de rejeição você rejeita sua hipótese nula fala ah é raro de encontrar o meu PV valor é menor do que o 5% se o p valor for menor do que o alfa né Geralmente se usa 5% né a média observada difere da minha média populacional com essa tal estatística de teste aqui então você pode usar o z ou o t né aqui a gente viu esses dois tipos de estatística normalizado então para esse Z essa probabilidade que a gente encontrou é menor do que 0,5 V fazendo um teste vi caudal a outra é falar a diferença foi significante com esse tal Z esse P bicaudal ou rejeitamos a hipótese nula o z o p e falando ess é monocaudal caudal Esse é um jeito de representar quando você tem um p valor pequeno né um p valor menor do que o alfa e se for um p valor maior do que o alfa Então você coloca lá o seu P valor Meu p deu maior do que 0,05 ou a diferença falhou atingir a significância estatística ou aceitamos a hipótese nula Esses são os vários jeitos de representar o seu resultado vamos pular pro R então que que eu vou fazer no R aquele exemplo do Enem que tá aqui com média 600 Sigma 100 né Essa é distribuição da da população em geral e daí as pessoas que fazem o curso uma amostra de 100 alunos tem uma média de 618 eu quero testar essas coisas para usar a função Nativa de R A gente tem que ter uma amostra o que a gente tem ali eram só as estatísticas da amostra né o r para trabalhar com dado do mundo real né em que você tem o dado na tua mão e quando você não tem você tem que simular é a vida meu objetivo é produzir uma amostra que tenha média 618 e desvio padrão 100 eu tô mostrando como que faz para simular essa amostra tá então primeiro eu gerei números aleatórios depois eu for sei com que ele estivesse média zero desvio padrão um e agora eu vou escalar pro número que eu tenho interesse eu vou rodar isso aqui e agora vou olhar qual que é a média da minha amostra exatamente 618 qual que o desvio padrão exatamente 100 tudo isso Para quê Para conseguir usar a função Nativa do R essa daqui ttest tá a gente já tinha usado ela na aula passada né para computar intervalo de confiança e agora a gente vai fazer um teste de hipótese usando essa função Nativa do R tá então a gente vai pegar a nossa amostra a notas de ENEM desses 100 alunos aqui e o que eu vou comparar essa amostra com a minha distribuição que tem média exatamente 600 16600 tá e eu vou fazer do mesmo jeito que a gente tinha feito ali aqui é um teste unica caudal né Eu só tô procurando quando a nota da Média fica maior né então a minha hipótese alternativa é de que ela é maior do que a hipótese nula a média da população de onde eu tirei essa amostra Ela é maior do que 600 Tá então vamos rodar essa linha aqui ele vai dar um outp gigante então já vou abrir um montão aqui a o o a telinha do meu console e vou rodar esse essa linha aqui tá T test da minha amostra comparando com uma hipótese n com 1600 eh fazendo o teste de que a a minha média populacional é maior do que a minha média da hipótese nula tá então eu rodei essa linha e daí ele falou ó eu fiz um test T de uma amostra e daí ele deu T 1,8 que que esse T 1,8 era o que a gente tinha visto lá é a nossa média observada escalada pro erro padrão a gente tem o nosso T observado aqui de 1.
8 a distância em relação à média da hipótese nula em unidades de erro padrão da hipótese nula então o nosso T é 1. 8 o grau de liberdade é 99 lembrar que o grau de liberdade é o n -1 e o p valor de 3. 7% né a chance de encontrar pela distribuição das médias regida pela nula é um número maior do que 1.
8 e daí chega lá no 0. 037 ou seja os 3. 7% tá é isso que ele já deu de output pra gente tá E ele fala aqui ele só informa ele não tá fazendo nenum julgamento Ele só tá informando que a a hipótese alternativa é que a média da da distribuição de onde veio essa amostra é maior do que a da nossa hipótese nula que é de 600 isso que a gente tá testando né então a gente tá fazendo um teste t de uma amostra com a nossa hipótese alternativa que é maior do que a média 600 da hipótese nula beleza Tá feito aqui né depois ele só fala Qual que é o intervalo de confianç e fala qual que é a média Tá mas isso aqui foi o caso que a gente tinha feito aqui né esse teste unicaudal né nosso teste direcional e agora vamos fazer o outro teste que é aquele eh não direcional tá então aí a gente tem que falar aqui ó que é de dois lados teste de B cdal é a mesma coisa só falando que é um Baldão rodamos então da ele dá um p valor maior né antes tinha dado um p valor de 0,37 agora deu aquele P valor que é o dobro daquilo duas vezes o p valor né o t é o mesmo 1.
8 o grau de liberdade é o mesmo 99 só que aqui quando a gente tá usando out Side a gente só fala a hipótese alternativa é que a média de onde veio essa amostra não seria igual a da hipótese nula né Então essa é a nossa hipótese alternativa é isso que a gente tá testando e aqui ele dá um p valor né lembra que eu tinha falado que quando você roda um desses programas de estatística ele só só cospe um p valor então aí você tem que fazer a comparação com o alfa você mesmo né então usando um Alfa de 5% aqui a gente tá com P valor maior Ou seja a gente tem que aceitar a hipótese nula é possível encontrar pelo Acaso uma média 618 vindo de uma distribuição nula centrada no 600 considerando esse tamanho de amostra tá então aqui a gente tem um p valor alto então a gente aceitou a hipótese n aqui quando a gente usou esse teste unicaudal né né quando você faz esse teste unicaudal você tem um p valor que é metade do outro né aqui daí que poderia rejeitar hipó ser nula né mas parece que isso aqui tá mal n a gente poderia pensar ó pode testar só pro outro lado né se tivesse uma teoria que explica por que que aquele curso só piora só que daí ele na verdade não piorou né ele foi para 618 se a gente colocasse aqui a média da hipótese alternativa ela seria menor do que da hipótese nula né daí ele dá um p valor gigantesco né ele dá o complementar aquele 3% que a gente tinha visto antes que é o 96 e tanto por. esse é o jeito que se faz teste de hipótese para uma amostra comparando com uma hipótese nula que tem um parâmetro Beleza é assim que faz para usar a função Nativa do R então agora vamos passar por todo esse caminho que a gente tinha feito na mão como que seria feito isso se a gente não tivesse simulado o dado né só para ver se dá exatamente a mesma coisa tá então fazendo na mão passo um define a hipótese nula a média da população que faz o curso é igual à média da população que não fez o curso passo dois a hipótese Alternativa de que que a média de quem fez o curso é diferente da média da população de que não fez o curso esse aqui é o símbolo né de diferente para fazer comparação no R um é diferente do dois sim é verdade um é diferente do dois e o dois é diferente do dois falso não o dois é igual dois então é falso então só isso aqui é o símbolo que se usa para diferente aqui não é código né Eh é só para saber o que que significa essa anotação inha aqui é uma anotação que funciona no R tá então passo um definimos a hipótese nula que as médias das populações são iguais hipótese alternativa que as médias das populações são diferentes e agora a gente vai pro passo três né que era construir a distribuição regida pela hipótese nula então pela escala de valor bruto a gente vai usar dois parâmetros um que é a média e outro que é o erro padrão né aquele Sigma dividido pela raiz do n Nosso Erro padrão D Quanto pode até botar aqui que é 10 e isso aqui é na escala de valor bruto né então a gente vai Construir aquela distribuição centrada no 600 e que vai ter um desvio padrão né um desvio padrão da Média aqui de 10 a gente pode colocar isso em duas escalas né a escala de valor bruto que tá aqui embaixo a gente pode colocar também na escala de erro padrão né então que que o erro padrão na escala de erro padrão é um né é o óbvio né centrada no zero tá tem que fazer na mão né vou fazer num outro gráfico aqui eu não desenhei no R tá passo quatro identificar as regiões em que aceita ou rejeita a hipótese nula né Em qual em qual região que aceita a hipótese nula né a gente tem que chegar nesses valores críticos aqui aqui eu fiz com distribuição Z né mas aqui no R eu posso já usar T né que fica até mais preciso então eu vou colocar lá qual que é o valor associado as probabilidades de 2,5% e 97% eu tô chamando de T crítico então o valor crítico de uma distribuição t para essas probabilidades com o grau de liberdade 99 né que é o 100 menos o 1 né o n Men 1 aí roda esse treco aqui tem meu valor crítico e daí ele não deu 1. 96 ele deu um pouquinho mais para fora né o menos 1.
98 e um mais 1. 98 mas é quase a mesma coisa equivalente tá esse é o valor bruto e o eu posso pegar também o bruto crítico eu tenho o t crítico que tá em escala de erro padrão mas se eu pegar esse valor em escala de erro padrão e multiplicar pelo meu erro padrão que é 10 e somar a minha média eu chego no meu bruto crítico né que é o 580 e o 619 tá então seriam esses valores aqui o 580 15 e o 619 que tá para cá e aqui deu uma diferenc né de usar 1. 98 versus usar 1.
96 Mas enfim esse aqui é o jeito mais preciso delimitamos as regiões de aceitação e de rejeição que tem esses limites aqui em P na escala de erro padrão Ou na escala de valor bruto então aqui é a escala de erro aqui é a escala de nota né e depois por último vamos olhar aonde que caiu o nosso observado a gente tem o bruto observado que é a nossa média no nosso x Barra n a média de nota dessa 100 pessoas e 618 aí eu posso jogar pra escala de erro padrão e daí eu chego lá no meu 1. 8 e daí eu olho o meu 1. 8 ele é maior do que o valor mínimo do meu intervalo ele é ele é menor do que o valor máximo ele é também ou seja se ele é maior do que o mínimo e menor do que o máximo ele caiu na minha área de aceitação da hipótese nula né e aqui eu posso fazer um um um if né botando essas duas coisas aqui tá então eu testo se ele é maior do que o meu valor mínimo e eu testo se ele é menor do que o meu valor máximo ele é válido nas duas coisas né se eu vejo dois true junto é true também né mas se for verdadeiro essa primeira parte ele vai falar aqui ó aceita a hipótese nula se não Algum deles está falso né ou seja ele vai cair fora então rejeita a hipótese nula Então eu só rodo esse treco e ele me fala pom rodei lá ele falou aceita hipótese nula e era o que eu tinha feito ali aceita hipótese nula e daí o Extra Que el tinha falado era computar o p valor né eu vou usar uma tabela T aqui né Qual que é a probabilidade de uma tabela T Qual que é a probabilidade acumulada do menos infinito até aquele valor de T para grau de liberdade 99 ele vai responder para mim 0.
96 eu tinha falado lá que o p valor era só pegar aqui multiplicar por dois mas se eu pegar 0,96 e multiplicar por 2 eu vou chegar num valor estranhão né um valor de probabilidade maior do que um não faz menor sentido né tá errado um valor de probabilidade maior do que um é meu alarme Tá errado isso aí então daí eu fiz aqui um condicional né se eu falei uma bobagem muito grande falei que o meu P valor é maior do que 1 faz o quê corrige quer fazer faz o quê pegar aquele valor de probabilidade subtrair de um e multiplicar por dois então aqui ele dá um valor absurdo que dá quase dois que não pode ser e aqui eu corrijo ele e faço ele ficar com o valor que faz sentido então se eu rodo isso aqui ele já corrige automaticamente e já me dá o meu P valor que é de 0. 07 e eu só confiro fiz isso aqui bem vou rodar aquele teste que tinha feito na função Nativa do R né aquele ttest que daí deu o mesmo valor né o p valor que a gente tinha feito na mão deu 0.