e aí o olá meu nome é alexandre gori maia abs ela de autocorrelação eu capítulo 13 do livro econometria conceitos e aplicações autocorrelação é a relação de dependência entre os erros e o modelo de regressão por exemplo quando o valor do erro de previsão para a primeira observação está associado ao erro de previsão para segunda observação e assim sucessivamente é comum ter autocorrelação quando o modelo de regressão se baseia em dados de séries temporais ou dados espaciais essa aula está dividida em duas partes essa primeira parte apresenta o conceito as consequências e como identificar a
autocorrelação a segunda parte apresentará as principais estratégias de correção da autocorrelação que são o método de mínimos quadrados generalizados e o uso de estimadores da variância que são robustos autocorrelação e a existência de erros não autocorrelacionados é um dos cinco pressupostos centrais que devem ser satisfeitos para que os estimadores tem aqui ó sejam não visados e os mais eficientes pressupostos esses que fazem parte do teorema de gauss markov essa aula apresenta o pressuposto da ausência de autocorrelação nos erros ou seja não há relação entre os erros e o modelo de regressão autocorrelação é comum por
exemplo em modelos com dados de séries temporais quando os valores e períodos correntes tem a estar associados a valores de períodos passados a autocorrelação pode também ocorrer em modelos com dados espaciais quando valores de uma unidade espacial o município por exemplo estão associados aos valores dos municípios na vizinhança essa aula apresentará o conceito de autocorrelação e modelos com dados de séries temporais também denominada de correlação serial mas os conceitos aqui apresentados se aplicam para outros tipos de autocorrelação por exemplo para autocorrelação em modelos com dados espaciais e modelos de séries temporais eu espero que o
valor do erro no período t não esteja associado ao valor do erro de períodos passados por exemplo ao valor do erro do período ter menos um graficamente isso significa que não há um padrão sistemático na dispersão dos erros ao longo do tempo valores positivos e negativos dos erros se sucedem de maneira aparentemente aleatória é o caso de autocorrelação a dispersão dos erros apresentará um padrão sistemático longo do tempo na figura à direita eu visualizo uma concentração de valores positivos positivos em períodos consecutivos assim como também ocorre com a concentração de valores negativos formalmente eu digo
que a autocorrelação nos erros de um modelo de séries temporais quando a covariância entre os valores dos erros no período t e os valores dos erros os períodos passados for diferente de zero a forma mais simples de correlação serial é quando os valores dos erros no período ter estão associados aos valores dos erros no período ter menos um eu também posso representar esse padrão de correlação serial por um modelo de regressão para os erros no período ter como uma função linear dos erros no período ter menos um esse modelo é denominado de modelo autoregressivo de
primeira ordem para os erros o coeficiente desse modelo é o horror que é denominado de coeficiente de autocorrelação dos erros sua interpretação é análoga ao coeficiente de correlação linear valores positivos de o indicam correlação positiva entre os erros valores negativos indicam correlação negativa é mais valores de negativos de rosca um pouco usuais em relações econômicas a três causas principais de correlação serial a primeira inércia das séries econômicas que costumam apresentar ciclos com leite amortecimento no tempo por exemplo se o analisa a relação entre consumo y ea renda x em um país os erros e representariam
fatores não controlados como otimismo da população é natural esperar que períodos elevado otimismo sucedam períodos e também elevar otimismo ou seja os erros o período ter estariam positivamente relacionados ao seu uso do período ter menos um é a segunda causa é a falha na especificação do modelo por exemplo se eu relaciono poluição y com a riqueza x de um país ao longo do tempo suponha que a poluição seja uma função quadrática da riqueza a poluição aumentaria nos está nos estágios iniciais de crescimento da renda até um determinado ponto de inflexão quando passa aí então a
cair com o crescimento da renda se eu indevidamente ajustar uma função linear para essa relação os erros e períodos próximos ao ponto de inflexão da curva tenderão a ser positivos enquanto que os erros e períodos iniciais e finais e crescimento da renda tenderam a apresentar valores negativos e de maneira análoga à anterior outra causa da alta correlação seria a ausência indevida de valores defasados das variáveis são modelos de regressão se você já novamente o caso da relação linear entre consumo y e renda x o consumo y no período t pode depender tanto da renda x
no período t quanto da renda x no período temos um caso as decisões e consumo presentes sejam pelo menos parcialmente definidas no período anterior eu posso ainda supor que eu consumo y no período ter dependa tanto da renda x no período ter quanto do consumo y no período temos um caso os padrões presentes e consumo também dependam de padrões passados e ignorar a inclusão de regressores defasados no modelo de regressão pode sujeitar os erros a correlação serial e as consequências autocorrelação são análogas às na interesse da cidade a primeira consequência a ineficiência do estimador beta
chapéu de ezequiel ou seja sua variância não ser a menor possível entre os estimadores não tendenciosos de meta e eu que tirei agora o conceito de reticência do estimador já apresentado na aula de heterocedasticidade seja a relação linear simples entre y e x a reta vermelha representa a relação para o valor de esperado y na população que é desconhecida na vida real se você pressiona uma amostra aleatória dessa população e utiliza o estimador beta chapéu de mickey ó eu queria uma estimativa dessa relação apresentada na figura pela reta tracejada laranja utilizamos os dados dessa mesma
mostra eu poderia eu poderia utilizar um estimador diferente também não tendencioso por exemplo se o estimador alternativo beta chapéu asterisco poderia me dar outra estimativa da relação entre y e x que é representada na figura pela reta tracejada a roxa e como chama ativa depende da mostra eu teria estimativas diferentes para a beta chapéu e beta chapéu asterisco caso tivesse selecionada uma amostra diferente por exemplo suponha que a estimativa de mente ó para uma mostra diferente seja representada por esta nova reta para sejam da laranja e esse motivo de beta chapéu asterisco para essa mesma
bosta seja representada por essa outra reta tracejada roxa e sempre hipotético eu cheguei cheguei à conclusão que as retas laranjas e ciladas que o estimador pé tá chapéu dele aqui ó possui o intervalo de variação inferior as setas roxas estimadas pelo estimador alternativo beta chapéu asterisco a curva tracejada laranja definir o intervalo onde provavelmente estariam as estimativas de michael ea variância do estimador beta chapéu é uma proxy para eu medir aqui intervalo aí daí da eficiência do estimador demitiu na ausência de autocorrelação é que o intervalo de variação das setas tracejadas laranjas e representou as
estimativas de michael seriam a menor possível ou seja caso eu utilizo estimador beta chapéu asterisco a variância de cima dor seria igual ou superior a variância de cima d'or demite o nunca inferior e por outro lado caso os erros sejam autocorrelacionados eu demonstre o contrário ou seja a variância do estimador beta chapéu de mickey ó não ser a menor possível existe uma em cima dura alternativo que eu preciso ainda descobrir qual é estou provisoriamente denominado de pé tá chapéu asterisco que possui uma variância inferior à do estimador beta chapéu dele aqui ó outra consequência é
importante da autocorrelação é que a variância do estimador beta chapéu de mickey será tendenciosa mesmo para nossas grandes como eu dependo da variância do estimador para calcular as estatísticas trf os testes de hipóteses associados a essas estatísticas serão inválidas moral da história assim como ocorrem na e ter os e da cidade autocorrelação causa além da ineficiência do estimador beta chapéu a tendenciosidade do estimador de sua variância os2 do beta chapéu e eu apresentarei o caso do modelo de regressão linear simples para compreender o que significa a tendenciosidade do estimador da variância do bessa chapéu os
capítulos 1 e 2 do livro desenvolvem essas expressões para o estimador petra chapéu e o estimador de sua variância os2 do beta chapéu eu consigo demonstrar que a equação para o s2 beta chapéu só é válida casos erros não estejam alto relacionados ou seja caso eu assumo a por exemplo que a covariância entre os erros no período ter e os erros no período ter menos um seja igual a zero nesse caso a real variância do beta chapéu será semelhante aquela definida pelo estimador dentro aqui ó que é o s2 o beta chapéu é possível então
demonstrar que o valor esperado do s2 do beta chapéu será igual a real variância do beta chapéu todavia casos erros estejam autocorrelacionados o valor esperado do s2 do beta chapéu será diferente da real variância do pé tá chapéu supondo por exemplo que os erros vão período te estejam associados aos erros no período ter menos um eu teria então mas não abre expressão para real variância do beta chapéu e a equação do s2 do beta chapéu não converte para essa nova equação que a real variância do beta chapéu mesmo quando a minha mostra grande ou seja
o estimador da variância do beta papel seraph exato e inconsistente e agora eu apresentarei as principais estratégias para identificar a existência de autocorrelação nos erros eu posso analisar graficamente a dispersão dos resíduos de um modelo de mac ó ao longo do tempo identificar padrões de autocorrelação nos erros é ou eu posso ainda realizar testes estatísticos para formalizar a existência de autocorrelação e os testes de autocorrelação mais conhecidos são o tst o teste dormir robson e o psd brush goody foi o tst é o mais simples mais recomendado apenas quando a nossa é grande ou seja
ele é válido assintóticamente ou até se deve watson é o mais utilizado para identificar padrões e autocorrelação de primeira ordem ou seja quando os erros do período ter estão associados aos erros do período temos um sua validade não está condicionada ao tamanho da mostra o teste de boot godfrey é indicado quando eu desejo identificar padrões e autocorrelação com ordem superior a um por exemplo quando os erros do mês ter estão associados aos erros do mês ter menos 12 nesse vídeo eu apresentarei o teste mais popular que é o dedo de um ótimo som você é
mais espécies podem ser consultados no livro é uma maneira simples para identificar autocorrelação é analisar a dispersão dos valores dos resíduos de um ajuste de michael em função do tempo de observação das unidades a mostra a figura no canto superior esquerdo representa um padrão aleatório de dispersão dos resíduos sugerindo que os erros sejam não alto correlacionadas às próximas três figuras representam padrões sistemáticos de expressão dos resíduos ao longo do tempo sugerindo que os erros sejam autocorrelacionado a figura no canto superior direito representa um padrão cíclico de expressão dos vídeos a figura no canto inferior esquerdo
representa um padrão padrasto de dispersão dos resíduos no tempo oi e a figura no canto inferior direito representa um padrão de crescimento linear dos resíduos no tempo e nas três situações eu posso suspeitar que os erros nos períodos correntes estejam associados aos erros dos períodos passados em são exemplo 3.1 do livro eu possuo informações trimestrais para a área plantada y e preço x pago pela tonelada de cana-de-açúcar o primeiro passo é ajustar o modelo por e michael e salvar os resíduos do ajuste em seguida eu analiso a expressão dos resíduos ao longo dos trimestres apesar
de o gráfico não ser conclusivo sugere um aparente comportamento cíclico da dispersão dos resíduos ao longo do tempo ou seja o senhor seriam provavelmente autocorrelacionado o comportamento cíclico pode ser devido a uma série de fatores por exemplo o erro pode representar a expectativa do produtor em relação ao mercado de etanol no futuro que teriam lente amortecimento no tempo autocorrelação pode também ser de vida por exemplo a explosão de regressores defasados no modelo como o preço x da cana no trimestre anterior ou a área plantada y no trimestre anterior após visualizar um padrão aparentemente sistemático de
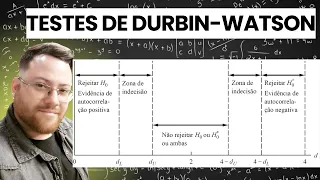
dispersão dos erros no tempo o próximo passo é aplicar na teste estatístico para formalizar a existência ou não de autocorrelação e o teste deve watson é utilizado para verificar a existência de autocorrelação de primeira ordem ou seja quando os erros no período ter podem ser expressos por uma função linear dos erros no período ter menos um em que o gol dessa expressão é o coeficiente de autocorrelação dos erros a hipótese nula do ts é ali que os erros não estão alto correlacionados ou seja o coeficiente errou é igual a zero aí pode ser alternativa e
admitiu os erros estejam alto correlacionados com o padrão de autocorrelação nas relações econômicas é predominantemente positivos a hipótese alternativa usualmente assumir que o coeficiente errou seja positivo e eu preciso agora de uma estatística para testar essas hipóteses a estatística proposta denominada a estatística de bill watterson ou simplesmente dw é uma função dos resíduos obtidos pelo ajuste de michael para a relação entre y e os regressores x e essa estatística tirar uma função de densidade de probabilidade própria com parâmetros dados pelo tamanho da amostra n e o número de regressores do modelo o carro e eu
posso ainda demonstrar que essa estatística de w será aproximadamente igual a 2x o menos cor sendo horror o coeficiente de correlação entre os resíduos no período t os entendidos no período ter menos um a partir dessa expressão eu posso ainda definir e interpretar os valores inferiores e superiores de w e quantos erros não forem autocorrelacionados horror será igual a zero e a estatística de w será igual a 2 e quando os erros estiverem correlacionadas positivamente horror será a próxima se aproximará de um e estatística de w se aproximará de zero e quando os recursos estiverem
autocorrelacionados negativamente o ro se aproximará de menos um e estatística de w se aproximará de quatro moral da história aí pode ser nula de ausência de autocorrelação assume que é estatística de w seja igual a 2 e acontecer alternativa de autocorrelação assumir que a estatística de w seja diferente de dois se eu estou apenas interessado em testar a existência de alta correlação positiva a hipótese alternativa assumiria que estatística de w é inferior a dois nesse caso eu preciso então descobrir o valor p associado ao extremo inferior da função de densidade de probabilidade de w pois
é o extremo que caracteriza valores de w menores que 2 e próximos de zero ou seja alto correlação positiva esse valor p será a probabilidade de erro ao afirmar que os erros apresentam alta correlação positiva e resumindo a estatística de debi watson é utilizada para atestar a existência de autocorrelação de primeira ordem nos erros o intervalo de variação da estatística de w está entre 0 caso autocorrelação seja positiva e quatro caso autocorrelação seja negativa faz os erros não sejam autocorrelacionados o valor de w se aproximará de 2 ou seja falou eles me vw menores que
2 indicam a existência de outro relação positiva e com mais próximos esses valores estiverem zero mais forte será autocorrelação o valor p seria a probabilidade de erro ao afirmar que a autocorrelação os erros ou seja o valor de w seria a menor que 2 assumindo que a autorização seja positiva é uma limitação do psd w é que a função de densidade de probabilidade depende dos valores observados na mostra ou seja uma distribuição única para cada combinação dos parâmetros n que é o tamanho da amostra e kátia o número de variáveis independentes e isso dificulta a
estimativa da probabilidade de erro do teste o valor p pois eu preciso antes definir a função de densidade de probabilidade e os programas estatísticos modernos calculam facilmente esse valor p que dependerá do conjunto de valores da amostra todavia caso eu não disponha de um programa estatístico para calcular o valor p eu preciso consultar uma tabela contendo os valores extremos e inferiores e extremos superiores a distribuição da w robson para cada parâmetro nk eu não entrarei em detalhes sobre essa estratégia nesse vídeo pois eu utilizarei o programa r para calcular a probabilidade de erro do teste
de fale sobre essa estratégia podem ser consultados no livro e agora utilizarei os mesmos dados do exemplo 13.1 do livro para atestar a existência de autocorrelação nos erros para a área plantada da cana-de-açúcar como uma função do preço utilizando a estatística de deve um ótimo o primeiro passo é salvar o seguidos do ajuste de michael para a relação linear entre a de preço em seguida eu quero só a hipótese nula de que os erros são não relacionados a hipótese alternativa é a de que os erros fazem parte de um modelo autoregressivo de primeira ordem ou
seja os erros uma período ter estariam associados aos erros no período ter menos um aí quantos alternativa assumir então que o coeficiente de autocorrelação dos erros horror seja diferente de zero como autocorrelação é usualmente positiva eu posso simplesmente assumir na hipótese alternativa que horror é maior do que zero a minha estatística de teste será a dw estimado a partir dos valores dos resíduos doados teme que o valor obtido é igual a 1,47 a multicenter w inferiores a 2 sugerem a existência de alta correlação positiva ou seja o ro seria maior que zero e a estimativa
da mostra para o vô é de fato maior do que 0 = 0,24 mas eu preciso saber se há evidências significativas para eu afirmar que o valor de w é maior do que 2 ou seja eu preciso calcular o valor p desse teste estatístico oi qual seu nome no caso não disponha de um programa estatístico para calcular o valor de p com base na densidade de probabilidade obtida para os valores observados da mostra poderia utilizar como referência os valores de uma tabela contendo o limite inferior e superior da região crítica para amostra de tamanho 34
e uma variável explicativa no modelo para y esses valores seriam 1,39 e 1,51 e como o valor para nossa estatística de w está dentro desse intervalo meu pé seria inconclusive inconclusivo segundo esse critério mas eu não entrarei em detalhes sobre ele porque pois em seguida eu apresentarei como calcular esse valor te não é e os exemplos 13.1 e 13.2 do livro não é o primeiro passo é ler os dados dos trinta e quatro trimestres para a área plantada e preço pago pela tonelada de cana e em seguida eu aplico m para ajustar uma modelo para
a área como uma função linear do preço pago pela tonelada de cana o que são analisar a qualidade desse ajuste eu preciso me certificar de que os erros não são altos relacionados caso contrário a os testes de hipóteses seriam inválidos primeiro passo é fazer uma análise gráfica e o primeiro eu salvo os resíduos do ajuste de michael e em seguida eu utilizo a função plot para elaborar um gráfico de dispersão dos resíduos em função dos trimestres o gráfico aparentemente isso gera um comportamento cíclico dos erros ao longo do tempo para me certificar de que a
autocorrelação e utilizarei a função deve watson teste do r e o padrão dessa função é fazer um teste bi-caudal ou seja testar a hipótese alternativa de que os erros são positivamente ou negativamente autocorrelacionados nesse caso o valor p seria 0,082 ou seja caso eu afirme que os erros sejam autocorrelacionados positiva ou negativamente eu estarei sujeito a uma probabilidade de erro de 8,2 por centro caso eu queira testar apenas a hipótese alternativa de que os erros apresentam alta correlação positiva eu incorporo um parâmetro essa função e nesse caso eu teria 4,9 porcento de chance de erro
ao afirmar que os erros apresentam uma correlação autocorrelação positiva apenas um detalhe importante os resultados desse valor p se baseia em simulações feitas pelo ellen então vocês podem encontrar valores pés diferentes toda vez que vocês cortaram não necessariamente serão os mesmos e aí e aí e aí e aí e aí e aí