e aí o olá meu nome é alexandre gori maia e essa é a aula de heterocedasticidade é o capítulo 12 do livro econometria conceitos e aplicações o e trouxe da cidade significa a variância heterogênea dos erros ou seja a variabilidade dos erros em torno do modelo de regressão não é constante como pressupoem os estimadores de mínimos quadrados ordinários e essa aula apresenta as consequências da heterocedasticidade como identificá-la e corrigi-la aula está dividida em duas partes essa primeira parte apresenta as consequências e a identificação da e ter os e da cidade a segunda parte apresenta as
principais estratégias de correção a cinco pressupostos centrais que devem ser satisfeitos para que os estimadores de riqueza sejam não viesadas e os mais eficientes se não viesado significa que o valor esperado para o estimador betas até o dn que o é exatamente o parâmetro beta da população e ser mais eficiente significa que a variância decimador beta chapéu é a menor possível entre todos os demais estimadores lineares que sejam também não tendenciosos e os cinco pressupostos são conhecidos na literatura como teorema de gauss markov em são discutidos com mais detalhes o livro essa aula apresenta um
dos pressupostos o da como se da cidade o qual assume que a variância dos erros no modelo de regressão é constante para todos os valores de x os erros de um modelo de regressão serão homocedasticos ou seja haverá homocedasticidade quando a variância dos erros for igual para todos os valores dos regressores fiz a figura abaixo ilustra essa situação e o modelo de regressão linear simples a distribuição dos erros seria a mesma para diferentes valores controlados de x por exemplo para x = x 1 e x = x2 o ou seja usamos apresentar em uma distribuição
normal com variância constante representada a por cima dois seja por exemplo para x = x 1u x = x2 por outro lado os erros e o modelo de regressão serão e trouxe drásticos ou seja haverá heterocedasticidade quando a variância dos erros diferir dependendo dos valores dos agressores x a figura à direita ilustra essa situação a distribuição dos erros apresenta variâncias diferentes para por exemplo valores de x igual a x 1 e x = x2 genericamente eu posso dizer que a variância dos erros sigma 2 e será diferente para cada valor i dos regressores e a
quatro causas principais de heterocedasticidade a primeira ea natureza das variáveis pois algumas relações serão naturalmente heterocedastica por exemplo a relação entre renda familiar x e poupança y é natural esperar que famílias mais pobres tem uma variabilidade o menor dos valores poupados isso porque é uma restrição orçamentária se vera entre as famílias com baixa renda e os valores poupados seriam naturalmente baixos para todas as famílias pobres por outro lado entre as famílias ficas haveria uma maior variabilidade dos erros pois a restrição orçamentária é menos severa o ou seja entre a família cicas e eu poderia ter
aquelas que poupam muito abaixo do esperado quanto aquelas que poupam muito acima do esperado é a segunda causa é a existência de valores extremos na mostra por exemplo caso todas as famílias apresente valores cobrados muito próximos aos esperados para sua renda mas apenas uma família se sobressai em relação aos demais por exemplo com uma poupança muito inferior ao esperado nesse ponto da reta de regressão a variância dos erros seria superior à dos demais valores controlados da regra a uma literatura específica para o tratamento de valores extremos na mostra que não será tópico dessa aula é
a terceira causa é a falha na especificação do modelo por exemplo se relaciona popular poluição y com riqueza x e talvez a forma quadrática com x e x 2 seja mais apropriada aqui a forma linear com apenas a variável x isso porque a poluição poderia aumentar nos estágios iniciais o crescimento da renda até um determinado o ponto intermediário da renda quando então as pessoas passaram a se preocupar mais com a poluição e passaria a cair com o crescimento da renda se eu indevidamente ajustar uma função linear para essa relação os valores da poluição próximos ao
ponto intermediário da renda que é o ponto de inflexão da curva seriam muito superiores aos esperados pela função linear e o seu seriam consequentemente heterocedásticos de maneira análoga a causa anterior outro motivo principal de heterocedasticidade é a forma funcional inadequada de relacionamento entre as variáveis é seja novamente o caso da relação linear entre renda x e poupança y haveria aí pelo centro da cidade por exemplo caso a dispersão média dos erros seja de 10reais para famílias pobres em que a poupança esperada é de 100 reais ea dispersão média seja de 100 reais para a família
ficas em que a poupança esperada é de meu reais apesar de elas de expressões absoluta serem diferentes entre famílias pobres e ricas as expressões relativas ou seja em relação aos valores esperados são idênticas 10 e pedido por cento = 10 por cento de dispersão relativa dos erros para os pobres e sem / 1000 que é igual a 10 por cento de dispersão relativa para as famílias pobres família cicas e a transformação logarítmica transforma variações absoluta sem variações relativas e eu poderia simplesmente relacionar o log da poupança com o log da renda como resultado eu queria
os erros como variações relativas o valor esperado ao invés de variações absolutas o modelo linear moral da história a transformação logarítimica podem eliminar ou pelo menos atenuar a e ter o se da cidade à heterocedasticidade possuem duas consequências a primeira é a ineficiência do estimador beta chapéu dn que o seu em cima do olho dele aqui ó é ineficiente significa que a sua variância não é a menor possível entre os estimadores não tendenciosos de beto e lembrando que a variância do estimador é importante para realizar os testes de hipóteses se eu trabalho com em cima
dor ineficiente por exemplo eu posso deixar de comprovar uma relação que é significativa simplesmente porque estou utilizando o estimador errado e para compreender a o que significa variância do estimador seja a relação linear simples entre y e x a reta vermelha representa a relação para o valor esperado de y da população que é desconhecida na vida real suponha agora que o selecione uma amostra aleatória dessa população que eu chamarei de amostra número um em seguida eu utilizo e cima dor beta chapéu dele aqui ó para obter uma estimativa dessa relação essa estimativa é representada pela
reta tracejada laranja e utilizando os dados da mesma amostra número um eu poderia também utilizar um em cima dor diferente também não tendencioso eu chamarei esse simulador alternativo de beta chapéu asterisco a reta tracejada a roxa representa a estimativa obtida pelo beta chapéu asterisco é mas a estimativa depende da mostra suponha por exemplo que eu tivesse você deixou lá de uma mostra diferente que eu chamarei de amostra número dois a estimativa do estimador beta chapéu dele aqui ó para os dados dessa mostra número dois seria representada pela reta tracejada laranja e a estimativa do estimador
beta chapéu asterisco para a mesma amostra número dois seria representada pela reta reta tracejada roxa e esse exemplo hipotético eu chegarei à conclusão que as retas laranjas estimadas pelo estimador beta chapéu dna possui o intervalo de variação inferior as setas roxas estimadas pelo esse madura alternativo dessa chapéu asterisco e a curva tracejada laranja definir o intervalo onde provavelmente estariam as estimativas de michael e aí e a variância do estimador beta chapéu nada mais é do que uma proxy para elmire esse intervalo eu consigo demonstrar que caso os erros sejam como se dá secos o intervalo
de variação das retas obtidas pelo estimador de michael será o menor possível ou seja caso eu utilize o simulador beta chapéu asterisco a variância desse estimador será igual ou superior a variância do estimador de michael nunca inferior esse é o conceito de eficiência do estimador de michael que depende deus erros serem homocedasticos e por outro lado caso os erros sejam heterocedásticos eu consigo demonstrar o meu posto ou seja a variância do estimador beta chapéu de níquel não ser a menor possível existe um em cima do alternativo que eu preciso ainda descobrir qual é provisoriamente eu
estou denominando de beta chapéu asterisco que possui uma variância inferior ao destinador beta chapéu de michael outra consequência importante daí ter os e da cidade é que a variância do estimador beta chapéu de michael será tendenciosa mesmo para nossas grandes ou seja o estimador da variância de beta chapéu dna será inconsistentes como eu dependo da variância do estimador para calcular as estatísticas tf os testes de hipóteses para os coeficientes e para a contribuição do modelo da tabela nova também deixaram de ser válidos a moral da história aí trouxe da cidade causa além da ineficiência do
estimador beta chapéu a tendenciosidade do estimador de sua variância vamos analisar o caso de um modelo de regressão linear simples para compreender melhor o que que significa a tendenciosidade do estimador da variância de beta chapéu e os capítulos 1 e 2 do livro apresenta as equações para o estimador beta chapéu e de sua variância representada pelo s2 do beta chapéu e todavia eu consigo demonstrar que a equação para o s2 do beta chapéu só é válida caso a variância dos erros seja uma constante ou seja caso os erros sejam homocedasticos e nesse caso eu consigo
demonstrar que o valor esperado da equação para o s2 beta chapéu é exatamente igual a real variância do beta chapéu a paz caso a variância dos erros não sejam uma constante por exemplo seja dada por cima dois e com valor diferente para cada valor e da mostra eu demonstro que a variância do estimador beta chapéu seria dada por outra equação nesse caso eu não consigo demonstrar que o valor esperado do s2 do beta chapéu é o estimador da variância de mickey ó seja igual a real variância do beta chapéu de fato se nós compararmos as
equações elas são sensivelmente diferentes em alguns casos aí ter os e da cidade é identificada a teoricamente por exemplo quando eu relacionam poupança e renda das famílias haverá provavelmente e ter da cidade nos erros e passa se eu desconheço a existência de eu ter os e da cidade no modelo eu posso também analisar o comportamento dos resíduos de um ajuste dele aqui ó inferir sobre o comportamento heterocedastico homocedástico dos erros na população as estratégias mais utilizadas para identificar e ter os e da cidade são análise gráfica e os testes estatísticos em que a hipótese nula
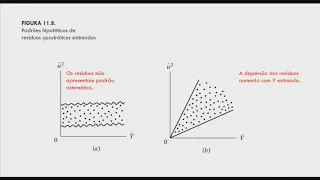
é a de homocedasticidade dos erros entre os testes estatísticos mais conhecidos estão o teste de wordfeud quality o teste de brush up on your chest and white o teste de white é o mais utilizado e eu que será abordado nesse vídeo usei mais espécies podem ser consultados no livro uma maneira simples para identificar a e ter os e da cidade e analisar a relação entre a variância dos erros e cada um dos regressores é uma prótese para variância dos erros é dada pelo valor dos resíduos ao quadrado cajus erros sejam homocedasticos eu espero que a
dispersão dos resíduos seja a mesma em todos os pontos da regressão ou seja os valores dos resíduos quadráticos serão mais ou menos constantes nessa ilustração por exemplo o comportamento homogêneo dos resíduos quadráticos sugere que a variância dos erros na população seja uma constante representada pelo sigma 2 caso os recursos sejam heterocedásticos eu espero que a dispersão dos resíduos seja diferente em cada ponto da regressão ou seja os resíduos quadráticos apresentaram algum padrão não homogêneo de comportamento em função dos valores de x e essa ilustração os resíduos quadráticos parecem crescer lentamente com os valores de x
ou seja a figura sugere que a variância dos erros representada por sigma 2 e teve uma função linear de x em qualquer padrão de relacionamento não homogêneo entre os resíduos quadráticos e os valores de x indica a existência de heterocedasticidade não apenas o seu padrão linear'' apresentado na figura anterior por exemplo a relação pode apresentar a formato de uma parábola indicando que a variância dos erros seja definida por uma função quadrática de x com as variáveis x e x ao quadrado a música sempre quadráticos podem ainda crescer despondency aumente com os valores de x indicando
que a variância dos erros seja definida por uma função logarítmica ou uma função com um componente quadrático de x 1 x 2 uma alimentação da análise gráfica é que fica difícil tirar alguma conclusão quando por exemplo eu tenho muitas variáveis independentes do modelo eu teria que analisar a relação para que os resíduos quadrados curso e cada uma das variáveis uma alternativa seria analisar a relação gráfica entre a expressão quadrática dos resíduos e os valores previstos de y que nada mais é do que uma função linear dos regressores é mas a solução usualmente adotada é aplicar
um teste estatístico para a hipótese nula de homocedacidade dos erros como será apresentado em seguida o teste duarte é o mais utilizado para testar a hipótese nula de que os erros do modelo são homocedasticos seja por exemplo o modelo de regressão para y como a função de dois secretores x 1 x 2 o primeiro passo da análise é ajustar o modelo porém que o e salvar os resíduos o caso haja interesse da cidade eu espero que os resíduos quadráticos que são uma medida da dispersão dos erros apresentem algum tipo de relacionamento com os regressores ou
seja eu posso relacionar os resíduos quadráticos conseguir essores em um modelo auxiliar de regressão e verificasse essa relação é significativa e como eu não sei qual é o tipo de relacionamento se é por exemplo uma relação quadrática ou linear eu ajusto o modelo dos resíduos quadráticos como uma função de todos os segredos flores e seus componentes quadráticos e interações entre esses regressores essa estratégia permite captar relações heterocedásticos que não sejam lineares relações quadráticas por exemplo o próximo passo é verificar se essa relação é significativa aí pode ser nula é a de que não há relação
entre a dispersão dos erros e os agressores ou seja o espero que todos os coeficientes do modelo auxiliar sejam iguais a zero essa hipótese nula de homocedacidade dos erros o caso relação seja significativa pelo menos um dos coeficientes do modelo auxiliar seria diferente de zero e essa é a hipótese alternativa de heterocedasticidade e eu poderia utilizar diferentes estatísticas para testar essas hipóteses a estatística proposta para o haiti é estatística l n que é um multiplicador de lagrange a estatistica eliene é dada pelo produto entre o tamanho da mostra ele e o coeficiente de determinação do
modelo auxiliar r2 essa estatística apresentará uma distribuição qui-quadrado com graus de liberdade dados pelo número de regressores do modelo auxiliar o nosso evento os graus de liberdade são iguais a 5 o valor pedro teste é a probabilidade de erro ao afirmar que os erros são heterocedásticos ou seja haverá indícios de heterocedasticidade caso o valor p seja suficientemente pequeno seja o exemplo 12.1 do livro eu tenho o dados e quarenta famílias para gastos com alimentação e renda familiar e eu vou assumir que os gastos com alimentação sejam definidos por uma e barreto é o primeiro passo
para identificar aí ter os e da cidade é salvar os resíduos de michael do modelo original em seguida eu posso analisar a dispersão dos erros em um gráfico relacionando os valores quadráticos os resíduos e o regressou renda familiar o gráfico sugere uma forma de relacionamento linear entre a variância dos erros e os valores da renda familiar ou seja essa análise gráfica preliminar sugere que os erros sejam e ter os pedaços eu utilizarei os mesmos dados do exemplo 12.1 do livro para testar a hipótese de homocedasticidade ou heterocedasticidade dos erros pelo teste do art é o
primeiro passo é salvar os resíduos do ajuste de make para a relação entre a área entre gastos com alimentação e renda e em seguida eu relaciono os valores quadrados dos resíduos com todos os segredos flores seus valores quadráticos e suas interações como eu tenho apenas um regressor não há interação e o modelo auxiliar auxiliar será dados simplesmente pelos resíduos quadráticos como uma função da renda e da renda elevada ao quadrado e eu então aplico início ao modelo auxiliar e eu me tenho coeficiente de determinação desse ajuste que é igual a 0,365 o próximo passo é
testar a hipótese nula de como se da cidade ou seja que não há relação entre a dispersão dos erros e eu segredo flores nesse caso eu esperaria que todos os coeficientes do modelo auxiliar sejam iguais a zero e aí só tinha ficado te slm será dada pelo produto entre o tamanho da mostra que é quarenta e oitocentos e determinação do ajuste auxiliar que é 0,365 a estimativa da estatística lm é 14,6 essa estatística faz parte de uma distribuição qui quadrado com dois graus de liberdade pois eu tenho dois secretores do modelo auxiliar e o valor
p associado a estatística lm é 0,0007 ou seja caso eu rejeitar h0 e afirma que os erros são retroceda secos estarei sujeito a uma chance de erro de apenas 0,07 por cento como é uma probabilidade de erro muito pequena a fortíssima as evidências para afirmar que os erros sejam e ter os pedaços e agora resolver aí o mesmo exemplo não é o primeiro passo é ler os dados da amostra de 40 famílias para gastos com alimentação a variável alimente e renda familiar a variável renda e como as operações algébricas começam a aumentar razoavelmente a partir
dessa aula eu passarei a partir de agora a utilizar a função fn do erre essa função faz as mesmas operações apresentadas nos capítulos 6 7 8 ou seja estima o coeficiente do modelo por n e calcula as estatísticas trf para analisar a significância do modelo eu salvarei os resultados dessa função em um objeto denominado mk1 posteriormente eu posso acessar as informações desse objeto para manipular os resultados do ajuste a função summary por exemplo apresenta os principais resultados do ajuste e após aplicar em michael no modelo original eu preciso salvar os resultados the new york e
utilizarei a função resgate e que posteriormente calcular ei os valores dos resíduos quadráticos e em seguida eu faço uma análise gráfica de dispersão dos valores dos resíduos quadráticos e renda tam e o gráfico sugere um comportamento heterocedastico em que a variância parece ser definida por uma função linear da renda e para encontrar evidências formais da existência de heterocedasticidade eu realizarei agora o tecido white o primeiro passo é ajustar o modelo para os resíduos quadráticos como uma função do regressor renda e de seu termo quadrático calculado na variável ainda dois eu salvarem os resultados desse ajuste
no objeto e michael 2 e aí sites klm será então dada pelo produto entre o tamanho da amostra e o coeficiente de determinação do ajuste auxiliar que está armazenado no objeto e miguel 2 e finalmente eu calculo a probabilidade de erro ao afirmar que os erros são e ter os pedaços e assumindo uma distribuição qui quadrado com dois graus de liberdade para estatística ll e o valor ter que nós obtemos é de 0,0007 ou seja 0,07 porcento de chance de erro ao afirmar que os erros são heterocedásticos e aí e aí e aí [Música] e
aí e aí