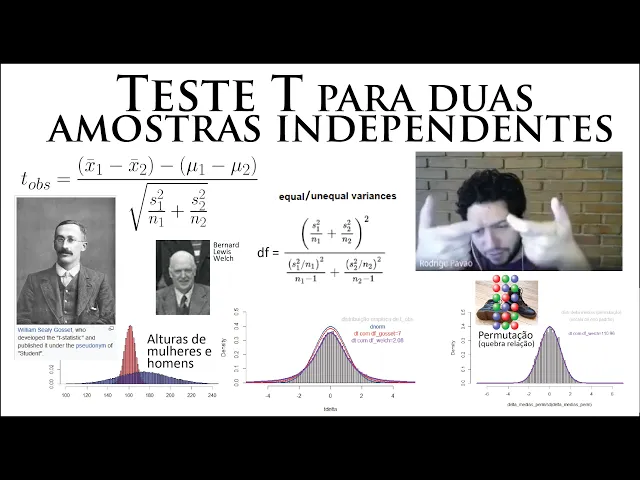
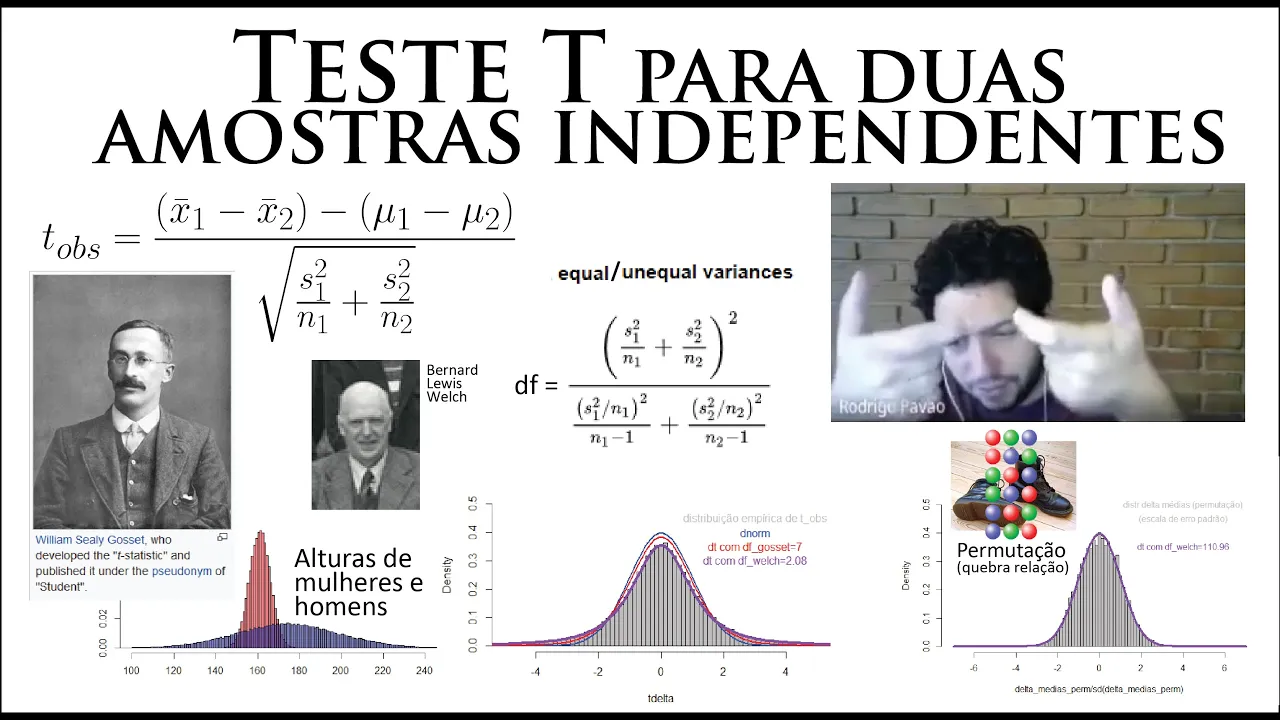
bom vamos começar imaginando que a gente tem duas populações tá uma população de mulheres e uma população de homens e o que a gente tá olhando aqui são as alturas dos homens e das mulheres as mulheres têm uma média de 1.61 com desvio padrão de 10 e os homens têm uma média de 1.74 com desvi o padrão de 10 também a gente já sabe aqui que tem uma diferença entre as médias certo é uma diferença de 13 cm ponto do tá já sabendo que a coisa é assim agora vamos olhar o que que a gente
esperaria por amostragens né se a gente fizesse uma amostra de três homens e uma amostra de três mulheres e fizesse a subtração entre essas médias e fizesse isso muitas muitas vezes a distribuição de probabilidades dessas diferenças seria essa seria centrada no 13.2 a diferença entre as alturas das populações e teria um desvio padrão aí né esse desvio o padrão no caso aqui é de 8.16 e onde raios vem esse 8.16 você consue computar isso a partir dos desvios padrões da Média individuais você faz uma média geométrica aqui e se você chega no desvio padrão da
diferença entre elas partindo desse pedaço você pode colocar os valores do erro padrão de cada uma dessas médias e simplificar para chegar aqui então a variância da primeira dividido pelo n da primeira variância da segunda dividido pelo n da segunda e você faz essa conta da exatamente 8.16 que você encontra empiricamente e isso é de novo o nosso teorema central do limite né só que que agora não aplicado para para uma para uma média de uma população agora você tá fazendo isso pra diferença entre a a média de duas populações tá de novo surgiu a
distribuição seguindo uma galciana e de novo o erro padrão dessa distribuição da diferença entre as médias vai seguir um um Sigma dividido por R de n né só que agora ajustado para essa nova realidade e se a gente faz isso com diferentes zes esse primeiro que a gente fez foi com N3 né que ele continua aqui o N3 então N3 + 3 com erro padrão 8.16 continua tudo aqui fazendo isso com NS maiores né então 30 homens e 30 mulheres ou 300 homens 300 mulheres o que você encontra são distribuições cada vez mais fininhas né
mais densas mais próximas da diferença entre as médias populacionais e sempre seguindo esse mesmo cálculo aqui né então que são os valores dados pela equação que bate muito pertinho do do que foi observado empiricamente agora a gente já sabe como é que é a distribuição da diferença entre as médias e agora a gente vai querer usar Aquelas mesmas ferramentas que a gente já tava usando para test T de uma amostra para conseguir fazer inferência olhando Uma amostra de homens uma amostra de mulheres e conseguir fazer uma inferência sobre a diferença entre elas e essa é
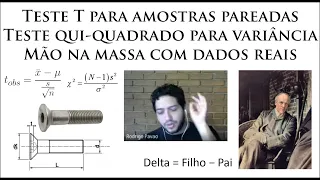
a equação a diferença entre as médias amostrais menos a diferença entre as médias populacionais dividido pelo desvio padrão da Média da diferença essa equação é muito parecida com essa né aqui que gente tinha visto na semana passada né aqui era a média de uma amostra menos a média da população que era pela nula né Por exemplo dividido pelo erro padrão tem o paralelo Claro ali né é a mesma coisa varia também o jeito de computar o o grau de liberdade dessa distribuição t esse grau de liberdade é o n - 1 de cada grupo né
n - 1 pro grupo 1 mais o n - 1 pro grupo 2 no final você cai com N1 + n2 - 2 tá esse é o é a carinha da coisa que a gente vai trabalhar hoje né então usando teste t para duas amostras Independentes Tá e é importante que seja independente né na aula passado que era para uma amostra que podia até fazer duas medidas do mesmo Ponto né daí seriam amostras variadas né E você trabalh com a diferença entre essas esses esses valores parados né Aqui tem que ser totalmente independente o o
n do grupo um pode ser diferente do n do grupo dois por exemplo porque eles nunca Têm alguma associação eles são sempre Independentes não se tratam do mesmo elemento aqui no nosso caso eram homens e mulheres aqui eu tô pegando mesmo no mesmo número 10 e 10 ou 3 e 3 e 30 e 30 300 e 300 mas eu poderia pegar números diferentes né eh a ideia de que eles são de fato Independentes essa ferramenta Só serve para esse tipo de caso Essa coisa é legal mas ela só funciona para quando existe igualdade de variância
entre a população um e a população Dois ou seja o sigma1 tem que ser igual ao sigma2 para essa equação Valente mas teve um outro cara esse welsh que Ele montou um outro jeito de calcular o grau de liberdade Bem mais complicado dá para ver né bem mais trabalhoso mas é um jeito que funciona para qualquer caso sendo igual ou não igual variância iguais ou diferentes muito mais geral você consegue trabalhar com qualquer variância e agora vamos olhar esse exemplo dos homens e das mulheres mas dentro da distribuição t tá então a gente pega de
novo Aquelas mesmas populações que a gente já tinha visto antes né 161 e 174 com desvio padrão 10 cada uma delas tá e a gente vai fazer agora amostras de tamanho três para homem e de seis para mulher para deixar bem claro que tem que que é independente mesmo e daí a gente faz aquela essa distribuição empírica do T observado para cada simulação de amostragem aqui eu vou pegar uma amostra de homens uma amostra de mulheres né Cada um com o seu tamanho tirar as médias das amostras se já faz esse pedaço da equação o
delta médias depois faz o delta dos mis isso aqui é para conseguir centrar no zero né tô colocando exatamente a diferença entre as duas médias né Então essa distribuição de TS no final vai ficar centrada no zero e também tá calculando o erro padrão usando essa equação zinha aqui raiz quadrada da variância da amostra dos homens dividido pelo número dos homens variancia da amostra das mulheres dividido pelo da mulher tudo isso é envelopado no raiz quadrada tá e depois Só constrói o t né o t dessa diferença né que é o que eu tô salvando
a cada vez que eu rodo aqui né então eu tô colocando Delta das do x Barra menos a Delta do Mi tudo isso dividido pelo erro padrão e é isso aqui que eu encontro tá então t delta centrado no zero com desvio padrão eh um e e e e com essa cara de de de galciana que não é galciana né Dá para ver que ela não é igual a uma galciana né enorme o que que acontece a galciana tem menos peso nas Caldas e ela chega mais alto se já não encaixa tão bem então não
é uma normal ela é parecida com a normal mas ela não é uma normal e vamos olhar aqui o grau de liberdade usando a formulinhas e variância e perfeito né a gente tá trabalhando aqui com igualdade de variância as duas TM o mesmo desio padrão Ou seja se a gente coloca aqui a equação dele uma distribuição T com grau de liberdade 7 né então a 9 - 2 7 você vê que encaixa bem bonitinho faz uma aderência muito boa pra distribuição empírica dos TS a gente pode olhar também como que daria pela equação do elch
né aquela complicad dona você vê que Dá Um Valor diferente né ó dá 4.09 dá valor quebrado né grau de liberdade com número quebrado e que tem uma aderência super boa também né ela tá um pouquinho diferente uma outra uma tem grau de liberdade quatro tem graus de liberdade s mas as duas aderem razoavelmente bem tá Então aqui estão só os jeitos que foram computados esses dois graus de liberdade o do goost somando os dois ns e subtraindo dois e o do wels trabalhando com as variâncias trabalhando com os NS e fazendo uma coisinha um
uma continha um pouco mais complicada mas é só aplicar que funciona muito bem Beleza tá claro até aqui Vamos seguir então vamos supor que agora a gente tem população de altura de homens e mulheres que T variancias muito diferentes O desvio padrão das mulheres é de cinco desv o padrão dos homens é 25 aqui a gente já não poderia usar o gset né então a gente faz o mesmo caminho e daí a gente chega na empírica né a distribuição normal não encaixa a galciana a distribuição T com grau de liberdade S também não encaixa você
vê que não aderiu bem né mas a do wels encaixa muito bem né CL Liberdade 2.08 Faz um ajuste muito bom para distribuição de T empírico tá e se a gente tenta fazer com uma distribuição maluca aqui toda torta né então que eu fiz aqui foi pegar a população das mulheres manter aquela a distribuição dos homens e das mulheres continua no mesmo com a mesma média né mantive sempre a mesma média e eu fiz elas terem desvio padrão diferente tá essa aqui eu fiz uma bimodal né 70% da população pra esquerda 30% da população pra
direita você já gerou esses dois morros né Tá então já gerei uma distribuição bimodal nas mulheres e pros homens eu fiz um as médias mais ou menos ficarem próximas né das duas distribuições mas uma eu fiz ela fic com uma cauda gigante né né então gerou ficou assimétrica colocando aqui o colocando o quadrado aqui né para só crescer para um lado e então gerei gerei duas distribuições bem bem malucas hein e vou tentar aplicar o mesmo ferramento você vê que não encaixa nada né olha só como é que virou a distribuição dos a distribuição eh
empírica dos teus observados né o n é pequeno né então não não aderiu a galciana nem nem nem nem de perto chegou em aderir a calciano né ela tá com um formato eh Super complexo os valores empíricos de T totalmente assimétrico também se tenta ajustar uma normal tenta ajustar um um uma T não importa o grau de liberdade nunca vai dar né não funciona ou seja isso daqui não funciona para fazer comparação entre médias quando as populações não seguem uma distribuição normal tá a a premissa não é essa a premissa para trabalhar com teste t
é que seja normal pode ser com igualdade de variância Ou não Aqui estão duas com desvio padrão diferente mas aqui funciona super bem o t né usando o grau de liberdade do jeito que o wels propôs tá então isso não funciona particularmente quando os seus os seus nes são baixos né que pelo teorema central do limite você ainda não conseguiu fazer aderir a uma coisa que parece com uma distribuição normal né E mesmo que não adere quando você quando você trabalha com a T até muito próxima da normal né então a gente sabe tratar muito
bem eh analiticamente né mas quando vai para mas quando a distribuição é muito louca assim daí não tem jeito mesmo aí você tem que usar os métodos que não tem essa premissa de normalidade né Mas enfim vamos trabalhar então com exemplos que a gente consegue trabalhar com essa ferramenta pacote de café os pacote de café tem que ter 1io kg né então aqui é uma empresa que vende pacotes de café de 55 kg e eles têm duas máquinas para empacotar o café tá e uma máquina um que ele conseguiram tirar uma amostra de 49 pacotes
tem média P 51 kg né um pouquinho acima de de de me5 Kg com uma variância de 0.009 k qu tá uma máquina do que fez uma amostra um pouquinho maior 64 tem uma média de p 499 bem pertinho de 1 Kg também e com uma variância um pouquinho maior aqui de p0016 kg qu e daí a pergunta você julga que essas máquinas geram pacotes de quantidade diferente uma máquina gera pacote de tamanho diferente da outra tá e vamos fazer esse teste e a gente vai usar o teste t de duas amostras usando o graus
de Liberdade como colocados pelo gos e pelo Wel Mas vamos usar o do gosset tá que é mais fácil é mais fácil fazer a conta aqui tá Depois a gente depois a gente Confere se isso aqui tá bem mas vamos vamos trabalhar com esse primeiro que é mais simples primeira coisa para fazer isso é seguir os passos né então os mesmos passos que a gente tinha visto antes vão continuar valendo aqui tá então passo um estruturar hipótese nula H z0 né então é que as duas médias são iguais ou que a a diferença das médias
é zero a mesma coisa né e eh a alternativa é que é diferente média um é diferente da Média 2 mi1 é diferente de mi2 sempre tem que colocar os parâmetros aqui né Sempre tem que colocar parâmetros populacionais is tá querendo fazer diferença sobre a população né então tem que colocar as hipóteses com parâmetros populacionais tá estruturar a distribuição regida pela hipótese nula Então tá colocando aqui uma distribuição já em t é o jeito que se trabalha habitualmente média zero des padrão um e agora a gente vai colocar o nosso Alfa de 5% e a
gente vai definir as áreas de aceita e rejeita que são passo quatro né aqui nosso n é 113 né que a gente tem aqui na tabela é 60 e 120 então pegar um valor pré perto aqui mais perto do 120 né ou pega exato né usando a função qt no no R tá no 111 e colocamos lá 1.98 então ess aqui vão ser as nossas áreas de rejeição e área de aceitação da hipótese nula tá e vamos usar agora o nosso jeito de computar o nosso T né para fazer o teste de significância que é
fazer ver onde caiu o nosso T observado Então pegamos a diferença entre as médias experimentais tá a diferença entre as médias eh eh populacionais regida pela hipótese nla que seria seria o zero né e dividido pelo padrão 510 Men o 499 eh menos o zer dividido pelo padrão que é a variância a as vari que já são computadas divido pelos n respectivos tá então esse aqui é o nosso T observado E chegamos lá no 1.67 que caiu dentro da área de aceitação da hipótese nula tá então a gente faria um julgamento aqui de que as
médias não são diferentes e aceitamos a hipótese nula e daí para calcular o p valor é um pouquinho mais chato né mas é só procurar a área que tem entre o t observado até valores mais extremos só que aqui como a gente tá trabalhando com uma uma não direcional né tem que multiplicar essa áre Zinha por por dois né porque ela estaria em dois lugares aqui na esquerda e na direita e você tem o p valor aqui é só o primeiro passo né do 1 p 67 que deu p95 mas se você tá querendo pegar
dos dois lados tem que multiplicar por dois né tem que inverter para pegar o complementar você seja deu quase 10% né nosso P valor deu P 097 quase quase 10% e a gente pode fazer isso aí de outra forma né isso aqui então isso aqui seria o jeito na mão passando passo a passo né Dá para ver que é muito similar com o que que a gente já fez antes para teste t de uma amostra n agora para duas só mudar a formulazioni normal na escala né então obrigando ela a ficar com média zero padrão
Ou seja fica muito fácil de dar uma média que a gente quer e desir o padrão que a gente quer tem que ver se isso aí passou na normalidade a gente já fez vindo da normalidade né mas isso aqui é não se trabalha assim né você tem acesso aos dados da máquina um e o acesso da máquina dois teria um vetor ali de dado de verdade né então você teria que testar para saber se aquilo lá veio de uma distribuição normal né então Eh aqui a gente está vendo que veio né então Eh os valores
de W estão sempre muito pertos de um né então que que é o que que é o que indica a normalidade também com B valor acima do 5% passou no no teste de normalidade então está liberado para trabalhar com teste t né então coloca lá teste t t test da máquina um da máquina dois o mid da diferença que é zero né e bicaudal né então ele vai rodar um teste t do tipo do ELS né o r já usa por padrão o intervalo de confiança computado pelo ELS então você vê que deu um número
quebrado aqui né não deu 111 que tinha visto lá 111 mas ele fez na ele fez na na na formulinhas 111 tá Dá um pouquinho diferente mas você vê que eles eles ficam muito próximos né quando você tem um n maior um n grande e e e as distribuições são de fato com variâncias próximas você vê que o grau de liberdade se aproxima muito do do que o gosta de fala e o que o wels fala tá então tem o t que a gente computou que é igual que a gente tinha computado o grau de
liberdade do welsh e o p valor que deu quase os 10% de novo que ele só tá falando o que que ele fez né então ó a gente fez com uma hipótese alternativa que a diferença entre as médias não é igual a zero quando vocês colocaram Aqui mi zero e alternativa two sided B caudal você tá definindo uma hipótese Alternativa de que as diferenças verdadeiras a diferença entre as populações não é igual a zero né Essa é essa é a alternativa que você definiu e daí ele dá um intervalo de confiança também intervalo de 95%
da diferença entre as médias a gente tem uma diferença entre as médias que é algo como ponto 011 e ele tá falando ó Qual que é o intervalo de confi confiança desse ponto 011 que usa uma equação muito muito próxima dessa daqui daria pra gente revisar isso aqui se vocês tiverem e mas dá para chegar nesse intervalo de confiança facinho também e dá os valores de média do X e do y o t obtido foi de 1.67 a região de aceitação era de 1.98 até 1.98 ele não está na região de aceitação está na área
de aceitação ele tá na área de aceitação menos 1.98 mais 1.98 1.67 está exatamente dentro dessa área de aceitação não a h0 não é h0 não é de que são diferentes h0 é de que são iguais a gente aceitou h0 de que elas são iguais tá a nula que tem a parte de desigualdade sempre né a gente aceitou a hipótese nula ele caiu dentro da área de aceitação da hipótese nula então aqui a gente faria só comparando com o p valor né então você quando você pega você tem esse P valor você tem que comparar
isso com um Alfa né então se seu P valor deu maior do que o seu Alfa você aceitou a sua hipótese nula você diria que as máquinas estão fazendo Endo pacotes com o mesmo tamanho né com a mesma massa e mas eu poderia fazer isso também pelo Bootstrap Porque agora não é mais Bootstrap agora a gente vai fazer o da permutação que não tem reposição e para fazer esse procedimento é muito simples é muito parecido com o outro o primeiro passo é transformar tudo num vetor tá então você pega suas medidas todas que você tinha
da máquina um e a máquina dois que tava ali né a gente tinha construído os vetores da máquina um máquina dois as medidas da máquina um máquina 2is no slide anterior tendo esses vetores você tem que construir um vetor só cria um vetor só com Tod todas as medidas da máquina um todas as medidas da máquina dois quando você coloca tudo num vetor só você perdeu Esse identificador você tem que fazer um vetor de identificadores você fala ó meus grupos são um nos primeiros elementos e dois no segundo nos últimos elementos tá então o tem
o mesmo número de uns aqui que tinha de medidas no vetor de máquina um né repete o um o número de vezes o 49 no caso aqui vai dar né e o e o Repete o do o 64 vezes a gente criou um um um um vetor de medida e um vetor que identifica quais são os grupos os grupos Associados A aquelas medidas ou seja agora você consegue calcular o delta dessa forma aqui primeiro me fala Quais são as medidas do grupo um e tira a média das medidas do grupo um tá menos a média
das medidas do grupo 2 e Chegamos no nosso ponto 011 né que é a diferença entre as médias aqui ol é só um outro jeito de representar esse que facilita muito fazer Bootstrap Bootstrap não permutação então vamos lá vamos fazer Nossa permutação no final vamos gerar uma distribuição dos Delta médios ao acaso tá como que a gente vai fazer isso primiro definir um vetor né onde a gente vai salvar essas nossas Delta médias geradas por permutação e depois vou rodar um loop aqui em cada vez eu faço uma permutação fazer 10.000 permutações para cada permutação
Eu queria um vetor grupo embaralhado um vetor grupo eh permutado para fazer isso eu faço o quê com aquela função sample de amostragem do vetor de grupos com o mesmo tamanho do do vetor de grupos sem reposição ou seja só vou embaralhar eu não vou fazer nada aqui né esse o replace aqui é false é diferente daquele do replace igual tru que a gente usava no Bootstrap né que era pegando que a gente podia pegar duas vezes o mesmo elemento né ou ou não pegar elemento não aparecia que era com reposição a gente fazia um
vetor com reposição do mesmo tamanho aqu está fazendo um vetor sem reposição também do mesmo tamanho tá então a gente só embaralhou os uns e dois aqui eles estavam todos certinhos um um um do do 2 2 2 2 2 né E aqui virou tudo embaralhado tá e v Mas vai ter a mesma quantidade de uns a mesma quantidade de dois que antes e depois disso a gente faz essa Delta Média permutado a gente tinha feito Delta média normal pegando a média do um e a média do dois agora a gente vai falar ó tira
a média Mas fala que os GR só pegando dos grupos que estão permutados igual um menos a média dos grupos que estão permutados no valor dois resultado a gente gerou aqui então um uma distribuição que é esse Delta média permutado e é a própria distribuição regida pela hipótese nula é a diferença entre as médias guiada pela hipótese nula tá então você só fala Olha quando que nessa minha distribuição regida pela nula deu maior do que o que eu observei de fato que o meu 0.011 ele vai te dar uma porcentagem ali né se você faz
uma média desse TR F que só multiplica por dois e chega no P valor e deu de novo os 10% funciona bonitinho E tá lá a nossa distribuição a distribuição das Diferenças guiadas pela hipótese nula obtidas por permutação tá então essa aqui é a distribuição dos Delta médias gerad por permutação esse vetor aqui ó aqui são os valores que ele pode assumir né centrado no zero sempre né agora você compara essa distribuição com a diferença entre as médias de Fato né que foi o pon 011 e ele tá aqui então o seu P valor vai
ser esse pedaço aqui vezes 2 né para pegar o outro lado também eles são bem simetrico minhos né multiplicar por dois para chegar no P valor foi que a gente tinha feito aqui mas você fala Putz cara que gambiarra isso aí será que isso aí dá dá igual isso aí não era para usar o ttest não veio dou uma distribuição normal Será que deu certo será que funciona então vou pegar essa mesma distribuição das médias permutadas e vou botar na escala de erro padrão Ou seja eu só peguei as médias permutadas e dividi pelo desvio
padrão delas isso aqui virou uma distribuição T agora só que gerada por permutação e o seu DT com ELS de 110.90 e tá igual encaixa faz uma aderência perfeita ou seja por permutação você gera uma distribuição regida pela nula que bate muito bem com o que o que seria esperado pela teoria pelo método analítico então você vê que aqui encaixa direitinho o valor da diferença entre as médias agora eh normalizada pelo erro padrão que cai direitinho também na distribuição que seria esperada pela t tá então encaixou direitinho uma distribuição na outra tá mostrando o que
funciona com o ganho de que quando você trabalha com as distribuições permutadas você não fica mudando de escala você joga pro você sai do dado bruto Ah tem que escalar pro pro pro erro padrão Aí pega o t observado a tem que construir o t observado Então você botar tua média lá e dividir pelo padrão aqui você trabalha só com uma escala e é um procedimento muito mais simples né que é só pegar sua sua distribuição de diferença de médias né então aqui é a diferença de entre médias esperada pelo Acaso para esse n uma
distribuição que tem essas estatísticas ela tem essa cara tá e o que você observou ela tá caindo na meiuca dessa distribuição tá caindo na meiuca ou seja eh aceita hipótese nula né Fala Poxa foi pelo Acaso e esse é o procedimento mas isso aqui é um caso que a gente não precisava ter usado isso né a gente não precisava ter usado isso a gente tem que usar esse tipo de de método quando você tem uma distribuição populacional Toda torta vamos pegar um um exemplo dessa daqui tá então vou partir dessa de uma dessa população que
foi colocada aqui e eu vou tirar uma amostra de cada um vou tirar uma amostra de 70 homens e 40 mulheres tá só peguei dessa distribuição aqui fiz um sample e coletei 40 40 mulheres e 70 homens e tá aqui o plot das medidas dos Homens o plot das medidas das mulheres com o delta de 12. 15 quanto que era normal de verdade era era um pouquinho mais era 3.2 né mas essa amostra de homens versus essa amostra de mulheres deu o 12.15 Então esse aqui era o primeiro passo né olhar os seus dados né
quando você tem os seus dados Esses são seus dados de verdade você fala Putz Olha só como é que ele tá aqui não precisa nem rodar o chapiro Wilk né você fala cara tá muito desigual né né Aqui não tem ponto aqui tem um monte de ponto vocês tem uma calda longa tá mal aqui também tá tá acumulado desse lado depois desse lado tem menos né ou seja não vai não vai não vai passar no chapiro Wi você já sabe que você tem que usar um método que não tem essa premissa de normalidade Tá então
vamos trabalhar com permutação e aqui eu fiz uma primeira permutação eu coloquei todos esses pontinhos no mesmo pacote e depois eu tirei 70 desses pontinhos que eu atribuí pro grupo homem e e 40 desses pontinhos que eu atribuí pro grupo mulher ou seja eh eu eu quebrei a associação entre as medidas e os grupos certo eu coloquei aqui o acaso os pontinhos de um lado ou do outro tá é esperado quando coloca o acaso que o delta fique próximo de zero tá tô quebrando essa Associação Espero que a diferença entre as médias seja centrada em
zero né vai ter uma uma incerteza ali mas vai ser centrada no zero tá Fiz uma primeira permutação aqui que deu essa diferença essa diferença que eu vou salvar numa segunda permutação faço a mesma coisa aqui e eu continuo tendo sempre mais pontos pro homem mesmo que seja permutado pro grupo de homens permutados eh e e em relação a das mulheres né então sempre tem mais ponto desse lado aqui mas aqui a diferença deu pro outro lado né então o grupo das mulheres ficou com uma média mais alta e faço isso lá minhas 10.000 vezes
cada vez que eu faço isso eu tenho uma diferença entre as médias dessa permutação dessa diferença entre as médias permutadas fiz isso várias vezes tem a minha distribuição centrada no zero com a minha incerteza ali né você vê que gerou uma coisa que já tá quase uma normal né os nes são gigantes né ou seja ficou parecido mais com uma distribuição galciana Mas você vê que não encaixa ainda né então peguei essa mesma Distribuição e tentei ajustar pela distribuição T você vê que não adere naquele pedaço ali né ele ele quase encaixa mas tá tá
você vê que até que não seria uma uma rodar um teste t aqui não seria tão ruim né como você tem um n gigante pelo teorema central do limite você consegue usar os testes que consideram que os dados seguem uma galciana ali né porque nosso n aqui é muito grande né 110 né aqui é a nossa diferença de fato 12.15 Ou seja caiu fora da minha distribuição nula ou seja eu já rejeitaria a hipótese que as médias seriam iguais né dá para ver graficamente né Dá para ver que as médias não eram iguais mas eh
fazendo esse teste aqui você fala firmemente olha eu fiz um 10.000 permutações e Nenhuma vez deu maior do que o outra meu P valor aqui deu zero Meu p valor permutado deu zero Então você rejeitaria sua hipótese nula se eu fizesse um welch da amostra dos homens com a amostra das mulheres né para essa daria um p valor baixinho eu chegaria na mesma conclusão né mas eu só conseguiria ver se deu certo ou não depois de fazer distribuição permutado falar Putz daria para ter ajustado uma distribuição T né ou seja usa a permutação Eu acho
esse método aqui é muito mais razoável principalmente depois que você vê você olha só como é que tá sua dispersão dos dados você vê que que você não segue as suas premissas De forma alguma é teste de permutação na cer para comparar duas médias então para fazer comparação de média de duas amostras Independentes a gente pode usar o teste t de duas amostras né que tem essa premissa de que a distribuição é normal né Isso é fundamental quando o n não é gigantesco né quando o n quando é gigantesco você pode eh meio que dar
uma aliviada nessa premissa Mas essa é a premissa do teste só vai funcionar perfeitamente quando suas populações seguem distribuição normal e você enxerga isso na sua amostra né Ele é um dado sempre escalado né Sempre jogado na escala de erro padrão e o erro padrão no caso é dado pelo teorema central do limite né é o Sigma dividido por ra do n Ou seja é aqui a raiz quadrada para trabalhar com com diferença entre as médias Então seria raiz quadrada do da variância do grupo 1 dividido pelo N1 mais a variância do grupo dois dividido
pelo n2 né então o erro padrão que segue o teorema central do limite então isso aí que você tem que dividir suas diferenças entre as médias pelo erro padrão né e e assim como a diferença entre as médias das amostras pelo erro padrão então sempre tem que trabalhar com esse dado escalado né usar a escala T né usar escala de erro padrão e a distribuição das médias na escala de erro padrão é aproximada pela função densidade T né então que é uma uma coisa que chega perto da normal eh mas se se o n for
baixo você tem que ter um tem que tomar cuidado lá e colocar um grau de liberdade adequado porque ele vai ter as caudas mais densas né Isso aqui é tudo para construir a distribuição da regida pela hipótese nula e depois você compara o seu essa distribuição regida pela hipótese nulo com a diferença escalada das médias das amostras esse aqui é o caminho todo para fazer o teste t e por permutação aqui é um um teste que não tem essa premissa de normalidade se a gente não depende dos parâmetros da distribuição das médias amostrais ou ou
os parâmetros da distribuição da diferença das médias amostrais você não tenta fazer ajustes por média e desvio o padrão ele é um teste não paramétrico não tá usando esses parâmetros para conseguir fazer as contas tá não tem essa premissa de normalidade uma coisa muito boa e o identificador dos grupos é atribuído aleatoriamente as medidas dos elementos amostrais você se embaralhou ali o seu o seu índice dos grupos e Manteve a mesma Você pode você só tem que quebrar a relação você pode embaralhar um embaralhar o outro embaralhar os dois dá na mesmo você só tem
que quebrar a associação ent os índices e as medidas né então você tem que atribuir e as suas medidas aos grupos aleatoriamente mantendo o tamanho amostrais né isso é importante para conseguir eh eh se manter preservar algumas estatísticas que são importantes ali tem que preservar o n se não quebra o se não quebra o o o nossa estimação do erro padrão né no fundo não funciona o teorema Central limite tá e você gera a distribuição das diferenças entre as médias regida pelo h0 a partir dos elementos da amostra você não precisa de mais nada além
disso você não precisa de tabela você não precisa não precisa de de de jeito de calcular o teorema central do limite você pode eh e ignorar todos esses aspectos aqui que a gente ficou falando tanto nessa disciplina F Ah só vou quero construir a distribuição regida pela nula colocando ao acaso ali você faz a simulação do acaso como que é né e depois você compara então a sua distribuição regida pela nula gerada pela permutação com a diferença das médias das amostras né então você não precisa nenhum momento mudar de escala você só faz a comparação
eh direta por permutado com o que você de fato encontrou de diferen vamos dar uma olhadinha no R como como foram feitos esses caminhos todos aqui tá Isso aqui é uma coisa que eu aprendi ontem se você coloca quatro joguinho da velha aqui você consegue você cria um índice e e daí fica fácil de Navegar você consegue pular de de lugar onde tem quatro quadradinhos para quatro eles aparecem nessa lista vamos lá pro início aqui era para fazer aquela simulação de diferença entre as médias das populações a população de homens e de mulheres com médias
diferentes mas desvio padrão igual depois a gente faz Só os histogramas da da das mulheres e dos homens né histograma no mesmo gráfico o histograma das mulheres centrado no 161 com desvio padrão 10 e o outro dos homens que ele só fala para ele adicionar no mesmo no mesmo gráfico Então temos ali os dois histogramas depois fazer as distribuições das diferenças das médias de amostras de tamanho Diferentes né três homens três mulheres 30 homens 30 mulheres 300 homens 300 mulheres só cria os vetores e faz as 10.000 amostragens amostrou dos homens três amostrou das mulheres
três salvou a diferença das médias nesse vetor Delta média amra 3 e faz isso para todos os casos com 30 e com 300 cada um deles é um montão de ponto né Cada Um Com Seus 10 os 10.000 pontos né então três vetores imensos vamos olhar só a diferença entre as médias das populações o 13.2 e o que e onde que tá centrada aquela distribuição das médias amostrais tá tá tudo mais ou menos no mesmo lugar né tr 13.1 2 é é o real 13.11 13.21 13.20 né D tudo muito próximo da diferença entre as
médias ou seja tá curado né a medida e depois só olha aqui tá olhando também o quê os desvios empíricos pegando o desvio padrão da distribuição das Delta médias de amostra de tamanho três com o que o que é esperado pelo teorema central do limite que é a a raiz da variância dividido pelo n variância ra do n né então só para comparar e ver o que que deu né então o empírico deu 8.09 e o que seria esperado pelo teorema dado do limite deu 8.16 né se já tá muito perto né aqui com uma
amostra maior também deu muito perto a morta maior ainda também deu muito perto tá então tá funcionando essas distribuições geradas empiricamente por por por amostragem bate exatamente com que seria esperado pela teoria pelo teorema central do limite aí agora a gente vai fazer o histograma dessas médias tá então esse aqui é o histograma do de amostra 3 eu fiz ele ser preto né RGB 00 00 com uma transparência de 50% então ele fica esse cinzinha aqui só colocando desvio padrão que foi dessa amostra e colocando ali aquele título né que falava qual que era o
erro padrão esperado pelo teorema centrado do limite tá só para mostrar aqui de novo deu a mesma coisa aí fazemos de mostra mais um pouquinho maior aqui eu fiz um RGB 0 me0 ou seja fiz ele ficar verde né ele tem zero de vermelho ponto c de verde e zero de azul né o RGB então ele ficou verde né e fiz ele ficar meio transparente de novo né então você consegue ver a distribuição de baixo e e coloca o título fez o outro histograma fiz T vermelho e t azul né então ele virou roxo né
Fiz ele ficar semitransparente fica mais Rosinha né e e escreve o texto lá então só esse esse foi o caminho para fazer aquela figura beleza então isso aqui era a primeira parte né só de fazer a mostragem das diferenças entre as médias das duas populações e depois aquele outro de em que a gente fazer a distribuição do T apagar tudo limpar e vamos olhar a diferença entre as médias duas populações aqui a gente pode trabalhar ainda com essa distribuição as duas com a mesma variância né faz os histogramas vamos fazer amostra de três e de
seis três homens e seis mulheres a gente vai produzir os TS né os TS observados empíricos T da diferença né empírico então salvou um t delta rodou as 10.000 vezes para cada vez que o rodou tira uma amostra de homens da população de homens com n de homens e tira uma amostra da população de mulheres com n de mulheres né esse trê 16 se faz a diferença entre as médias dessas amostras então o delta x bar o delta médias populacionais a gente só pegou os valores que estão na população só para ficar centrado no zero
e calculo er o padrão que é a variância de uma amostra dividido pelo n da da o n daquela amostra mais o variância da outra amostra dividido pelo n da outra amostra e tira a raiz de tudo esse é o o padrão e o t delta que é fazer a diferença entre as médias e dividir pelo erro padrão porque deixar no forno não precisaria pode botar fora pode crer podemos colocar aqui podemos botar aqui não dá problema não e roda essa parada toda chegando no no t delta pegando a diferença entre as médias amostrais a
diferença das médias populacionais dividido pelo erro padrão E rodamos A Paradinha aí e faz o histograma eu quero fazer com que o meu histograma ele vá de -7 a 7 e tenha 100 100 espacinhos né Então esse é o meu XV e aqui é o meu Range né esse Range você vê que ele vai de -10 A 5 se eu tento rodar desse jeito do jeito que tá aqui e eu tento gerar meu histograma ele fala P tá mal na minha série de dados do meu t delta tem valores que não estão dentro desse Range
de -7 a 7 que eu tô querendo colocar no meu histograma e daí o que eu faço é só Ah meu arranca esses números aí é só um pouquinho número coloca na né substitui por coisas que não são números né not a Number né aí agora eu faço o meu Range meu Range agora ele vai ficar de menos 7 a 7 Tá não ele C de de n na mas é V se eu tirar um fazer um Range excluindo os nas os nota numbers né ele ele ele ele ficaria só de s s a s
daí eu consigo fazer meu histograma numa boa mas enfim esse é só o detalhe A tá começando a fazer mais mais e mais coisa no R então eu quero mostrar um pouquinho das manhas aqui para não ficar travado nesses tipo de erro aí só calculando o grau de liberdade do gosset tá isso aqui é uma outra coisinha que tem no R que você coloca a sua o seu valor Entre Paredes porque se eu rodasse só esse pedaço ele faz a conta mas ele ele não me mostra mas se eu quiser que ele me mostre eu
só tenho que botar os parêntese zinhos e quando ele roda desse jeito ele já me me fala que valor que deu outra manhazinha do e e o elch com cuto welch daí deu um pouquinho menor né deu 4.09 e vamos lá vamos fazer os histogramas dos TS observados né e agora a gente faz o d norme só usei o d norme para aqueles mes pros mesmos valores de x tá lá em azul e agora fazer o gosset né então o DT distribuição T densidade do T para aqueles valores de x pro grau de liberdade definido
pelo gos e tô falando para ele fazer isso em vermelho né Então tá ali a linhazinha do gos e agora por último a linhazinha da distribuição de densidade do T feita pelo ELS e construir a distribuição T do elch em roxo um pouco mais linha mais grossa e é isso e tá lá a nossa distribuição T estão mostrando aqui a nossa distribuição T encaixa muito bem tanto a do Goss quanto a do ELS aproximam muito bem o dado e quando vem de uma distribuição normal com igualdade de variância mas se eu fizer aqui se eu
comentar esse pedaço e descomentar esse né E fizer a conta toda agora para essa essa outra população não vão ter igualdade de variancia né Eu repito o código todo ele vai mostrar que só só do gos que vai funcionar a eu posso fazer isso aqui também ó Zoom Eu só clico aqui ele já aparece bonitão só do gos que funcionou bem tá E e se eu colocar aquela distribuição malucona lá né aquela distribuição malucona aí não vai nada né não é nem normal nem nem simétrica nada não segue não não definitivamente as distribuições originais não
são não as distribuições populacionais não são normais e vamos rodar agora pro computar os tês observados e né E daí a gente tem a nossa distribuição empírica que não adere a nenhuma desses ajustes né aqui a gente teria que usar a nossa permutação beleza vamos agora que aquele o outro é aquele exemplo de exemplo do café né Tá então uma máquina um fez tantos pacotes com com tal massa tal variância as as máquinas geraram um pacote com com quantidade diferente para fazer pela função Nativa tem que tem que ter isso mas só que antes de
ficar fazendo se você tem seus dados olha os seus dados olha os seus dados daí uma estratégia muito boa é usar aquela usar aquela coisa de botar tudo num vetor só você coloca suas medidas num vetor só e os seus grupos como como identificador de grupo e daí você faz o seu plot das dos grupos pelas medidas e pronto e daí você já gera o seu gráfico aqui então você tem o gráfico da máquina um o gráfico da máquina dois você já consegue fazer a análise gráfica deles né já testou aqui ó olha segue mais
ou menos a distribuição normal segue mais ou menos a distribuição normal tá mais denso no meio e com as Caldas mais ou menos do mesmo tamanho você já tá fazendo esse teste aqui o chapiro teste visualmente da máquina máquina dois aqui já você já tá olhando se suas amostras seguem distribuição normal no dia a dia eu faço visual mas na hora que eu tô para fechar para colocar nos artigos o que eu faço é é é daí rodar todos os testes porque ninguém confia no olho de ninguém né você tem que falar olha eu fiz
isso aqui usando o teste e tal e apareceu isso e depois finalmente você consegue já rodar o seu ttest um ttest da máquina um com a máquina dois com diferença entre as médias zero e a alternativa bicaudal ele rodou lá o ELS né tem o c t esse grau de liberdade o CP enfim todo esse caminho que a gente tinha visto e daria para fazer na mão também né Pega um t observado dado pela diferença entre as médias aqui eu não coloquei o menos zer porque não precisa né e dividi pelo erro padrão tá então
consegui chegar no T aí o grau de liberdade do gosset e o p valor do gosset e fizesse pelo welsh daria mais ou menos a mesma coisa as variâncias são muito próximas né 0.09 00 16 é bem próximo na verdade pode testar isso a gente vai ver isso na próxima aula como faz para testar se as variâncias são parecidas ou não mas fazendo por um método ou pelo outro dá um p valor muito próximo e dá para fazer por permutação também que era o que a gente tinha falado lá qual que é o delta média
a gente tem lá os grupos os grupos né que é monto de um monto de dois a gente tá falando quando que o grupo dá um dá um dá tru no início né ele dá tudo true no início e depois ele dá tudo false Então você consegue olhar as medidas de quando dá true tá são meas 49 medidas de quando deu true e tiro a média disso aí tá deu pon 51 mesma coisa pro grupo dois então vai dar um monte de falso depois um monte de True e monte de false depois o monte de
True faz sentido vai dar minhas 64 medidas aqui a 64 medidas e tiro a média posso tirar a média dos dois né e Posso salvar isso no meu dat média só que daí eu não vejo né mas se eu botar o parênteses em volta aí eu vejo deu ponto 011 Daí vamos fazer a permutação de fato eu quero salvar as médias permutadas então vou fazer pra primeira permutação P = 1 né tenho lá meus grupos e meu tamanho dos grupos quero embaralhar esse treco então embaralhou sim então vai ter um e dois em posições aleatórias
aqui e vai ter mais dois do que um né porque tinha 64 na máquina 2 49 na um Qual que é a soma Ah não salvei Isso numa variável né então ten que rodar aqui roda de novo esse pedaço a som Qual que é a soma do grupo permutado igual a 1 dá 49 Qual que é a soma do grupo permutado igual a 2 64 só para mostrar aqui que eu ainda continuo com o mesmo número né o mesmo que tinha no grupo original meu vetor de grupo igual a 1 49 meu vetor de grupo
igual a 2 6 quando eu faço uma permutação eu só embaralho mesmo né Não eu não coloquei tamanhos eh diferentes pros grupos a e daí depois que fez isso tira a média né temos aqui quando que deu um né então vai ter true e false embaralhado Essas são as medidas e tira a média dessas medidas e a mesma coisa pro grupo dois tira mais essas medidas subtrai uma da outra a gente espera um número próximo de zero né a esperança Nossa É zero né porque é tá embaralhado e mas enfim roda isso aqui monta um
de vezes você tem lá um montão de valor de diferença de média gerada por permutação e agora você pega e compara com a sua diferença de média de fato e aqui a gente encontrou em 5% um pouquinho mais de 5% e o nosso P valor no caso Então é só multiplicar isso por dois né e salvou lá o p valor da permutação 11% daí a gente pode agora comparar isso aqui com a distribuição T né vou fazer aqui o meu XV de -7 a 7 ten aqui meu histograma de valores permutados Qual que é o
Range que ele pega Range que ele pega é de -02 a 02 Ah então não tem nem que me preocupar né então posso deixar meu XV de -7 a 7 faço o meu histograma do das Diferenças de média permutado aqui Eu só coloquei Um textinho né ó essa aqui são minhas diferenças de média gerada na permutação vou fazer o que aqui ah faço uma linhazinha né Onde está a minha meu Delta média mesmo né só fiz uma linhazinha vermelha com o x que vai ser o delta médio Delta médio 011 011 no x né 011
aqui e um 011 aqui e o y é 0 e70 consegui construir essa linha uma em cima da outra aí virou a figura que eu botei nos slides lá por último o que que era pegar as medidas permutadas e dividir pelo desvio padrão delas ou seja eu tô normalizando e jogando tudo PR escala T Então volta Essa parada é a mesma distribuição só que agora ela tá escalada para T distribuição do média da permutação na escala de erro padrão tá E eu ajusto aqui uma uma distribuição t para esses mesmos os valores de x com
o grau de liberdade dado pelo elch e deu bem bonitinho de novo e coloquei lá de novo T observado né que é a mesma coisa que o delta x bar um na escala o delx bar na escala normal e o t observado na escala de erro padrão matou mais uma e aqui Aquele caso em que a permutação era obrigatória né toda aquela bagunça né fazia bimodal botava um pedaço da distribuição para um lado um pedaço pro outro não sei aqui mas a gente nem vai olhar isso aqui né Vamos lá tirar uma amostra tira 70
homens e 40 mulheres bom Essas são as medidas e os grupos então tem 701 e 402 tá Então essas são as medidas de altura e os grupos um monte de homem e depois só 40 mulheres 110 elementos no total e a diferença entre as médias que deu 15 tá nesse caso aqui deu 15 um pouquinho diferente daquela que eu coloquei no slide mas aleatório né aí como é que eu faço aqueles gráficos né primeiro eu poderia fazer um passo anterior né plot dos grupos medidas Esse é o mais feio possível né só que daí o
gráfico fica muito feio né então o que que eu faço eu falo ó dá um X lin que ele começa no zero e termina no três dá uma ajeitada o gráfico um pouquinho mais bonitinho né e depois eu falo Putz eu não quero um e dois agora eu tô trabalhando com homem e mulher né Tudo bem um e dois é até bom para para fazer as comparações zinhas é bom para fazer o plot né você obriga que um grupo fique no um outro grupo fique no dois mas e na hora de fazer o gráfico eu
não queria que ficasse assim né então eu falo pega esse mesmo gráfico só que não põe nada no x não põe não põe Unos ticks no x faz a mesma coisa mas sem botar os ticks no x Então faz isso aqui e depois você só fala olha no eixo X o eixo um na posição um e dois põe homem e mulher e daí sa lá homem e mulher daí fica bonitinho mas na verdade não é variá categórica no Label é só o labz inho né É só um nomezinho e você pode fazer ainda um pouco
melhor né que você fala putz tem muito ponto aqui né Eu queria ter uma ideia de quantos pontos tem eu queria que ele ficasse um pouco mais e espaçado e daí você soma ruído soma ruído no os valores dos seus grupos seu grupo não um e dois mas você fala Poxa põe um ruid Dinho bem pequenininho uma distribuição normal com média zero des o padrão 0 1 no meus grupos daí eu eu faço ele ficar um pouquinho perto do zero ele ele varia um pouquinho ao redor do um varia um pouquinho ao redor do dois
né então eu tenho lá meus plots você consegue ver onde estão esses pontos né E daí só coloco de novo homem e mulher Então você consegue ver que tem muito ponto aqui fica mais fácil né não fica tudo um em cima do outro né É difícil de enxergar aqui quantos pontos tem aí é um jeito legal de você pilotar dando uma dispersão Zinha né colocando um pouquinho de variabilidade no nos seus no valor dos seus grupos é óbvio que tem que botar no no no grupo né tem que continuar sabendo que aquele lado é homem
e mulher você não pode botar no grupo de no valor da medida senão você estragou brinc você está estragando as suas medidas você tá botando lixo no teu gráfico Mas você tem que botar a soma no x né que no valor dos grupos né mantendo ainda não se eu botasse 05 aqui eu estragaria a brincadeira toda né né Eu não sei mais que grupo que é qual né ou seja tem que ser tem que fazer isso com cuidado né enfim Beleza então esse aqui era distribuição dos dados amostra de homem amostra de mulher que a
gente teve e agora a gente faz a permutação né como que tinha feito lá então pra primeira permutação tô fazendo devagarzinho aqui eu vou pegar isso aqui e permutar coloco fazer desorganizar o um e dois e depois plotar do mesmo jeito que eu tinha plotado antes Aqui já deu mais uma igualada nas distribuições né aquele homem que era alão el continuou no grupo dos homens mas por acaso Se eu rodasse de novo talvez aqui ele continuou naquele bom mas se eu rodar de novo velho de novo e de novo aí agora ele foi aquela medida
autona foi para foi pro lado das mulheres pode cair tanto um lado pro outro pro outro para com igual chance e roda o resto das permutações faz histogram minha do das permutações dá para ver ali que quase ficou normal né esse aqui ficou mais normal ainda que o outro não e vê que tá fora apesar de ser uma distribuição Mega torta ela ajusta razoavelmente para uma distribuição T né É claro que n não deu tão perfeito né nunca vai dar tão perfeito vai dar perfeito só se o seu n for imenso né mas mesmo com
n 110 aqui o sua distribuição T não aderiu também né então ficou um buraco aqui um buraco aqui então dá para ver que não era para usar T mesmo né o p valor do permutado que tinha dado quanto zero deu muito próximo do P valor do da t né O julgamento é mais ou menos o mesmo mas você não você não tá seguindo as premissas você não tá seguindo a coisa como se deve né então você não tá usando um teste que tá seguindo as premissas então você devia usar um teste de permutação aqui nesse
caso tá E é isso vou comentar aqui e vou descomentar aqui a primeira distribuição que vocês vão fazer é a bonitinha qu quiser brincar com os scripts isso daí vocês podem mexer quando vocês quiserem pode usar em outro lugar usar para fazer suas análises usar para fazer seus gráficos tá tá aqui ó o código e vocês trabalham vocês acharem melhor