na aula cinco a gente falou de testes de hipóteses a gente começou com os testes de hipótese e a gente tinha visto esse esquema de como fazer um teste de hipótese para comparação de médias né um teste bicaludal com alfa 5% então alfa é a probabilidade de falso positivo ou seja fixando uma hipótese nula como verdadeira qual que é a chance de rejeitar essa hipótese então o que que a gente faz pega aquele 5% como é bical down a gente reparte ele nos dois lados extremos né e o valor definido aqui é esse valor crítico
então se você tiver uma evidência experimental que joga para cá pra parte central você aceita a sua h0 você aceita sua hipótese nula né essa aqui é uma distribuição toda feita com base na hipótese nula né então se você encontrar uma evidência experimental que te jogue dentro dessa parte de aceitação então você fala: "putz eu encontraria aquilo pelo acaso" você aceita sua hipótese nula já se cair eh a partir desse limiar desse valor crítico você diria que é pouco provável ser guiado pela hipótese nula e tomaria uma decisão de rejeitar a hipótese nula tá outra
coisa que a gente viu na na aula anterior foi eh brincar com os erros né pensando que a gente tem uma distribuição guiada pela hipótese nula os valores de média possíveis pela hipótese nula e a gente vai fazer um teste unicaludal né por exemplo vamos colocar o nosso 5% jogados todos aqui nesse lado né então vamos supor que eu tenho uma razão para achar que o o acaso tá para cá e a única possibilidades de efeito seria um aumento da média teria então nossa área de aceitação da h0 uma área de rejeição de h0 a
gente assumindo que a verdade fosse essa outra distribuição aqui essa distribuição alternativa com uma média diferente da nossa média da h0 com isso você consegue definir um outro tipo de erro o erro tipo dois que tem probabilidade beta que é a área da hipótese alternativa que tá sobreposta à área de aceitação da hipótese nula né então esse é o nosso beta ou seja vira a nossa probabilidade de erro tipo dois taxa de falso negativo a chance de aceitar uma hipótese nula falsa pode inverter os dois lados né a chance de rejeitar uma hipótese alternativa verdadeira
uma hipótese alternativa específica né você tem sempre que definir você tem sempre que fixar uma hipótese alternativa para conseguir calcular um beta e uma vez computado beta tá computado também o poder estatístico né o poder estatístico é o 1 men beta ou seja essa área aqui que tá em branco essa área aqui é um é uma medida de probabilidade de detectar um um efeito existente né então assumindo que existe um efeito que tem esse essa média aqui por exemplo qual que seria a chance pelo nosso teste de detectar esse efeito né então um teste poderoso
é aquele que tem alta chance de encontrar o efeito existente né tem uma outra explicação nesse outro videozinho uma explicação diferente da minha mais pra área médica falando de sensibilidade e especificidade que se usa na área médica mas se usa também engenharia usa na detecção de sinais como como um todo então é uma explicação interessante também fiquem à vontade para assistir e vamos para vamos pra aula nossa a gente vai continuar dependendo da aula três né que era aquela aula que mostrava a distribuição das médias fazendo uma simulação que a gente tem uma população com
média mides vi sigma a gente tira uma amostra a gente já sabe como que vai ser a média dessa amostra a gente sabe que ela vai cair dentro dessa distribuição de probabilidade centrada no mi da população e com o desvio sigma dividido por raiz de n e que vai ter uma cara de normal pode ser normal pode não ser tão normal mesmo né o que a gente tem numa tabela z numa tabela t é tudo numa escala de erro padrão diferente da escala de valor bruto nosso né que é valor em centímetro quilo real o
que for né a gente vai encontrar sempre essa tabela esse é o rito padrão de trabalhar com probabilidades né então centrado no zero com desvio padrão um e você tem as probabilidades associadas a esses ts você tem as probabilidades do menos infinito até um valor de t e com isso que você tem que lidar e a gente tá aprendendo testes de hipótese no nosso curso além de desenvolver a distribuição ted student o gosto de desenvolver um teste de hipótese para verificar se uma amostra é proveniente de uma distribuição com média mi o procedimento para executar
esse teste envolve essa mesma normalização da diferença entre as médias pelo erro padrão pega sua média amostral subtrai da da média da nula e divide por um erro padrão a tabela t ela feita pensando num sigma que é estimado pela sua amostra né ou seja você tá usando s aqui e por que raios isso faria alguma diferença na aula dois nós vimos que a variância populacional sigma 2 é estimada sem viés pela variância amostral s2 vimos isso naquele exemplo com a população com infinitos 1 2 e 3 que tinha variante populacional sigma 2 de 0.66
depois selecionávamos muitas amostras de tamanho dois e obtínhamos que a média das variâncias populacionais s2 também dava 0.66 o que não vimos na aula do que estamos vendo agora é que o desvio padrão populacional sigma é estimado com viés pelo desvio amostral s e que esse viés é mais extremo com ns baixos naquele exemplo o sigma é 0.81 81 e uns quebrados enquanto a média dos desvios amostrais s dá 0.62 e uns quebrados portanto sestima o sigma com n baixo essa questão foi resolvida para fazer inferências pelo gosset criando as distribuições t que variam dependendo
do grau de liberdade nós já usamos a distribuição t para computar intervalos de confiança e vamos fazer testes de hipótese usando a distribuição t também vamos entender isso melhor a gente vai ver aqui por simulação qual que é a distribuição t de estudantes isso foi que o g descobriu há mais de 100 anos aí e a gente hoje consegue fazer isso fácil né com os métodos computacionais olha só essa ideia vamos supor que a gente tem uma população normal então aqui vai ser a porcentagem de benefício de um novo remédio por exemplo um remédio ele
melhora bastante o sintoma clico lá então tem uma melhora no de 100 com um desvio padrão de 50 mas às vezes pode ser até negativa o remédio às vezes pode estar associado a um prejuízo mas era uma chance pequena a gente já sabe que esse remédio funciona tem uma eficiência tal e a gente vai eh vai fazer uma simulação do jeito que a gente tinha feito antes uma simulação de amostragem só que agora ao invés de computar a média amostral a gente vai computar o t vamos fazer uma amostra bem pequenininha porque daí fica bem
claro que a gente não pode usar distribuição normal a gente tem que usar distribuição t então vamos construir uma distribuição dos ts observados ao longo de várias amostragens tá o raciocínio é o mesmo só vai mudar um pouquinho a conta então a gente vai foldar paraas várias amostragens para cada vez que a gente faz uma amostragem uma amostragem i a gente pega uns elementos de uma amostra que vem de uma distribuição normal que tem o parâmetro mi 100 e o parâmetro desvio padrão sigma 50 então a gente já tá pegando uma amostra de quatro elementos
que vem dessa população e uma vez que a gente tem essa amostra a gente extrai o valor de ter observado dela então o que que é a nossa média da nossa amostra menos o nosso mi aqui eu vou colocar o mi da hipótese nula né então que que a gente já sabe que é de lá vou colocar 100 mesmo aqui dá na mesma né só uma escalada né mas eu que tô querendo reconstruir a distribuição dos tos observados e agora eu vou fazer a divisão não pelo sigma dividido pelo √ n mas vou fazer pelo
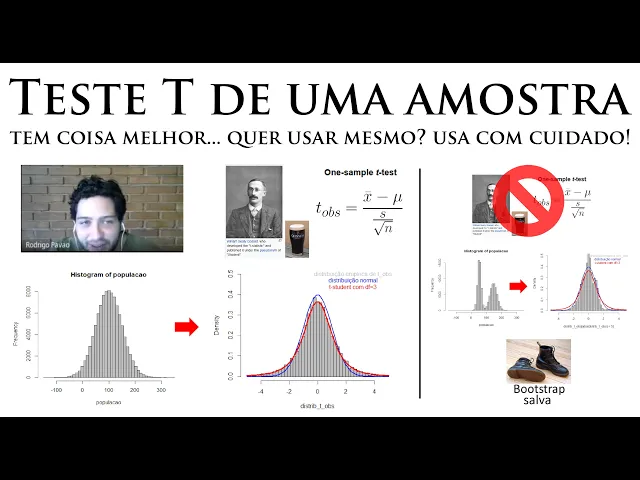
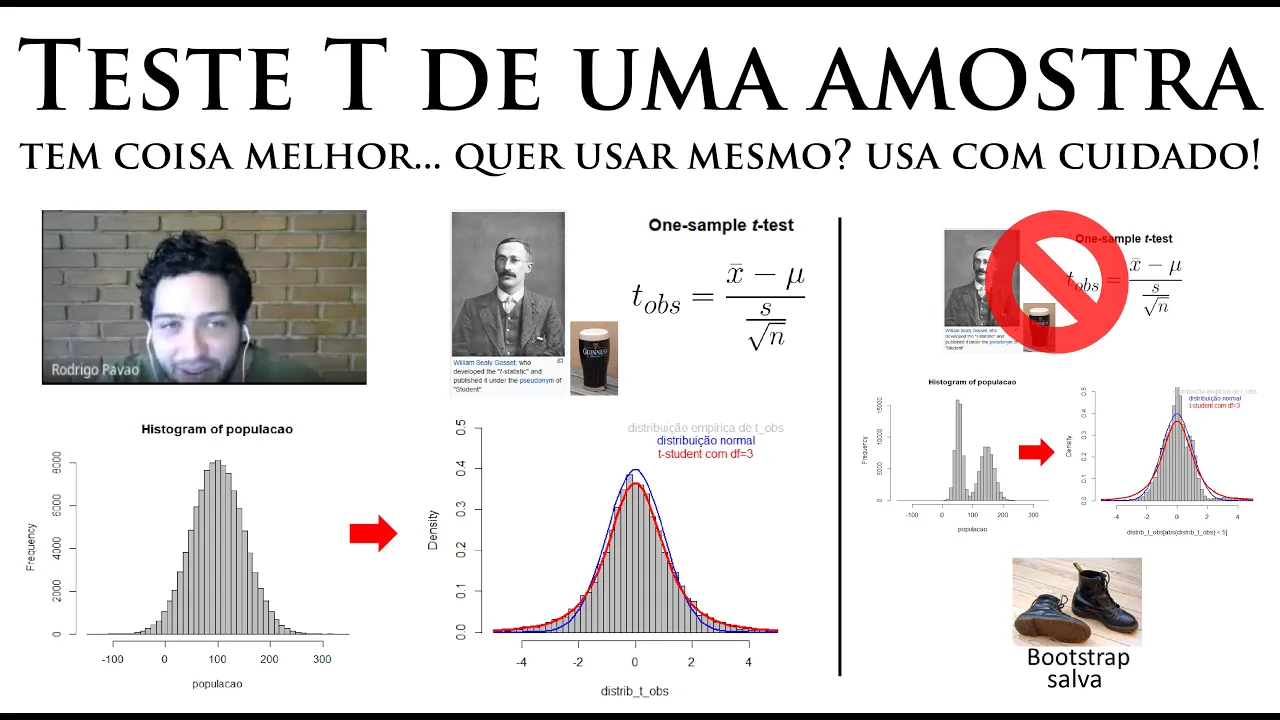
desvio padrão da amostra dividido pelo raiz do n e não vai ficar com nada de cara de normal essa aqui é é o histograma dessa distribuição dos tos observados tudo bem ela até parece uma distribuição normal se você ajusta uma distribuição normal com essa média e esse desvio padrão você vê que ela não adere bem a densidade observada no nesses dados ela tá muito mais densa nas caudas do que a normal e menos densa no meio né ou seja não é uma normal mas se você ajusta uma função t de student com grau de liberdade
3 o n é 4 coloca um grau de liberdade três você vê que ela ajusta perfeitinho tem uma aderência perfeita essa foi a sacada né do gosset ele percebeu que quando trabalhava com amostras pequenas e estimava o sigma pelo desvio padrão da amostra e construía essa essa estatística t não funcionava a a o ajuste normal né então ele criou um jeito essa função t que ajusta muito bem essa distribuição dos ts observados e beleza então vamos supor que eu peguei uma dessas amostras agora tá eu já sei que ela veio de uma distribuição normal com
mi 100 sigma 50 mas eu quero fazer o teste o teste de hipótese esse teste t de uma amostra para essa amostra eu quero saber essa amostra que a gente tirou de lá seria da eficiência desses remédios eu analisei quatro pessoas as quatro pessoas tiveram uma melhorinha mas eu queria saber se a melhora é 100 quero saber se essa amostra veio de uma população com média 100 eu consigo fazer um teste de hipótese em relação a isso bom só pegar e jogar no no r né então test da sua amostra contra um mi de interesse
o nosso mi 100 com aquela hipótese alternativa bicaludal e você obtém o seu t observado né que é esse -1.32 que é essa conta aqui grau de liberdade e tal e você consegue associar o p valor a esse t seguindo a hipótese nula então você já consegue fazer isso no r isso não é um não é um desafio mas é relembrar o que que a gente tá fazendo de fato para isso a gente tem que fazer passo a passo passo um estruturar uma hipótese nula no caso aqui a gente tá querendo saber se veio daquela
população com média 100 a gente tem uma hipótese nula de que nosso mi é 100 né ou seja o mi da hipótese nula é 100 e o alternativa é o oposto dela né babinha só inverter então seria o diferente depois a gente tem outros três passos vai precisar de um pouco mais de espaço a gente vai fazer em outros slides então o passo três que é estruturar a distribuição regida pela hipótese nul depois identificar as regiões e conduzir o teste de significância então vamos lá só fazer isso aqui rapidinho então temos lá os dois primeiros
passos agora a gente quer fazer esse três construir a distribuição regida pela lula vou construir essa distribuição usando a distribuição t com grau de liberdade três então vou fazer um plot de -4 até 4 pros valores da distribuição t da função densidade de probabilidade né dt density né density distribution função densidade de probabilidade tes mesmos valores de -4 a 4 com grau de liberdade 3 eu quero fazer isso num gráfico de linha tá botei isso no r os valores de -4 a 4 tão aqui e o o dt de -4 a4 com grau de liberdade
três e eu vou dar uma enxugada aqui tá só vou ficar com esse pedaço aqui tá mas a gente tem aqui a nossa a nossa curva bem precisa aí bem bonitinha média zero e centrada no zero com desvio padrão um então como que chama essa escala escala t ou escala z né mas aqui é t a gente vai usar t então vamos falar que é escala t escala de erro padrão a gente tem também a nossa escala de dado bruto que nosso caso aqui é porcentagem de melhora né o que que seria o zero é
o mi da hipótese nula é o 100 tá esse aqui é o 100 aí que que é o mais um é o mi da hipótese nula mais um erro padrão o erro padrão a gente sabe computar né o erro padrão é só pegar o desvio padrão dessa amostra dividido por dois né que o n é 4 então você chega nesse erro padrão outro lado é o mi de hipótese nula menos um erro padrão beleza então a gente já conseguiu definir aqui a nossa distribuição regida pela hipótese nula próximo passo seria definir as regiões em que
aceita e rejeita h0 aqui ninguém falou nada então o nosso alfa vai ser 5% e vamos usar o bimodal né porque nossa hipótese nula hipótese alternativa são não direcionais a gente tem que botar 2,5 para cada lado tá botamos lá o 2,5 para cada lado e minha pergunta é: aonde que tá o que separa a região de rejeição da região de aceitação qual que são os valores são esses ts críticos né a gente vai descobrir ainda que valor é esse mas a gente sabe que tem um valor crítico aí que a gente pode caçar depois
na tabela e tem o valor bruto que é o mida h0 mais o valor de t crítico vezes o erro padrão então seria a quantidade de erros padrões né pode ser dois e pouquinho erro padrão então esse aqui é o mi t crítico vezes o erro padrão aqui é o 10 menos o t crítico vezes o erro padrão e da gente quer agora descobrir que valor que é esse t crítico né e a gente já sabe qual que é o grau de liberdade a gente tem n4 grau de liberdade três então a gente vai pegar
nessa terceira linha e a gente tá querendo pegar a integral de menos infinito até 97,5 né para ter 2 aqui tem que ser 97,5 é isso que tem disponível nessa tabela pra gente então a gente coloca lá 3.18 lá então esse é o nosso t crítico e a gente poderia fazer isso no r facinho também né qual que é o valor de t para essas probabilidades qt dos valores de probabilidade para grau de liberdade 3 daí ele vai dar o -3,18 e o + 3,18 enfim o nosso t crítico é 3,18 então a gente pode
botar lá - 3,18 dá para ver aqui quão longe tá da distribuição normal né na normal é 1.96 essas caudas que delimitam o 5% delas estão mais de uma unidade de erro padrão pra frente mostrando que essas caldas são realmente muito mais pesadas então essa distribuição é muito mais densa na calda do que uma distribuição normal feito isso a gente consegue então definir a nossa área de aceitação né tá definida aqui que ela começa no -3.18 termina no + 3.18 e depois mais para fora é a área de rejeição feito isso etapa cinco que é
fazer o teste de fato né?onde que cai a nossa evidência empírica aonde que cai o nosso t observado tem que fazer a conta do t observado então o nosso t observado é o nosso x barra né faz aqui a médiazinha disso aqui você chega em 73 subtrai do seu mi da hipótese nula que é 100 dividido pelo erro padrão o erro padrão o sigma estimado pro desvio padrão da amostra computar o desvio padrão daqui você obtém 43.77 né a distância média pra média né então a distância média pro 73 dividido pelo raiz do n dividido
pelo √4 resolve essa continha você chega no -1.23 e aí você olha onde é que tá esse -1.23 tá mais ou menos aqui né então tá lá nosso 1 1.23 caiu na área de aceitação da hipótese nula portanto aceitamos a hipótese nul computando o nosso t observado x barra - o mi dividido pelo erro padrão que o erro padrão é o desvio padrão da amostra dividido pelas raiz do n o nosso t observado deu -1.23 como tinha feito na mão você calcula então a probabilidade de encontrar por essa distribuição regida pela h0 qual que é
a probabilidade que tem regida pela hipótese nula do menos infinito até esse t observado então seria essa área aqui né 1.23 tá aqui então qual que é essa área aqui ele dá pra gente 15% e como a gente está fazendo um teste não direcional certo a gente tá fazendo um teste bicaudal a gente tem que multiplicar por dois para pegar os valores dos dois lados né então é o mais extremo né não é o valor não é o menor nem o maior é o mais extremo então você só multiplica o valor de p então temos
um p valor de 30% e que dá exatamente a mesma coisa que o teste t feito pelo r teste da amostra comparando com o mi você chega no mesmo t e chega no mesmo p valor tá então tá bem aqui a gente então aceitando a hipótese nula né aí minha pergunta é: o que que é esse p valor vamos meçar um pouquinho melhor do que que é isso bom primeiro o p valor é uma probabilidade computada a partir da estatística amostral e a distribuição regida pela hipótese nula ok então você vai ter que olhar onde
que sua estatística cai e computar uma determinada área que área que é essa é a área embaixo da curva partindo do seu t observado seguindo para os ts mais extremos que daí pode ser o mais extremo para esse lado também né então você pode põe põe você imaginar que tem 1.23 desse lado também né é igual ou mais extrema pros dois lados por isso que multiplicando por dois tá então resumindo aqui o p valor é a probabilidade de obter pelo acaso uma estatística igual ou mais extrema do que observada tá então p valor só se
associa a hipótese nula não se associa à hipótese alternativa por isso que isso aqui é um teste de hipótese nula né tudo a gente tá colocando em relação ao acaso qual que seria a chance de encontrar uma medida igual ou mais extrema do que aquela que você encontrou pelo acaso só que essa definição é horror né vamos lá você pergunta para qualquer pessoa: "o que que é p valor eh a pessoa vai parar para pensar né e vai te falar uma coisa errada tá é isso que acontece ela vai te falar uma coisa errada isso
aí é uma coisa que todo mundo fala errado é terrível tem mais e mais pessoas falando que a gente faz muitos equívocos a gente tem uma interpretação equivocada do ponor né isso aqui é um artigo que tenta sistematizar isso né eles falam que essa definição é horrível não é tratada da forma adequada nos cursos de estatística e faz com que as pessoas tenham um monte de concepções erradas aí sobre o que que é um p valor a sugestão deles aqui ele tá querendo puxar sardinha pra estatística beisiana vamos usar um outro tipo de estatística que
tem várias dessas ideias de que a gente gostaria que o p valor fosse né não é o foco agora falar de base ano o que a gente tá querendo falar é dessa definição terrível mas que é a definição de p valor que a gente tem que lembrar o que que é o p valor né probabilidade de obter pelo acaso uma estatística igual ou mais extrema do que observar e esses vários equívocos essas interpretações equivocadas aqui ele listou essas 12 e eu vou tratar só das cinco primeiras aqui se o p valor é 5% a hipótese
l ela tem só 5% de chance de ser verdadeira você olha isso rapidinho você fala: "meu não tá tão mal né?" mas ele falou que era um equívoco então vamos lá que que é qual que é o equívoco aqui né para você conseguir definir o seu v valor você já tá assumindo a sua hipótese nula verdadeira guiado pela hipótese nula qual que é a chance de encontrar uma evidência igual ou mais extrema do que o que eu encontrei não fala a chance de sua hipótese não ser verdadeira então tá errada essa primeira a segunda uma
diferença não significante por exemplo p valor 10% significa que não há diferença entre os grupos tá essa aqui é uma coisa é a decisão que você faz você faz um julgamento de que não tem diferença entre os grupos mas isso não significa isso não implica você sempre tem uma chance de falar tá falando besteira você sempre tem uma chance de fazer um erro tipo um erro tipo dois aqui quando você faz o julgamento de que não tinha diferença você pode estar fazendo um erro tipo dois pode ser que você esteja perdendo efeito aqui né você
está julgando que não tem efeito mas pode ser que ele tem então você pode estar fazendo um erro tipo dois tem uma propriedade beta então primeiro isso aqui não significa isso e outra coisa o p valor ele não diz qual hipótese que é mais provável você pode ter uma hipótese nula e uma hipótese alternativa ali vamos supor que você tenha duas opções ou é o acaso que geraria sei lá um mi zero ou é uma hipótese alternativa que geraria um 100 o p valor ele só tá falando da área relativa à distribuição do do zero
ele não tá falando qual que é mais provável dentro dessas duas você tem que buscar outras ferramentas se você tá querendo buscar qual delas que é a explicação mais plausível né a explicação mais provável o que ele tá fazendo é um teste da nula só três um achado estatisticamente significante indica importância ou relevância também não tá a primeira vez que eu vi alguém falando disso foi uma das aulas estatísticas que eu tive com um engenheiro florestal eu não sei de qual universidade eu acho que foi de campinas e eles vieram pra usp lá eles estavam
dando um curso de estatística e eles falaram: "ó eu tava fazendo um teste com eucalipto né plantação de eucalipto e daí eles tinham o jeito normal de plantar os eucaliptos eles estavam fazendo algum procedimento lá botava mais água botava alguma eles faziam algum tratamento e eles encontraram que deu um aumento no diâmetro do tronco do eucalipto legal conseguimos um efeito depois eles foram ver quanto que tinha aumentado e eles encontraram uma quantidade mínima sei lá 2% de aumento eles tinham uma quantidade gigante de eucaliptos produzindo essa amostra gigantesca eles vão ter um poder estatístico gigantesco
então mesmo que seja uma diferença mínima que no caso deles era uma mudança de 2% eles encontravam um valor super baixo ou seja estatisticamente significante mas que era nada relevante não valia a pena fazer aquele tratamento novo mudar o jeito de fazer a plantação por causa daqueles 2% ou seja não quer dizer nada sobre importância ou relevância né o exemplo mais do dia a dia nosso aqui é esse das vacinas né é necessário que tenha uma eficiência de pelo menos 50% ou seja tem que ter uma eficiência grande ali né para valer a pena usar
essa vacina né então se fosse uma eficácia de 1% né se você tiver uma amostra muito gigante você pode encontrar uma mudança um achado estatisticamente significante mas 1% você fala: "não vou vacinar a população inteira para ter uma mudança tão pequena" o que tá colocado aí é que você tem que medir o tamanho do efeito né vai avaliar quanto que é a diferença entre a média entre controle e experimental ou entre antes e depois o grau de mudança entre a nula e a sua melhor estimativa de efeito né sua melhor estimativa do mi da hipótese
alternativa um quarto equívoco é esse um estudo com p valor significante é conflitante com um estudo com p valor não significante tá então um estudo faz um julgamento de que teve diferença um p valor significante um outro estudo fez um julgamento de não diferença um p valor não significante existe conflito entre eles pô um falou que sim o outro falou que não por santo tem conflito vamos só olhar aqui uma figura que mostra aqui que o efeito pode ser pro mesmo lado então vamos supor que a gente tá trabalhando com porcentagem de benefício do remédio
a mesma historinha os dois estudos têm exatamente a mesma média os dois estudos mostram que teve uma melhora de 10% só que um fala com p valor 30% outro fala com p valor 02% os dois estão apontando pro mesmo lado só que um sei lá ou tava usando um método muito mais refinado muito menos variabilidade ou esse estudo aqui teve acesso a uma amostra muito maior os dois estão falando a mesma coisa estão apontando pro mesmo efeito médio um tem intervalo de confiança gigante outro tem um intervalo de confiança pequenininho né e daí o que
acontece é que cada um tem um p valor correspondente isso aqui julga que não teve efeito ele não conseguiu rejeitar a hipótese nula do acaso e aqui ele conseguiu rejeitar a hipótese nula né evidência experimental que eles tiveram permite rejeitar a hipótese nula olhar só o p- valvalor não indica conflito quinto equívoco estudos com o mesmo p- valor oferecem o mesmo grau de evidência contra a hipótese nula esse é um outro equívoco um exemplo legal de olhar naquela figura que tava do lado essa parte b então de novo porcentagem de benefício pelo remédio um lá
em quase 20% com um intervalo de confiança super largo o outro 2% com intervalo de confiança super curto os dois estão com p valor de 5% mas um mostra que quase não tem melhora tá no libá estatístico ali mas quase que não tem melhora e o outro indica que pô parece que tem uma melhora razoável só que tem muita variabilidade tá no limear para rejeitar ou não a hipótese nula aqui um é de quase não mudança e o outro é de mudança só que com muita incerteza né só mostrando que esse aqui é um outro
equíbrio aí tem esses vários outros aqui são bem interessantes também eu vou disponibilizar esse artiguinho beleza e o próximo passo agora que eu vou fazer eu quero saber qual que é o valor que eu obtenho comparando a média da minha amostra com diversas médias eu criei uma amostrinha aqui de 10 elementos tá que tem média 170 desvio padrão 15 altura de humanos peguei uma amostra de 10 humanos e agora eu vou comparar essa minha média com vários possíveis mi da hipótese nula babinha fazer isso no computador né fiz vários testes independentes né de teste da
minha amostra versus um da hipótese nula de 215 agora com mi de 200 com 1000 de 185 eu fiz vários desses tá para vários números e o que eu obtive foi isso aqui então o teste t de uma amostra sendo um teste baldudal né não direcional pode ser tanto para um lado quanto pro outro a diferença com alfa de 5% qual que é o p valor que eu encontrei aqui era a média era 150 se eu colocar comparado com uma média de exatamente 150 eu tenho um p valor de 1 eu tô pegando aquela distribuição
regida pela hipótese nula e tô falando qual que é a chance de encontrar um valor igual ou mais extremo do que do que o que eu encontrei é um né porque eu tenho que pegar a área do do menos infinito até o centro da minha distribuição que é ou seja já dá 50% só que é um teste bicaludal tem que multiplicar por dois a chance de encontrar pelo acaso uma distribuição igual ou mais extrema do que aquela é 100% né então esse é o p valor 1 se a gente começa a andar mais para fora
aí aqui eu coloquei perto do limear né onde onde um pouquinho para cima de 5% e um pouquinho para baixo de 5% aqui então o último azul subindo aqui o último azul é de 5.8% e para baixo aqui é o 4.2% então eu coloquei um valor lá que é 180 sei lá 180 e pouquinho e daí se eu coloco um pouquinho mais do que esse 180 e pouquinho ele já começa a dar diferença tá e se eu coloco 185 já dá um um p valor bem mais baixo não de 1% 0014 vai caindo bastante conforme
eu vai eu vou comparando a minha média com um mi da hipótese nulo aqui né onde estaria centrada minha hipótese nula com esse valor tá então aqui os que estão em azul são os que deu igual eu faço o julgamento que veio da minha hipótese nula né ou seja eu aceitei minha hipótese nula e aqui são os que eu julgaria que deu diferente ou seja aqui eu falar não foi por acaso eh eu acho que o mi da minha hipótese nula é diferente do mi de onde veio essa amostra né então as distribuições são diferentes
essa ideia quero ver como que esses limares aqui batem com as estatísticas que a gente já sabe computar por exemplo x barra mais ou menos o desvio padrão então x barra mais ou menos o desvio padrão não bate com essa diferença e o x barra mais ou menos o erro padrão não também não bate ó não é não é isso que separa o azul do vermelho né tá isso eu coloco o intervalo de confiança 95% 95% é equivalente ao alfa de 5% né daí olha só coisas que estão um pouquinho para cima do meu intervalo
de confiança eu vejo que é diferente quis estão um pouquinho para baixo do meu intervalo de confiança eu julgo que veio da da mesma distribuição né tanto em cima quanto embaixo tá então isso mostra que para esse caso intervalo de confiança é um bom jeito de fazer uma análise gráfica né de teste de hipótese de uma amostra bacana e vamos trabalhar com uma outra amostra agora que agora tem 100 né então essa aqui era uma amostra de 10 elementos tem 10 xizinhos aqui fazer 100 xizinhos e vou fazer o mesmo caminho x barra + padrão
x barra mais erro padrão e o intervalo de confiança centrado no x barra e de novo deu aquela mesma coisinha ali ó que o intervalo de confiança separa onde eu julgo que tem diferença entre as médias e onde não tem aqui deu zero não é zero né é que o computador consegue trabalhar com um certo número de casos decimais né se eu peço para ele falar que valor aqui ele vai falar zero tá ou seja o intervalo de confiança conseguiu separar essa área do limar de julgamento né o p valor menor do que 5% e
maior do que 5% aqui dentro e menor de 5% de novo para baixo então aqui para esses dois casos a gente viu que funciona essa parada aqui que o intervalo de confiança é uma boa análise gráfica pro teste de pósito de uma amostra bical downal ou seja dá para fazer comparação de média amostral com a média pode ser nula né por análise gráfica usando intervalo de confiança da média lindo super prático e por isso que as pessoas usam por isso que as pessoas plotam intervalos de confiança também nos nos artigos que dá para fazer uma
comparação grosseira aqui e no caso da comparação de média de amostra com midtese nulo a gente viu que dá exato tá dá super bem e a gente já tinha visto isso né quando a gente estava olhando aquele gráfico de média intervalo de confiança a gente via que o intervalo de confiança previa bem qual que era o p valor né então p valor de 30% ele cruzou o zero aqui ó esse intervalo de confiança que inclui o zero você aceita a hipótese nula você não consegue rejeitar hipótese nula de que o mi é zero tá e
aqui você rejeita né porque o seu intervalo de confiança não tá incluindo o seu mi da hipótese nulo tá e aqui tá bem no limear né os dois estão bem em cima então dá o p valor 5% é bem o limite do seu intervalo de confiança e o que que dá para fazer além disso qual que é o outro ganho de ter funcionado esse negócio a gente já sabe fazer bootstrap para calcular intervalo de confiança lembra que a gente fazia aqueles intervalos de confiança sem pagar nenhuma premissa né você não tem que assumir nada né
você não tem que assumir que tá seguindo uma distribuição t né você consegue fazer isso com base só na informação que tem disponível na sua amostra que é esse procedimento e o cálculo do dos intervalos de confiança por bootstrap né então já que a gente pode usar o intervalo de confiança para fazer um teste de hipótese a gente consegue também usar o mesmo procedimento bootstrap que a gente usava para fazer cálculo de intervalo de confiança para fazer comparação de média uma média amostral com parâmetro mido uma hipótese nula e só relembrando o que que era
o procedimento bootstrap né então é reamostrar a sua amostra reamostrar os dados observados com reposição daí você calcula suas estatísticas de interesse aqui a gente tá falando sempre de médias né então calcular a média dessas amostras bootstrap e salvando esses valores né repete muitas vezes lá 10.000 vezes eu uso por padrão e depois para computar o intervalo de confiança você olha qual que é o percentil 2,5 e 97,5 para o intervalo de confiança é 95% né mas se eu quisesse fazer o p valor eu só falo essa distribuição onde que cai a minha hipótese nula
e eu consigo computar qual que é o valor igual ou mais extremo do que eu observo nas minhas médias bootstrap tá vamos olhar com cuidado isso aqui aqui a gente tem aquela mesma amostrazinha né de melhora dada por aquele remédio quatro elementos e daí a gente vai fazer o quê a gente vai fazer uma remagem então a gente define um vetor onde vai colocar as médias bootstrap depois a gente bota isso num loop né para rodar lá nossos 100.000 bootstraps au a gente primeiro define a nossa amostra bootstrap para cada vez que a gente roda
esse loop a partir dessa amostra faz a amostragem da nossa amostra com mesmo tamanho com tamanho quatro também com reposição tá e uma vez que fez isso tira a média desse valor e salva no nosso vetor de médias do bootstrap e depois é só concutar o p valor é baba né você fala: "olha das minhas médias o que que é maior ou igual ao meu mi mi mi da hipótese nula vai dar um vetor cheio de trues e falses true ele linguagem de computador é um false zero então eu consigo tirar a média desses true
e false né então eu chego numa porcentagem de true aqui que daí eu só tenho que multiplicar por dois porque é um teste bicudal também né então o meu p valor é duas vezes a porcentagem de true às vezes isso aqui vai dar bobagem né dizer aqui não eu eu não sei para que lado caiu essa distribuição se ela caiu para cima ou para baixo do 100 e eu não quero nem pensar nisso um dos dois vai dar certo quando roda esse negócio aqui ele autocorrige depois eu só pergunto lá que p valor que deu
eu consegui esse p valor aqui de 11% eu aceito a hipótese nula com esse p valor então se eu fizesse um histograma das minhas médias bootstrap eu tenho essa distribuição aqui você vê que um n pequenininho ela não gera uma coisa que parecendo uma normal ela é pequenininha e assimétrica e feia né então ela não gera uma distribuição que parece uma normal mas tudo bem para essa amostra que eu tenho para essa evidência que eu tenho esse é o melhor que eu posso fazer tá e daí eu só coloco lá o meu 100 e eu
calculo qual que é a porcentagem das minhas médias bootstrap que estão além do mi da minha hipótese nula então tem 5% né que eu só multipliquei por dois e deu os 11 ah e aqui só para comparar né qual que é o intervalo de confiança usando o método bootstrap que vai de 31,5 a 101 e no caso o 100 ele tá dentro desse intervalo voltando para aquele para aquilo que a gente tinha visto se a média mi zero tá dentro do nosso intervalo de confiança a gente toma uma decisão de aceitar a hipótese n tá
falando desse método né e por que usar esse método eu peguei um texto da introdução desse capítulo um capítulo sobre métodos de bootstrap e testes de permutação vou disponibilizar também por que realrar por que usar esse método de reamostragem primeiro você tem menos suposições esses métodos não exige que a distribuição seja normal ou que o tamanho de amostra seja can você não tem suposição nenhuma é um método também com maior precisão os testes de permutação e alguns dos brutos strap são mais precisos que os métodos clássicos que fazem essas suposições também eles são muito gerais
a gente falou lá aquela chave mestra né ele serve para testar qualquer tipo de estatística né ou seja você não precisa de uma fórmula nova para cada estatística isso aqui você consegue trabalhar para análise de qualquer estatística só quero mostrar no r como fazer aquele caminho que a gente fez aqui vou limpar todas as variáveis que eu tenho aqui comandinho que eu aprendi ontem apagar gráficos tá certo zera ali então a gente vai fazer uma simulação de amostragem né aquele parâmetro mi 100 sigma 50 e o n4 aqui eu vou fazer com uma população normal
tá tá depois eu vou fazer com outro tipo de população tá mas eu vou fazer aqui com a normal primeiro se eu olho lá qual que é a média da minha população deu quase zero o desvio da minha população é quase um tá eles ve vieram de uma distribuição com média zero desvio padrão um né quando você coloca aqui ele já vem de fábrica dessa forma mas daí agora eu vou forçar fazer com que ela fique exatamente com zero e fazer com que ela fique com um e daí agora eu só tô forçando os parâmetros
sigma e mi nela tá vou fazer um histograma da minha população aqui é o histograma da minha população entrada exatamente no 100 exatamente 100 e o desvio padrão da minha população ele dá exatamente 50 o desvio padrão populacional é exatamente 50 tá vou fazer 10.000 amostragens eu quero fazer primeiro uma distribuição das médias que é o que a gente tá fazendo habitualmente e eu quero fazer também a distribuição dos tos observados então vou criar vetor pros dois e daí para cada vez que eu vou definir uma amostra então vou fazer lá i = a 1
as nossas amostras são de n4 né tá que que deu na minha amostra deu esses valorezinhos aí posso tirar a média da minha amostra assim como eu posso calcular o meu t observado eu deu 0.68 e vou rodar isso aqui as minhas 10.000 vezes tá a minha distribuição das médias tá aqui concentrada no 100 o desvio padrão dela qual que é desvio padrão da minha distribuição tem que dar o sigma dividido por raiz do n né deu 25 o meu sigma é 50 dividido pela raiz do n é 4 deu 25 ou seja bateu tá
batendo bem ao invés de querer mostrar a contagem eu posso colocar aqui esse comandinho prob igual a true então eu transformo isso aqui ao invés de uma medida de contagem de frequência absoluta eu transformo uma medida de frequência relativa né de probabilidade com esse daqui eu tenho valores absolutos com isso aqui eu faço com que essas densidades somem um né faço com que a área seja um virou uma medida de probabilidade e essa aqui seguindo uma distribuição normal bem bonitinha né mas quando eu faço t ó tá então seria isso aqui primeiro né histograma da
distribuição dos meus ts só que daí ele fica muito ruim de ver né então eu quero que ele plote só de -5 a 5 também usando distribuição de probabilidade então tá lá agora só plotei de -5 a 5 usando prob igual a true tá e fazendo as pausas 50 pausas 50 breakses 50 espacinhos entre esses dois valores e eu tenho aqui a minha distribuição empírica e olha só como deu diferente né a distribuição essa é a distribuição das médias e essa é a distribuição dos ts observados dá para ver a diferença no formato então essa
aqui é a nossa distribuição empírica dos tos observados com aquelas caudas pesadas e ajusta uma normal ploto uma normal aqui d enorme né para fazer uma distribuição normal de -5 a 5 e tal e e tá malzão né só botei ali o distribuição normal escrito em azul e agora vou plotar a distribuição p tá aí nossa distribuição esse aqui encaixou bem bonitinho né bem legal tá então funciona quando a minha distribuição da população tem uma distribuição normal segue uma normal funciona perfeito t e agora vamos fazer ele quebrar ó não vai funcionar mais o que
que eu tô fazendo aqui eu tô mantendo o mi e o sigma e o n originais só que minha população agora ela vai ser bimodal eu vou ter uma uma distribuição normal centrada em no -4 e uma outra uma outra distribuição normal centrada no +4 e essa daqui eu vou fazer um desvio padrão um pouquinho mais largo e depois eu vou forçar ela a ter esses parâmetros aqui né mi 100 sigma 50 forse então subtraí a média dividi pelo desvio padrão e depois eu multipliquei pela média pelo desvio padrão que eu tenho interesse e olha
lá como é que tá o histograma então essa aqui virou minha população tá ele é bimodal e assimétrica horrível né tudo que você não pode ter se você tiver trabalhando com uma distribuição assim então isso aqui seria sei lá médias de crianças e adultos né então eu peguei a média de criancinha da primeira série junto com adultos né sei lá no em 70 aqui tá minha população foi essa que é essa mistura dessas duas coisas por exemplo aí eu não posso usar t eu vou mostrar por olha lá então vou construir minha distribuição das médias
de distribuição t aí minha distribuição das médias minha distribuição das médias até que não tá tão feia né centrada no 100 que é o mido populacional com desvio padrão mais ou menos qual que é o desvio padrão dessa parada desvio padrão da distribuição das médias esperava 25 e deu 25 de novo né o sigma dividido pela raiz do n tá o sigma continua bem só que o formato tá muito mal né isso aqui não tem cara de formato de distribuição normal só funciona no limite né teorema central do limite funciona com n no limite aqui
a gente colocou um n muito baixo para quão deformado essa distribuição o n4 não resolve eu posso colocar isso aqui em função de probabilidade a mesma coisa e agora vamos olhar a distribuição dos ts olha como é que deu essa distribuição dos ts de -5 a 5 que horror essa é a distribuição empírica dos ts observados e agora vou plotar a distribuição normal dá para ver que não adere e agora vou plotar a distribuição t dá para ver que não adere também tá essa distribuição t com des padrão três ou seja para usar o t
você já tem que assumir que a sua população eh era normal se a sua população for normal você pode usar o t sem problema mas se sua população não for você não pode usar o t então a distribuição dos tos observados adereição t de estudant a população segue distribuição normal na vida real olha o histograma da tua amostra você pega pega a sua população e olha a tua amostra se for muita diferença de uma distribuição normal fala: "putz não posso usar t porque você já tem evidência de que sua população não segue uma distribuição normal."
mas ainda bem que você pode usar o bootstrap né o bootstrap é sempre uma possibilidade e você não tem que se preocupar com isso esse é um dos pontos tá vamos pegar uma amostra que ela é toda feia aqui tá vamos supor que eu coletei esse dado eu quero comparar ele com o midh0 de 90 e eu tenho minha amostra aqui o histograma da minha amostra olha só como é que é o histograma da minha amostra eu tenho um monte de dado aqui perto do zero depois um monte de dado lá perto do 80 e
depois uns números picado mais paraa frente eu já vejo que não segue uma distribuição normal ou seja fazendo um teste eu tô assumindo uma premissa que eu parece que não é válida né ele até roda você volta lá te testo roda ou te teste para mim ele roda ele me dá lá me dá um p valor faz tudo funciona só que ele pode tá falando bobagem porque a gente não tá seguindo uma premissa importante aí tem um teste para ver porque você não tem acesso à sua população né mas você pode falar: "poxa faz um
teste para mim para saber se veio de uma distribuição normal esse chapiro wilk teste teste de normalidade chapiro wilk." e o que eu vou rodar aqui primeiro para mostrar é um teste colocando uma distribuição normal tá ela tem 16 elementos igual a minha amostra ela também tem 16 elementos mas eu tô botando aqui que meus dados vem de uma distribuição normal de média zero desvio padrão um faço um chapiro ou test dos meus dados que seguem distribuição normal e ele vai me dar um p valor ele vai comparar a forma da minha amostra com a
forma de uma distribuição normal eh teórica e daí ele vai falar aqui ó eu não consegui rejeitar a hipótese nula a hipótese nula é de que seria uma distribuição normal né então ele não rejeita a hipótese nula de que é uma distribuição normal nessa aqui deu 0,7 acima do 5% mas se eu rodar de novo ó agora deu 57 eu tô fazendo amostras diferentes né e mas uma hora aqui vai dar menor do que 5% né um em cada 20 vamos rodando vamos rodando uma hora vai dar 1 hora vai dar 1 em 20 vai
dar ó aqui deu ó nesse caso deu depois de não sei quantas vezes que eu rodei essa parada uma das amostras que foi gerada que ele falou: "olha rejeito que essa essa sua amostra veio de uma distribuição normal" é isso aqui é o teste de normalidade aqui a gente tá usando esse chapiro wilk que é um dos melhores e agora vamos usar o chapiro wilk não para uma amostra que a gente sabe que veio de uma distribuição normal vamos usar paraa nossa amostra bimodal assimétrica horrenda aqui né a nossa amostra toda torta e deu lá
um p valor baixinho também ó então provavelmente fala: "putz eu rejeito que essa hipó isso aí veio de uma distribuição normal." rejeitou a hipótese nula de que veio de uma distribuição normal beleza então a gente não pode usar isso aqui né a gente não pode usar o nosso test a gente viu que uma a premissa não tá cumprida então a gente pode usar o bootstrap que não tem essa premissa faça lá minhas 100.000 vezes e para cada vez que eu rodo isso aqui tiro uma média e me calculo um p valor eu vou ter lá
meu meu vetor de médias bootstrap histograma das minhas médias bootstrap centrado na média da minha amostra né então mim da minha amostra é 67 é uma incerteza da minha medida da média né então centrado no 67 e agora eu posso calcular o p valor então vou pegar minhas médias do strap e comparar com a o meu mid hipótese nula né eu já tinha definido lá em cima né que eu quero comparar quero saber se essa distribuição veio de uma de uma distribuição nula com parâmetro média 90 então vou comparar a minhação das médias com meu
mida hipótese nula então esse monte de ponto com midha hipótese nula ele vai dar um monte de true ou false tiro a média vou saber qual que é a média de true então é 2% de true então multiplico por 2 e chego p valor p valor deu 4,5% eu podia ter feito errado né daí era só inverter e tá nosso valor de 4,5% aqui nesse caso aqui a gente rejeitaria a hipótese nula de que veio de uma população com média 90 a gente rejeitaria essa hipótese porque ela tá menor do que o nosso alfa de
5% beleza aí o nosso histograma o nosso histograma da distribuição das das médias bootstrap dá para calcular o intervalo de confiança aqui ó nosso intervalo de confiança cai logo na borda né o nosso mi o nosso mi da hipótese nula é 90 e dá para ver que o intervalo de confiança termina um pouquinho antes de chegar a esse mid da hipótese nulo é consistente com o nosso p valor né que é quase igual 5% né um pouquinho para baixo mas ainda cai na área de aceitação de poin ou seja não podemos usar o o teste
t para dado muito estranhão e mas a gente pode usar o bootstrap né que é esse esse teste que não tem suposição né não tem suposição de que segue uma distribuição normal e é isso aí tá professor o que você quer dizer com população normal seria uma unimodal centralizada ou só unimodal então eh o que acontece para usar teste t a premissa é que a população é normal o teste t ele é muito resistente ele funciona mesmo se você tiver uma população que é unimodal e simétrica pelo menos unimodal e simétrica ele ele já ele
tende a funcionar razoavelmente bem mas a premissa coisa que vai funcionar a continha direitinha é se sua população seguir uma distribuição exatamente normal essa suposição é por isso que é tão legal usar esses testes né bootstrap essas coisas que você não precisa ter essa essa premissa