[Música] muy buena mi nombre es abraham requena y soy informático actualmente estoy trabajando como desarrollador big data en una empresa multinacional española bueno durante este vídeo vamos a hacer una pequeña introducción a los fundamentos de hadoop nos podemos preguntar qué es hadoop bueno pues saluden back un framework que nos permite el procesamiento distribuido de grandes cantidades de datos usando modelos de programación simple sobre un clúster de máquinas cuáles son las características básicas que posee apache hadoop bueno en primer lugar su procesamiento distribuido la idea de hadoop es poder distribuir los datos poder para realizar el
tratamiento de los datos de forma que cada que cada nodo de nuestro carácter de máquina procese una parte de los datos de esta manera estaremos ganando velocidad luego es un proceso eficiente porque consigue procesar los datos en poco tiempo es un proceso es un framework económico porque se puede escalar fácilmente de manera horizontal si se nos queda pequeño nuestro sistema lo que tenemos que hacer únicamente añadir un nuevo nodo que lo añadiremos a nuestro clúster de máquinas y ya no tendremos problemas vale que más bueno es un sistema tolerante a fallos porque usa la alta
disponibilidad y además usa la replicación los datos suelen estar replicados con replicación 3 en el hd fs que es el sistema de almacenamiento de hadoop de forma de que si un nuevo cae vale pues tendremos el dato en el resto de nodos y por último y no menos importante es que es un proyecto open source un proyecto de código abierto bueno cuál es la arquitectura básica que sigue a duch bueno pues en hadú se distinguen 44 módulos principales el común y utilities el yang el h de fs y los procesos back reviews con el common
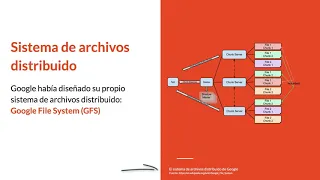
utilities lo forman todo todos los casi todas las librerías que son necesarias para ejecutar hadoop el yang es el gestor de recursos de hadoop como hemos dicho en hadoop es un sistema distribuido en distintas máquinas por lo cual debe de haber un gestor de recursos que vaya gestionando estos durante en todas las máquinas luego tenemos el h de fs este es el sistema de archivo distribuido de hadoop este sistema de archivo está instalado en cada uno de los nodos de nuestras máquinas y los procesos más reviews de arriba siempre siempre se apoyarán en el hd
fs para poder los datos para realizado para poder para realizar el procesamiento bueno y por último como hemos dicho los procesos más reviews esto es es un sistema es una manera de implementar el software vale que lo que conseguimos es para realizar de nuevo los datos siempre vamos a al mismo fin en la paralización de los datos entonces tendremos crear unos procesos más y unos procesos reviews de forma que primero iremos agrupando los datos y luego haremos cálculo con esos grupos de datos todo esto lo veremos durante el curso y como hemos dicho la configuración
habitual de hadoop es tenerlo en un clúster de máquina de forma que tengamos una máquina maestra y tengamos en máquinas esclava la idea es que la máquina maestra gestionada todas las tareas y las enviará a las máquinas esclava esas máquinas esclava van a realizar todo el procesamiento de los datos y finalmente terminarán informando de nuevo a la máquina maestra bueno qué opciones tenemos para trabajar con hadoop bueno pues tenemos tres opciones la primera de ellas es microsoft azure microsoft azure es una es un servicio que nos proporciona microsoft y que nos permite tener nuestras máquinas
en la nube vale tendríamos nuestras máquinas en la nube y pagaríamos según según la cantidad de máquina que tengamos y las características de las máquinas es un sistema bastante bastante interesante bueno luego tenemos horton works en la última distribución que ha salido acerca de hadoop que bueno con heart of words nos podemos lo podremos descargar una máquina virtual que abrimos con un cliente de virtualización y tendremos toda la todo nuestro sistema sadous instalado con todos los servicios y por último que la que utilizaremos en el curso tendremos cloudera cloudera fue la primera distribución acerca de
acerca de hadoop igualmente nos permite descargar una máquina virtual con la cual podremos gestionar todo descargamos la máquina virtual que abrimos con un cliente de virtualización y ya tenemos todo hadoop instalado y también tenemos la cruz de la manager que es un asistente para gestionar todo el clúster de máquinas y bueno esto es todo nada os animo a continuar con el curso porque creo que va a ser un curso bastante interesante en el que vamos a poder implementar big data y crear el proceso de map review [Música]