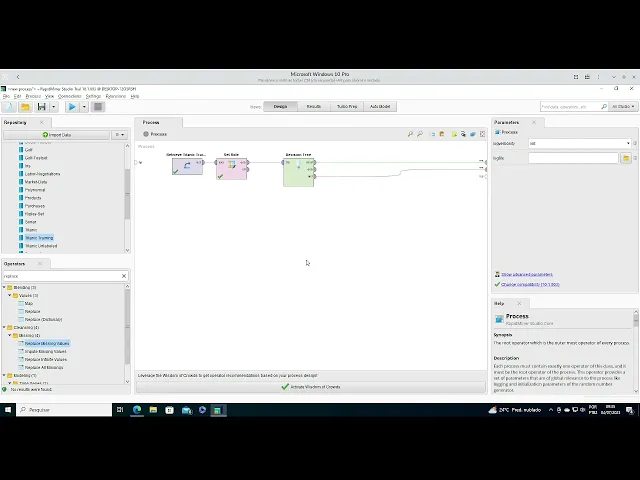
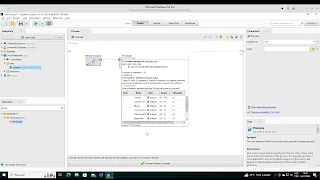
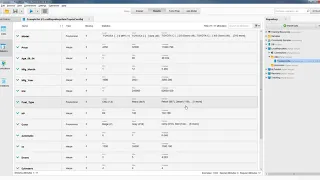
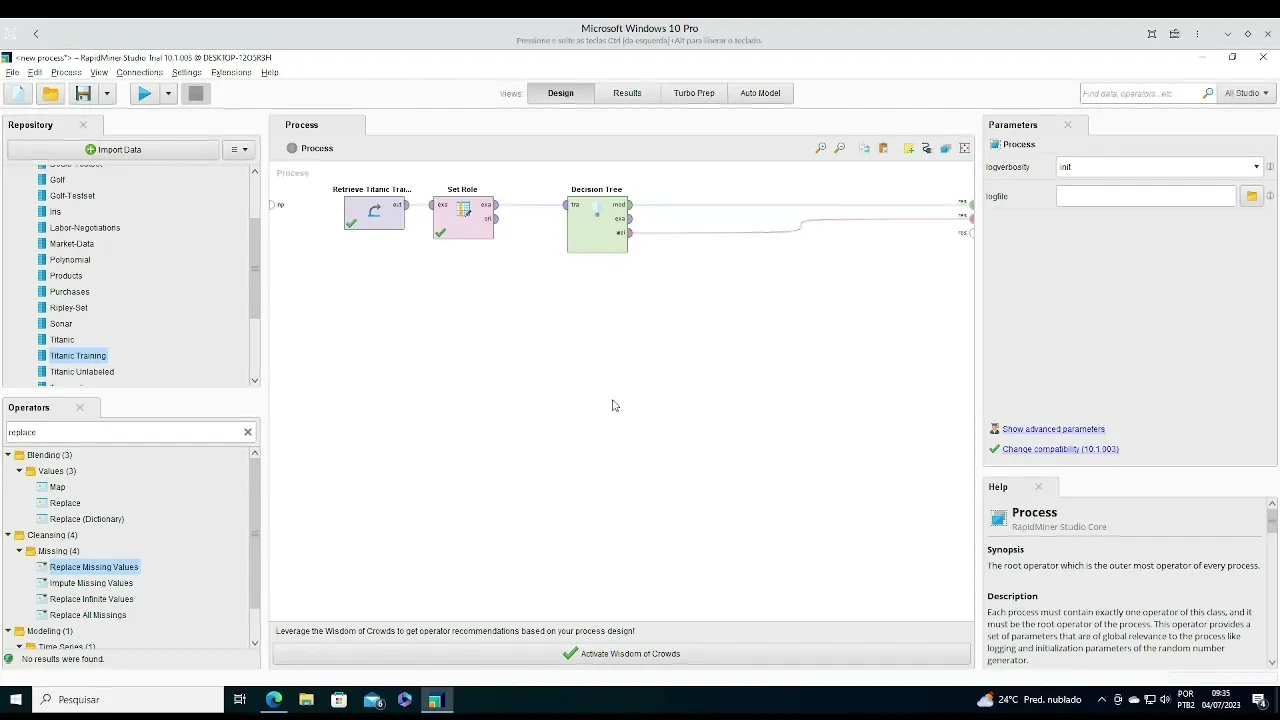
Olá pessoal tudo bem então dando continuidade a nosso vídeo tutorial nós vamos construir agora um modelo preditivo usando algoritmo de árvore de decisão e não só gerar árvore vamos começar gerando a árvore Mas além de gerar árvore nós vamos também aplicar nosso modelo preditivo e avaliar Qual a performance desse modelo então primeiro passo quando se quer construir um modelo é ter em mente os dados né De onde nós vamos extrair esses dados então é nós temos aqui um conjunto de bancos de dados digamos assim que já acompanha a o rappermain e esses bancos de dados de exemplos né Nós nós temos disponíveis até para testar para construir estamos usando os diversos algoritmos disponibilizados tá então aqui em cima nessa nesse primeiro quadrante nós temos o repositório tanto o repositório pessoal que é o repositório que por enquanto tá vazio né o local que nós não construímos não importamos nada E também temos repositórios de exemplos e demonstrações né outros disponibilizados pela comunidade né então tem repositórios disponibilizados por usuários como nós e estão colaborando com a comunidade de mineração de dados e outros que já são disponibilizados nativamente pela própria ferramenta também como teste né Nós na nossa aula usamos tanto o banco de dados e eles questões de acuidade visual Aquela aquele banco de dados Oftalmológico nós usamos na aula e também do Titanic então nós temos aqui dois bancos de dados né três com o que não tá rotulado digamos assim mas a base de treino e a base total do Titanic Então nós vamos reproduzir o que fizemos na aula o primeiro passo é recuperar o banco de dados então se eu quero recuperar um banco que já existe em um dos repositórios é só arrastar Lembrando que o rap de Miner é uma ferramenta completamente visual baseado em Componentes e apela né para essa essa visão gráfica né A modelagem gráfica do sistema de mineração de dados então eu vou arrastar aqui o Type Training nós temos Já o nosso banco de dados Claro se o banco de dados não estiver no repositório ele precisa ser importado foi o que nós fizemos com a planilha Excel no segundo exemplo da aula Nós faremos isso aqui no nosso terceiro vídeo né então é recuperamos o nosso banco de dados Lembrando que não tem nenhuma interface requerida ele já funciona né do jeito que está e ele já tem uma saída então a saída dele né se a gente colocar aqui na área externa né e executar nosso modelo a gente começa a enxergar o que tem no banco de dados tá então é só recapitulando também para quem né não tava na aula é temos aqui uma coluna que a coluna com o resultado desejável de previsão no nosso caso né se sobreviveu sim ou não então as demais colunas são critérios por exemplo a idade né Em qual classe tava passageiro o sexo dele se ele tinha acompanhante digamos assim se pais e filhos também estava a Bordo e a taxa que ele pagou eventualmente pela passagem então nós temos esses dados e nosso primeiro passo lembrando é escolher Já que é um algoritmo de previsão não algoritmo preditivo ligado a árvore de decisão então ele precisa ter um atributo alvo Qual é o atributo que eu quero prever que na nomenclatura de deita mais a gente chama de Label Então qual é o Label da minha previsão o que é que eu quero rotular na minha previsão Então o que eu quero rotular é a sobrevivência né se sobreviveu ou não então a gente precisa de um componente né aí os componentes ou os operadores são disponibilizados nessa parte de baixo categorizados para que a gente possa possa encontrar nós temos aqui né dezenas de componentes em cada categoria então o componente que nós precisamos é para definir do papel do atributo ou Row do atributo Então existe um componente chamado 7 Row mas nós podemos buscar para ficar mais mais simples tá ligado a atributo e esse rolo é o que nós queremos fazer com esse banco de dados então ele espera como entrada o banco de dados até aproximar um pouco mais e ao clicar nele a gente pode definir os papéis então o único papel especial que nós queremos definir é o do Survival isso Survival vai ser Label então nós já definimos isso daí né dessa maneira e é uma vez já tendo atributo Label o atributo alvo da previsão da previsão das regras então nós podemos escolher qual algoritmo de previsão de classificação preditiva nós queremos que no caso é um decisão Tree tá então nós arrastamos mais uma vez Lembrando que todos esses algoritmos são disponibilizados pela pelo ueca o rap de Maio usa essa biblioteca o eca que a Biblioteca gratuita de código aberto mas a facilidade que a ferramenta proporciona para usar essa biblioteca vale a pena né E nós temos aqui a saída o modelo que a árvore decisão esse Hexa é a mesma saída do 7 Row quer dizer ele propaga né a mesma tabela se eu quiser ver a tabela de dados eu posso ligar aqui fora e aqui o Whey que é foi o peso que o The Sims o algoritmo de árvore decisão deu para cada atributo na hora de construir árvore de decisão a importância que ele deu a cada atributo Lembrando que não é ainda o ganho de informação é o information ninguém o information Gain nós vimos na aula é o quanto um atributo ajuda né a apodar a minha árvore aí eu ter uma convicção se sobreviveu ou não sobreviveu Então qual atributo mais relevante para tomada de decisão aí eu information Gain aí esse esse peso da árvore decisão não leva em consideração só o information Gain ele leva em consideração também toda a topologia da árvore aquele que vai fazer uma árvore mais curta ou mais estreita ou mais larga depende do algoritmo né de classificação nesse caso daí do algoritmo desse junto aí ele tem seus critérios né de cumprimento e também de largura da árvore para definir os pesos do atributo Então são duas saídas que foram setadas aqui a própria árvore decisão é o próprio modelo preditivo da árvore de decisão e o peso então quando a gente executa nós temos aqui né o peso foi o Que Nós ligamos ao primeiro que é exibido né e a árvore de decisão que nós geramos aqui tá então nós temos essas duas saídas digamos assim tá lembrando que a árvore decisão ela precisa ser validada por um especialista né Afinal de contas a gente sabe que mineração de dados exige interação exige repetição né não é simplesmente saiu e o assunto que isso é uma verdade porque a gente sabe que a natureza dos dados pode implicar em conclusões precipitadas então a gente precisa analisar e não é muito fácil de analisar do jeito que tá aqui né Afinal de contas O que é relevante só com esses pesos aqui eu tenho uma ideia mas eu preciso de conhecer o ganho de informação Então até que ponto eu ganhei a informação Qual atributo mais relevante Será que todos esses são realmente relevantes por exemplo nós vimos na aula e aqui no peso dado pela árvore de decisão né foi até dar um peso de 20% um peso considerável para o preço da passagem Mas será que é relevante considerar o preço da passagem a gente sabendo que teve passagens doadas em todas as classes primeira segunda terceira classe tinha passagem com preço zero então será que o preço é realmente relevante ou não né então nós precisamos de uma opinião do Especialista e não sendo nós podemos fazer a filtragem como nós fizemos né Será que o nosso dado tá tratado Claro no nosso caso está tratado né mas se ele não tivesse tratado e tivesse Campos vazios né O que fazer com os campos vazios Então tudo isso precisa ser feito antes como pré-processamento claro que nós vimos que dá para fazer parte do pré-processamento pelo menos o mais básico aqui direto no por exemplo ele tem componentes do tipo Place Missing vai a luz então replay se tivessem né atributos que precisassem ser preenchidos eu poderia fazer um caminho que passasse pelo componente replace E clicando no componente eu configuro o que fazer né então o que é que eu vou fazer com os atributos faltantes atribuir a média daquela coluna eu atribuo zero eu atribuo um valor fixo né e eu vou fazer isso com todos os atributos ou para fazer só com uma coluna não vou fazer só com a coluna idade pronto a idade eu vou colocar a média por exemplo ou poderia colocar sei lá né A idade mais avançada a idade menor ou zero mesmo sei lá eu poderia dizer o que fazer e colocar vários componentes no Play sem isso sem velas na sequência um para cada atributo mas nesse caso o dado já está tratado porque já foi feita a engenharia de dados que vocês viram aí foi o que eu comentei na aula inclusive sem sem querer né falsamente puxar sardinha para nossa disciplina mas a engenharia de dados é mais importante do que a análise de dados no sentido de que é a qualidade dos dados que vai dar veracidade análise nada adianta a gente gerar a gente minerar gerar uma árvore decisão modelo preditivo bem legal mas que tá baseado em dados falsos em dados inconsistentes então é importante né a qualidade dos dados é fundamental mesmo tá joia então é para que a gente possa validar essa árvore decisão a gente precisa do Information ninguém então qual o ganho de informação de cada atributo dessa árvore Então existe um componente que é o peso pela crença né O que ele ajudou a você acreditar numa conclusão entende né então esse esse White que é o nome do componente né então é o componente que calcula o ganho de informação né o information Gain então do mesmo jeito que a gente usou a árvore decisão né O que entra na árvore decisão precisa entrar também no information Gain afinal de contas a natureza dos dados é a mesma para os dois então já tenho que ter o Label né eu envio esses dados tanto para árvore de decisão como para calcular o ganho de informação de cada atributo Tá então vamos lá eu vou puxar para cá ele aparentemente substituir Mas eu vou pedir para ele colocar o t para poder ligar a ambos Então eu tenho agora tanto o ganho de informação quanto a árvore decisão ligados aos dados então eu vou ter agora três saídas a saída que a árvore decisão em si uma segunda saída que é o peso dos atributos dado pela árvore e o terceiro que é o peso efetivo ordenado por ganho de informação especifica Então vamos lá rodando e nós temos aqui ó por ganho de informação vemos que é o atributo mais relevante né extremamente relevante foi o sexo claro que a gente sabe que é de praxe em salvamento né é priorizar mulheres e crianças Então realmente né seguiu-se protocolo nesse sentido fica evidente isso daí então nós precisamos passar esses atributos né esse esse ganho de informação para um especialista e ele vai nos ajudar a validar aí nós usamos uma hipótese na nossa aula que alguém inclusive foi um de vocês que questionou Olha pode ser que não faça sentido considerar o preço da passagem eu concordo então a gente pode desconsiderar esse atributo para que ele ajude a gente a construir o modelo digamos assim o modelo mais coerente mas realista então existem outros componentes como por exemplo select atributos E aí a gente pode fazer uma triagem desses atributos pré-seleção claro que a seleção pode ser feita antes ou depois do 7º não tem diferença desde que ela seja feita né então eu vou pedir para selecionar atributos e depois da seleção eu vou atribuir o papel deles então a seleção da tributos eu cliquei nele aí a gente vai incluir todos os atributos ou inclui só os listados não vão incluir tudo então só vou excluir um atributo que vai ser o atributo peça interfere tá então esse aqui foi excluído Beleza quando a gente executar mais uma vez peça de fé já não tá fazendo parte nem do ganhando informação e nem da árvore decisão tá e decisão já não conta mais com aquele atributo e digamos que o especialista julgou coerente marido tem tem lógica O que foi achado aqui na mineração de dados então nós temos aqui o modelo preditivo tá e tendo o modelo preditivo como é que eu posso usar esse modelo então a gente vai digamos assim rechear um pouco mais o nosso diagrama aqui nossa nosso processo de mineração de dados para que a gente possa usar o modelo preventivo não só ver a árvore decisão então eu vou até tirar essas saídas para ficar mais limpa a saída né com menos coisas mas a gente precisa usar o modelo se eu quero usar o modelo eu vou usar o componente aplay móvel tá eu espero como entrada o modelo preditivo em si que é gerado pela árvore decisão da árvore decisão gera o modelo preditivo mas eu tenho que dizer o que é que eu quero prever Baseado Em quais dados né então eu tenho árvore decisão E eu preciso também de uma entrada de dados que tenha exatamente os dados que eu quero usar para prever Então vamos supor que eu vou usar o mesmo banco de dados que tá aqui tá mesmo banco de dados tirar botar um multiplayer mais para baixo né o mesmo banco de dados que eu gerei a árvore decisão que eu calculei o ganho de informação eu vou usar para aplicar E aí nós podemos colocar como como saída isso daí tá olha que ele tem também como outra saída o próprio modelo que ele recebeu se eu quiser enxergar a árvore decisão eu posso colocar daqui também né para ele externalizar a árvore decisão com as regras colocar só para ilustrar que a gente veja é a mesma árvore replicação Então tá aqui o nosso modelo preditivo e nós temos a resposta né então a coluna Survival são os dados reais né e a coluna prediction Survival é o que o algoritmo baseado nas regras geradas na árvore decisão achou que ia acontecer né então em alguns casos acerta em outros casos erra então Note que realmente a gente usa as regras e as regras Lembrando que são derivadas do percurso da raiz da Árvore até as folhas Então se o sexo o feminino e é o número de pais ou crianças abordam menor ou igual a 4. 5 Então vai vai seguindo até chegar em um sim ou não tá aí a gente pode analisar então percorrendo essas esses Ramos da árvore nós temos regras sexo feminino e isso aqui maior ponto 4. 5 então é não é o si então o Cia o caminho e o então é a folha que é a conclusão tá Então nesse caso a gente vê que em alguns casos Acertou em outros casos errou Mas qual a taxa de acerto então a taxa de acerto nós calculamos através de um componente performance e esse componente tem um diferencial nós vimos na aula que tem várias formas de calcular performance porque a performance vai depender da natureza do algoritmo Então o que é que eu quero calcular a performance é uma performance no algoritmo de classificação de regressão de ranking de Associação É o que então de classificação então o ritmo de classificação que é a natureza do algoritmo da árvore de decisão tá Então nesse caso eu não quero ver a saída da tabela né com as respostas sobreviver sim ou não né Eu não quero essa tabela eu quero que essa tabela seja usada na performance para ele calcular as estimativas estatísticas né quando eu acertei mais quando eu errei mais qual o percentual de acerto de erro então esse Lab vai entrar aqui tá eu quero enxergar a performance isso daí não vou nem precisar da árvore decisão só querem enxergar a performance então quando a gente roda ele vai rodar e vai me dizer olha eu consegui uma performance né de 77% para o sim de 85% para o não né então no caso do Quando Ele acreditou previu que não ia sobreviver ele acertou mais que quando Ele previu e acreditou que ia sobreviver Provavelmente porque amostra dos não Sobreviventes é maior então isso daí gerou um maior aprendizado como a gente pode tentar melhorar isso daqui fazer a sintonia fina né no nosso modelo da árvore decisão Note que a gente tá gerando muitas regras ó reggae por isso que a árvore ficou grande Até voltar a apresentar a árvore aqui na saída que eu gerar de novo árvore a gente vê que a árvore ficou grande né temos poucos atributos na planilha naquela tabela e mesmo assim ela ficou grande né então a gente pode refinar nosso algoritmo melhorando A confiança dele né então não quero a gente pode colocar até 0.
5 vou aumentar para 0. 3 por exemplo 0. 3 vamos rodar aí ele já gerou outra árvore decisão se a gente olhar o a precisão já melhorou um pouco 77% para o sim 85 para o não vamos mudar para 05 pronto o nosso máximo desse algoritmo então Note que a árvore agora tá mais enxuta de um lado e do outro lado parece que não enxugou tanto né mas ela melhorou um pouco mais ainda 86.
42 né no caso é bem É bem interessante né E em todos os que os que né É foram sim de verdade eu acertei em 76%, em todos os que eu Previ que era assim né eu acertei 77 pontos 55%. aqui tá efetivamente a precisão do algoritmo não porque Ele previu que era assim na maioria dos casos realmente Foi sim e em outros Ele previu sobrevivido e na verdade não sobreviveu então Acertou em 77 Quando Ele previu que era não em uma pequena parcela ele se confundiu errou visão mas na grande maioria ele acertou então a precisão digamos assim a performance do algoritmo para o não foi de 85. 5% agora Note que essa essa previsão ela tá usando a mesma base de dados para fazer tanto o treino quanto teste né tanto para gerar as árvores de decisão quanto também para testar a performance do algoritmo então a gente pode fazer uma quebra nesses dados né para poder dividir essa proporção né quanto da base de dados eu quero usar no meu treino né para gerar as regras e quanto eu quero usar no meu teste na aplicação do modelo então o treino entenda treino como o dado que entra na árvore decisão e entra na grande informação né o usar Qual é a base que eu vou usar para treinar o aprendizado de máquina para o machine learning aprender e Qual a proporção do banco de dados que eu quero descobrir a performance do algoritmo então é esse cara daqui que não pode ser igual ao restante tá então a gente vai dividir esse banco de dados né que sai já com o Label aqui o split data Então antes de entrar aqui ele vai entrar nos splicidade então eu vou dividir e depois que eu dividir uma parte vai aqui para cima um parque vai para cá e a outra parte vai para lá e volta beleza mas eu preciso dividir porque tá dando esses erros porque eu vou dividir baseado em qual critério Eu não disse ainda o que eu quero dividir então eu quero dividir 0.
8 80 para um lado e 20% para o outro então como eu criei duas dois ramos de dados duas dois conjuntos de dados eu posso ligar em dois lugares já não dá mais erro se eu fosse ligar um terceiro eventualmente aí esse aqui iria dar erro né A não ser que eu criasse mais um critério de divisão no lugar de 80 20 sei lá 702010 poderia ser tá Então nesse caso daqui a gente tá usando a proporção 80 vai para cima e 20 rodar antes de rodar tava 77,85 né pronto vamos agora rodar e ver que diminuiu provavelmente vai diminuir isso daí então 74 e 84 porque diminuiu diminuiu não foi porque é porque agora eu tô antes ele tava viciado ele tinha já tinha noção de quais eram os dados Como eram os mesmos dados Não não é por isso né tanto é que em alguns casos ele errou Mas é porque diminuiu o volume de dados do aprendizado então machine learning ele é Totalmente Dependente dos dados tanto é que a gente pode ficar brincando aqui vamos inverter 20 e 80 pronto caiu menos do que eu pensava até mas caiu para 72 e 80 ou não caiu bastante né ou não caiu bastante foi quem mais sentiu né digamos assim então quanto mais dados mas o algoritmo tende a aprender tá joia beleza 74 e 84 pois bem então essa aqui é o que eu queria né deixar para você e depois nós só para a gente fechar também com isso aqui nós vamos salvar aqui no nosso repositório local Então vou colocar de The Sims um algoritmo de classificação e aí construímos isso daqui já tá pronto e começamos a especular isso eu quisesse minerar agora com outro propósito não era outro banco de dados esse banco de Íris por exemplo E aí ele disse Mas qual é ele como é esse banco de dados Qual o objetivo da classificação já que eu quero usar árvore decisão Então vamos entender um pouco esse banco de dados Então tá aqui então se eu quero usar classificação Então eu tenho que ter um atributo alvo que é o meu Label e tentar deduzir o valor dele a partir dos demais então aqui nós é percebemos né Assim que o atributo Label também bem nomeado aqui para Label é o que classifica o diagnóstico da Íris né então se a Íris é cetosa vai ser colo e Virgínia e só então dentre essas três possibilidades Então a partir de provavelmente provenientes de algum exame sei lá há 1 a 2 A 3 A 4 é hipotético aqui mas sei lá espessura da córnea não é pressão do olho sei lá então aqui tem quatro dados provavelmente provenientes de exames e a partir daí a gente criar regras que ajude o médico para tomar essa decisão né que a gente possa dar um feedback para ele então o atributo que nós queremos classificar é o atributo chamado Label o ID já tá como chave então por isso que o algoritmo descartou vai se ele não tivesse descartado esse cara que com certeza precisaria ser descartado se o banco já não tivesse rotulado ele como chave né porque ele iria dar ser um atributo extremamente relevante seria de maior ganho de informação porque sabendo sabe a igreja de tudo né Ele é determinante é chave né então ele dizer não sabendo do CPF Você já sabe qual é a ilha do cara não mas não é lógico isso daí eu sei na base de treino porque o CPF tá associado a uma pessoa não é por exemplo mas aí sabendo que algo primitivo algo especialista é dizer logo olha descarta o CPF isso aí não é relevante E aí você considera só os demais só para ilustrar o que a gente precisaria aqui simplesmente é olha como é simples mudar e o roll dizer que o novo Row não é Survival que não tem né na tabela mas é Label pronto partir daqui nós podemos testar nosso modelo então para testar o modelo a gente tem que ver o information game Lembrando que não é simplesmente aplicar né a gente precisa validar com especialista para ver se tem besteira né então colocamos aqui e a gente descobriu que o peso foi dado dessa maneira especial pois bem então uma vez pronto nosso esquema fica relativamente simples nós ajustarmos para outras bases de dados é claro vou deixar até a saída sempre aqui do grande informação para que a gente possa validar a tabela eu vejo que tenho mais uma saída aqui essa saída é a árvore de decisão árvore decisão Eu particularmente eu não acho tão útil porque é difícil de validar direto olhando para árvore né Pronto acho que performance é relevante nesse caso daqui a previsão daí cetosa e daí eles Virgínia foi 100% e a previsão da vesícula por 90 90.