wir wollen das kapitel cash verfahren mit einem kurzen ausblick abschließen anfangen möchte ich mit so genannten dynamischen hash verfahren bisher hat nash funktionen immer mit einem statischen bild bereich also die tabellen größe m war fest vorgegeben bzw konnte nur im rahmen von sogenannten no we fashion geändert werden also wenn wir die tabellen größe ändern wollen in der regel vergrößern wollen müssen wir die ganze tabelle und kopieren so genannte dynamische hash verfahren erlauben wachsende auch schrumpfende bildbereiche ohne dass ich tatsächlich alles neu auf bauen muss ein bekannter vertreter davon ist das sogenannte extensible herrschen hier findet
dazu was im buch von gunter sachs auch in den alten ausgaben vom sedgwick schön beschrieben und external sotschi ohne dass wir hier auf details eingehen dieses extender hessing verbindet zwei ideen auf eine sehr nette art und weise grundsätzlich verwalte ich meine daten in einem 3 wobei ich ausgehe davon dass meine schlüssel bit weise gespeichert sind als sonst reißt kurz angeschaut haben haben wir schon gesehen auch die müssen nicht balanciert sein beziehungsweise wenn viele schlüssel gleiche teil folgen von zeichen enthalten dann kann sein dass bestimmte pfade in diesem 3 ja keine aussagekraft haben ich muss die
durchlaufen wohlig nicht neue schlüssel diskriminieren kann dass wir hier gelöst indem er nicht die schlüssel direkt in den drei einfügen sondern indem wir vorher die hash funktion auf die schlüssel loslassen die hash funktion sorgt dafür dass ja nicht nur meine indizes die dabei rauskommen möglichst gleich verteilt sind in sind von tabellen indizes sondern dass auch die 01 folgen in meinen schlüsseln dann möglichst so verteilt sind das meint 3 ausgeglichen ist wo kommt jetzt das dynamische hash verfahren noch mit rein die hash funktion bildet hier ab tatsächlich auf zahlen bis zu einer bestimmten zweier potenz und
die idee hier ist dass ich den wertebereich verdopple in dem ich immer dann wenn bei der datenstruktur voll ist noch ein bit dazu nehme das kostet mich nichts für alle daten die schon da liegen muss nur die hash funktion noch einmal auswerten ich kann die daten auch da liegen lassen wo sie liegen und die zweite die neue hälfte lege ich einfach dahinter also durch eine geschickte anordnung der daten muss ich bei diesem vergrössern und das werte bereichs tatsächlich nicht viel machen exzentrischen eignet sich vor allem für externe suchen also wenn meine daten auf einem externen
speicher liegen wo die zugriffszeiten mir weh tun ich kann das ganze auch wieder optimieren oder das bis in der regel optimiert für seitenzugriffe wie wir es auch bei den bäumen schon kennen gelernt haben mit extend the machine schaffe ich es tatsächlich im beliebigen daten mit mittel zwei seiten zugriffen und datum zu finden und gleichzeitig kann ich auch noch effizient einfügen das gilt natürlich die gleiche einschränkung die verfahren generell aber hier das stichwort datenbanken haben ich kann hier nur nach bestimmten schlüssel suchen ich habe keine sortierung meiner tagen stände beherrschen beide in der praxis tatsächlich verwendet
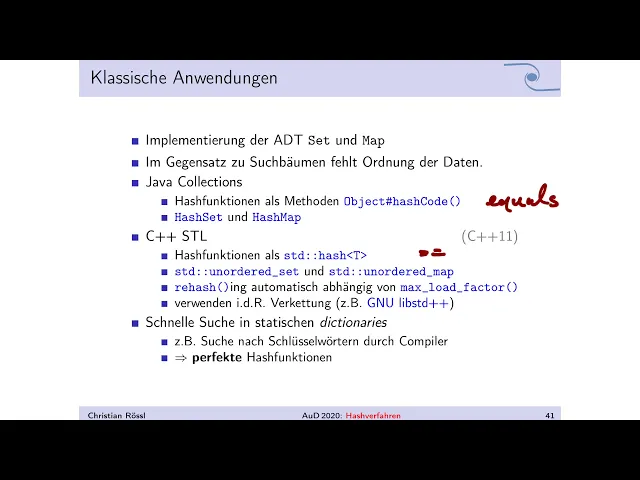
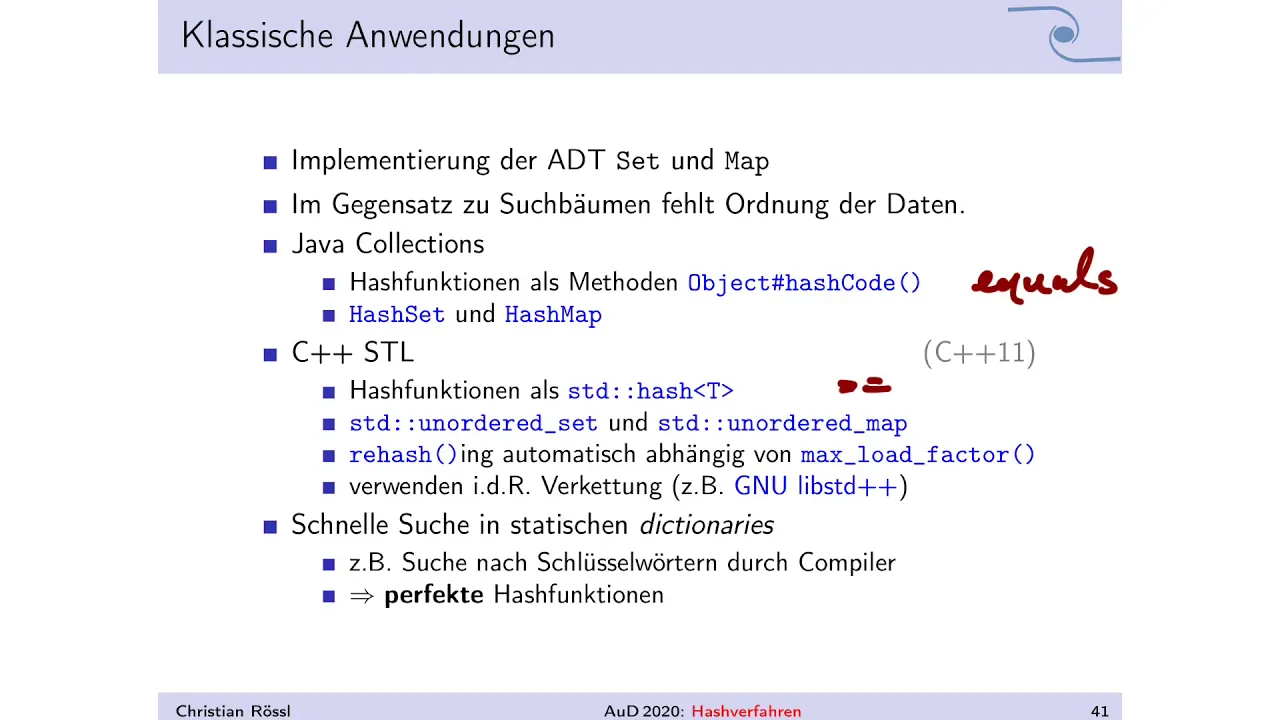
zum beispiel auch im dateisystem zu implementieren meines wissens wird es zb bei zfs verwendet zurück zur praxis wie man sehe jeden tag erleben die klassischen anwendungen für tabellen sind die implementierung von hat takten datentypen set oder web im gegensatz zu den such bäumen habe ich hier keine ordnung auf den daten das ist die große einschränkung die ich habe wenn ich das nicht braucht dann kann ich es tabellen verwenden ansonsten sollte ich lieber bei balancierten sucht bäumen bleiben in den java collections gibt es die headset und die häscher beide setzen voraus dass die objekte die ich
einfügen möchte die methode heschke sinnvoll definieren wichtig an der stelle ist hash code geht nicht alleine sondern wenn ich hesco definiert sollte ich auf jeden fall überprüfen dass auch equals definiert ist weil es reicht nicht den her schwer zu berechnen ich muss auch die gleichheit von objekten entscheiden können in c++ in der standard bibliothek in der standard template library stl gibt es selbstverständlich auch nicht nur cash funktionen sondern auch entsprechende datenstrukturen die heißen hier spd an oder z und spd an oder web also hier steht nicht das hashim namen nicht die implementierung sondern die eigenschaft
dass ich keine ordnung annehmen kann anders als in java kommen die herzfunktionen hier nicht als methode ich habe in c++ keine gemeinsame basis klasse für alle klassen sondern die hash funktion kommt von außen als der funktion tatsächlich etwas was so aussieht wie eine funktion als ein sogenannter funk tor er heißt ästhetisch und den kann ich für neue datentypen t entsprechend implementieren so wie ich das gerne hätte es gilt natürlich das gleiche aber auch wenn ich erst die hash für meinen daten tipp implementiert dann muss ich auch die gleichheits redaktion in c++ kann ich den operator
gleich neu definieren unter ungleich entsprechend konsistent neu definieren wenn ich es die ghs definiert muss ich auch die gleichheits relation definieren die stl datenstrukturen stoßen das wii hessing automatisch an und zwar abhängig von den maximalen lot faktor den ich angeben kann die implementierungen verwenden in der regel die verkettung der überläufer wer will kann einfach in den kopf schauen zum beispiel von der implementierung für den spezialfall dass ich eine menge von schlüsseln suche die statischen ist die sich nichts ändert ruhig diese menge einmal aufbauen kann oder die entsprechende datenstruktur einmal aufbauen kann und dann nur noch
suchen für diesen fall gibt es das sogenannte perfekt eching oder perfekte hash funktionen die ich konstruieren kann so dass es garantiert keine kollisionen gibt das geht allerdings eben nur unter der einschränkung dass die menge aller schlüssel apriori bekannt ist diese menge kann ich solche perfekten hash funktionen konstruieren das ist in der regel eine normale hash funktion und dann dann kollisionen noch weil durch tabellen behandelt so dass effektiv nicht stattfinden lohnend und solche ansätze immer dann wenn ich schnell so muss nach bestimmten dingen aber die menge der einträge in denen ich so muss immer gleich bleibt
ein paradebeispiel sind die schlüsselwörter der programmiersprache pascal für die gibt so eine hash funktion so dass ich dann für jeden string den der parser einliest oder den lexika scanner einliest entscheiden kann ist das ein schlüsselwort oder nicht bzw welches ist das und die entsprechende token nummer dann an den raser weitergegeben werden kann bisher ging es immer nur ums suchen in daten es gibt noch ganz andere anwendungen vom cash verfahren so genannte kryptographische verfahren verwenden den hash wert als eine art prüfsumme um daten abzusichern gegen manipulation oder auch um einfach festzustellen ob daten geändert worden sind
bekannte prüfsummen zum md5 oder auch die hsh familie md5 ist mittlerweile veraltet im sinn von es ist angreifbar oder nur die gebrochen auch einige aus der anderen familie sind erfolgreich angegriffen worden das klingt zu material martialisch an tatsächlich verwendet man solche prüfsummen aber ganz oft für sie harmlose aufgaben ich möchte einfach feststellen ob eine datei verändert worden ist oder nicht ich berechne die prüfsumme und wenn ich die datei nochmals berechne ich die prüfsumme einfach wieder und vergleicht die beiden prüfungen ich muss dann eben nicht die gesamte datei so wie sie war irgendwo speichern oder als
kopie halten sondern es reicht dass ich die prüfsumme halte oder ich möchte entscheiden ob zwei dateien gleich sind ich brauche von der einen eben nur die prüfsumme ich muss nicht zwei dateien einlesen dafür ist md5 zum beispiel völlig in ordnung tatsächlich werde ich zum beispiel auch die passwörter in der datenbank für den anmelder für den online-dienst für den webdienst verein reicht nicht im klartext speichern sondern was gespeichert wird ist ein sogenannter hash werte kommt bisschen mehr dazu um angriffe möglich schwierig zu machen auch hier ist aber eine hash funktion im spiel und was hier aus
genutzt wird ist die tatsache dass es sehr leicht es auf der einen seite die hash funktion auszuwerten also für ein gegebenes passwort die den hash wert zu berechnen oder für eine gegebene datei die prüfsumme zu berechnen dass es aber auf der anderen seite sehr schwierig ist für einen gegebenen hash wert und passenden passendes passwort zu finden google verdiene gegebene prüfsumme eine datei zu finden die genau diese prüfsumme hat und auch noch den sinnvollen inhalt hat je nach einsatzzweck haben diese cash verfahren oder hash funktionen auch noch ganz unterschiedliche eigenschaften wenn ich passwörter hessen will dann
benutze ich einen hash funktion wie betrifft zum beispiel die gleichzeitig auch noch relativ aufwendig und schwierig zu berechnen ist schwierig zu berechnen im sinn von der rechner muss tatsächlich eine gewisse arbeit reinstecken um einen hash wert zu berechnen so dass es nicht möglich ist beliebig viele herr schwerte in einer bestimmten zeit zu berechnen wieder andere anwendung sind sogenannte blumen filter das ist eine probe ballistische da struktur wo ich tatsächlich nicht einzelne einträge speicher sondern jeweils nur einzelne bits also ja nein informationen speichere in einer tabelle speicher um fragen beantworten zu können wie ist ein eintrag
jemals ein geworden eingetragen worden in die tabelle oder nicht die idee ist ganz einfach ich habe einfach eine tabelle mit bis diese am anfang alle 0 und jeder eintrag die nicht einfüge bedeutet ich berechnen erschwert und setzt das entsprechende bitte auf 1 und das mache ich nicht nur für eine tabelle und eine hash funktion sondern ich mache das für mehrere tabellen und mehrere funktionen also jeden eintrag füge ich in mehrere dieser tabellen 1 wenn ich jetzt wissen möchte ob der eintrag eingetragen würde dann prüfe ich einfach nach ob in allen tabellen an der entsprechenden position
also die initiative die jeweilige hash funktion liefert eine 1 steht was weiß ich dann dann weiß ich dass dieser eintrag eventuell eingetragen wurde wurde es könnte noch ein anderer eintrag sein der auf die gleichen indizes es gibt der kollisionen dadurch dass ich mehrere funktionen verwende mache ich das aber unwahrscheinlicher also ich weiß dann der eintrag wurde mit einer gewissen wahrscheinlichkeit die ich auch berechnen kann eingetragen wenn ich irgendwo und befinden das 0 ist dann weiß ich definitiv dass dieser eintrag nicht eingetragen wurde pro babbel ist es bedeutet hier ich kann sicher entscheiden dass ein eintrag
nicht eingetragen wurde ich kann mit einer gewissen wahrscheinlichkeit entscheiden ob ein eintrag eingetragen wurde oder nicht und je nachdem wie hoch diese wahrscheinlichkeit ist brauche ich größere tabellen mehr funktionen mehr daten oder umgekehrt wenn ich mit kleineren wahrscheinlichkeiten zufrieden bin dann brauche ich entsprechend weniger speicher bedarf also ich kann diese datenstruktur verwenden und große datenmengen zu speichern oder aproxima tief zu speichern kann dabei stark komprimieren die letzte anwendung ist hier das sogenannte special hessing hier geht es darum geometrie die sich in einem teilgebiet des 2d oder 3d raums befindet zu kodieren also zu entscheiden wo
befindet sich denn ein bestimmtes objekt interessant kann das sein zum beispiel für die physik simulation wo ich verschiedene objekte hat und entscheiden muss ob die kollidieren die nahe genug zueinander sind es gibt viele datenstrukturen um solche nachbarschafts anfragen effizient durchzuführen special caching hat den vorteil dass sich die objekte sehr schnell einfügen und löschen kann und bei so einer physik simulation bewegen sich viele der objekte das heißt ich muss die datenstruktur immer wieder auf den neuesten stand wie funktioniert das die idee ist dass ich die objekte im diskrete zellen einsortiert das können sehr sehr viele sein
wir können uns das vorstellen wie koordinaten und für jede koordinate habe ich eine kleine box und wenn das objekt sich in dieser box aufhält oder diese box schneidet dann merke ich mir die entsprechende koordinate jetzt schon es gibt sehr viele solche zellen tatsächlich sind aber nur relativ wenige durch objekte belegt und jetzt ist hier die idee dass wir tatsächlich nicht harry von zellen speichern sondern dass wir die zellen die tatsächlich belegt werden sind deren koordinaten nehmen und durch eine hash funktion abbilden wieder auf ein lineares harry also wir tragen der tatsache rechnung dass von allen
möglichen zellen nur sehr wenige belegt sind in so einer physik simulation zb im computerspiel würde man auf die art und weise testen ob zwei objekte in der gleichen zelle sind oder in benachbarten zellen also ob sie sich potenziell berühren ob sie kontakt haben das überprüfe ich über die special hash datenstruktur und wenn das der fall ist dann rechne ich noch mal nach wo sind denn die kontaktpunkte berühren sie sich tatsächlich welche kräfte wirken entsprechend wenn man sich vorstellt zwei objekte prallen aufeinander und stoßen sich dann danach ab und so weiter und so fort die special
staaten struktur ist hier von vorteil wie gesagt weil sie sehr schnell ändern kann wenn man noch mal alles zusammenfassen beim cash verfahren oder bei der suche mit hilfe von resch tabellen geht es darum dass wir schlüssel direkt abbilden auf adressen das sind indiz es in felder diese abbildung wird übernommen von der hash funktion wir wissen dass diese hash funktion nicht eins zu eins aktiv sein kann denn es gibt sehr viel mehr mögliche schlüssel als mögliche adressen in der tabelle sollte nicht zu groß werden und kann auch nicht beliebig groß werden deswegen wird's kollisionen geben und
wir müssen irgendwie mit den kollisionen umgehen können wir haben uns dazu die verkettung der überläufer und offene adressierung verfahren wie zum beispiel im jahres und die ehrung angeschaut cash verfahren erlauben in der praxis einfügen suchen und löschen in konstanter zeit wir dürfen dabei davon ausgehen dass der schlechteste fall wir brauchen tatsächlich den jahre zeit sehr unwahrscheinlich ist warum man dann nicht immer cash verfahren im gegensatz zu räumen habe ich hier keine konten auf den daten also ich kann zwar abstrakte datentypen set und map implementieren aber ich kann die daten zugeordnet ausgeben ich kann keine bereiche
geordnet integrieren ich kann auch nicht nach bereichen von besuchen bei hess funktionen müssen wir schauen dass wir dinge richtig machen bzw können wir einiges falsch machen wichtig ist hier wir müssen sinnvoll der hash funktion wählen und gegebenenfalls auch parametrisieren wir müssen immer aufpassen dass der füllgrad niedrig genug bleibt ansonsten verlieren wir diese eigenschaft dass wir in konstanter zeit suchen können dazu müssen wir den füllgrad gegebenenfalls wieder anpassen drücken und das geschieht indem wir die daten in eine neue tabelle in eine größere tabelle einfügen dass es dieses sogenannte beherrschen es gibt noch viele weitere varianten von
aesch funktionen und implementierung verwendung von herstellen es gibt noch viele weitere anwendungen von cash verfahren allgemein ein paar wenige haben wir noch mal kurz skizziert tatsächlich sind hash tabellen in der praxis eine der wichtigsten daten strukturen überhaupt und wie gesagt meiner meinung nach eine der datenstrukturen die ihr mit hoher wahrscheinlichkeit auch mal selber implementieren müsst