[Musique] bonjour à tous une petite mise au point donc sur les déroulé de secours je m'excuse d'avoir dû annuler le cours de la semaine dernière donc cette semaine nous parlerons du lexique mentale la semaine prochaine je vous parlerai donc ce sera le dernier cours de la série je vous parlerai de l'apprentissage des règles grammaticales chez l'enfant et on repoussera la Question de la théorie de l'esprit à une autre année sans doute et dans quinze jours savez probablement que le séminaire cette année a lieu sous forme de colloques donc vous êtes tous invités si vous le
souhaitez à participer à ce colloque international qui seront en anglais et auquel participent de nombreux collègues qui portera sur la représentation des nombres de l'espace et du temps en célébrant une petite découverte qu'on avait fait il ya Quelques années qui est l'existence de liens entre les nombres et l'espace en particulier donc ce sera un colloque d'une journée le programme est affiché à l'extérieur et si vous souhaitez y participer il est préférable que vous inscriviez pour qu'on puisse tout simplement prévoir suffisamment de pause café etc donc n'hésitez pas inscrivez vous il ya une adresse internet qui
est qui est prévu pour cela sur la fiche qui est à l'extérieur Voilà alors donc aujourd'hui nous allons reprendre le cours sur le cerveau statisticiens sur l'idée que le bébé compile des statistiques sur le monde extérieur et nous allons parler d'une phase absolument extraordinaire de la vie de l'enfant qui démarre à peu près au milieu de la deuxième année de vie et qui est ce qu'on appelle l'explosion lexical c'est-à-dire le moment où l'enfant peut être manifeste de façon la plus visible ses compétences Statistiques dans la mesure il se met à apprendre à une vitesse remarquable
le lexique de sa langue on estime que l'enfant à cette période apprend facilement entre 10 et 20 mo par jour ce qui suppose donc ils les apprends avec une quantité de données extraordinairement faible et peut-être on peut l'illustrer ici par ce célèbre tableau de la vierge ou lapins n'imagine que la vierge dit le mot lapin à l'enfant et l'enfant enregistrent Immédiatement que ce mot ce serait faire cet animal particulier mais les philosophes ont été nombreux à souligner les graves problèmes que posent l'apprentissage du lexique chez l'enfant d'abord il faut imaginer donc un espace extraordinairement vaste
de mots possibles et seulement certaines séquences sont des monts mais peut-être il ya quelques dizaines de milliers de mots qui appartiennent à notre lexique mentale chez l'adulte facilement les Estimations sont blancs de plusieurs dizaines de milliers de mots deuxièmement il ya un espace de référents encore beaucoup plus vaste pour ses mots et lorsque l'enfant est exposé à un mot particulier comme le mollah peint ici et bien le nombre de références possibles pour ce mot est tout à fait considérable et pourquoi est ce que l'enfant apprend que le lapin c'est l'animal tout entier plutôt que ses
oreilles ou le petit bruit qui fait Ou la manière qu'il a de bouger l'apprentissage des vernes antilles est déjà effectif pose des difficultés particulièrement considérable et l'apprentissage des termes déictiques par exemple est un problème tu as fait intéressant dans la mesure où l'enfant par exemple en temps le terme mois systématiquement prononcé par quelqu'un qui fait référence à lui même et non pas à l'enfant évidemment donc il ya des ya Des problèmes de référence dans le domaine de l'apprentissage du lexique qui sont à fait particulier alors nous n'allons pas parler de tous ces problèmes aujourd'hui vous
aurez simplement parler de certains aspects de l'apprentissage des noms et dans une deuxième partie du cours d'aujourd'hui je parlerai de l'accès au lexique chez l'adulte en essayant de vous montrer que dans les deux cas l'idée que le cerveau Fonctionne meilleur baneza yens qu'il raisonne sur des hypothèses et qu'il met à jour la probabilité de ces hypothèses en fonction de ses entrées rencontre d'une somme grande part finalement de ces données à la fois sur l'apprentissage et sur l'accès au lexique nous partons du cours précédent et nous avions vu déjà que l'enfant francis est dans la première
année de vie un certain nombre d'étapes qui lui permettent Finalement de mettre en rapport les mots avec les objets au cours d'éco précédent nous avions vu que les enfants dans la première année de vie était sensible aux statistiques de leur environnement et en particulier sur le plan auditif il ya quinze jours nous avions vu en détail un certain nombre d'expériences qui montrait que l'enfant était capable de prendre une série de syllabes et d'utiliser les probabilités de transition pour le tronçonner en quelque Sorte en mots plausible donc les mots qui reviennent fréquemment fournissent par le simple
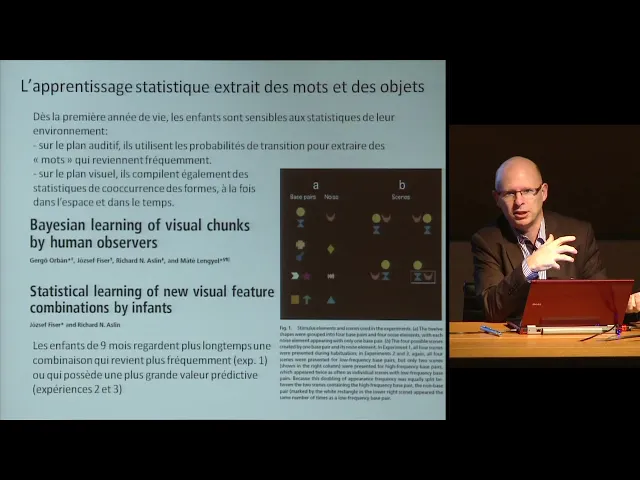
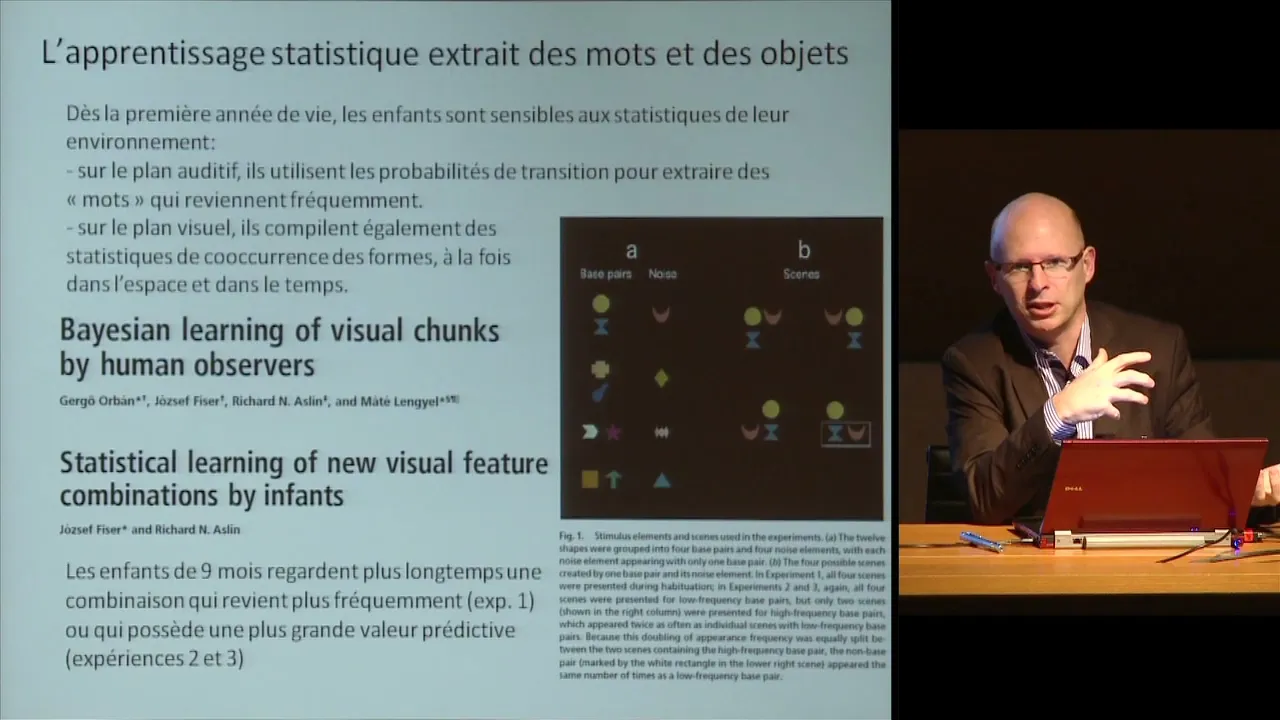
fait que les des syllabes se succèdent avec des probabilités plus élevées à l'intérieur des mots que entre les mots fournissent donc des candidats pour le lexique mental est ce que je n'avais pas dit je devrais le mentionner simplement en une diapositive c'est que il semble bien que sur le plan visuel le cerveau de l'enfant compile également des statistiques de co occurrence des Formes de la même manière à la fois dans l'espace et dans le temps je vais parler un petit peu de l'apprentissage des visages dans lequel par exemple le fait qu'on reconnaisse le même visage
de profil et de phase peut être vu comme un apprentissage séquentielle dans le temps mais il ya des données tout à fait similaire est en fait inspiré d'ailleurs des expériences plus précoce de jennifer safrane sur l'apprentissage du langage qui montrent Que l'apprentissage visuel s'appuie apparemment sur des statistiques de cocu rance des différents aspects de la forme des objets ici je met en valeur les recherches de joseph pfizer fisher n'est pas très sûr comment se prononce le nom de ce chercheur hongrois qui sera écrit charasse line et qui a effectivement réalisé des expériences tout à fait
parallèle à celle qu'on avait vu il ya quinze jours sur l'apprentissage des groupes de syllabes dans lequel on Présente des scènes et ces scènes sont formés soit d'objets élémentaires soit d'objets composite qui peuvent être formés par exemple d'un disque jaune et d'un diabolo bleus et les expériences montrent que l'enfant est sensible au fait que certains de ces objets reviennent de façon périodique assembler ensemble comme on le voit ici donc dans toutes les scènes de droite le disque jaune est au dessus du diabolo bleus et les expériences montrent que dès la Première année de vie les
enfants vont être capables d'utiliser les informations statistiques présentées par ces scènes visuelles pour ensuite lorsqu'on présente les objets en isolation répondent de façon préférentielle et regardez donc plus longtemps toujours cette méthode de durée du regard regardez plus longtemps les objets qui sont revenus plus fréquemment dans les scènes de départ il s'agit pas juste de la fréquence de Concurrence mais il s'agit vraiment d'une information sur la prédictabilité 2 d'une forme le fait qu'une une des formes élémentaires le disque jaune prédisent le diabolo bleus puisque on peut par exemple le rendre cette scène la plus fréquente mais
ça m'est donc augmenter la fréquence de cette disposition là mais comme dans d'autres scènes elle n'est pas prédictive et bien l'enfant ne va pas apprendre ce type d'objet évaluant contraire à prendre L'objet qui revient le plus souvent donc je rende pas dans le détail de ces expériences elles sont tout à fait parallèle aux expériences qui ont été menées dans la modalité auditive elle nous suggère que court la première année de vie modalités par modalités aussi bien aussi sts au sein du système visuel qu'au sein du système auditif le cerveau de l'enfant créé des objets sacrés
des paquets d'informations paquet de syllabes des paquets de formes qui Sont des objets récurrent dans l'environnement et on peut imaginer donc d'un côté on a des candidats pour des maux du lexique et de l'autre côté on a des candidats pour la référence de ces monnaies les objets du monde extérieur et je vous avais montré une expérience qui faisait le lien entre ces deux fonctions c'était cette expérience donc jennifer safrane où elle montrait que non seulement l'enfant était capable d'extraire débit syllabes qui revenaient Fréquemment dans une liste de syllabes sur la base des probabilités de transition
donc ma knocking at il même anneau de buman au team epigat debout très vite l'enfant repères que le team est est un des mots de cette série mais elle montrait dans cette expérience que si ensuite on présente des objets à l'enfant et on les accompagne de cbe sylla particuliers qui sont revenus fréquemment dans la séquence de départs et bien l'enfant apprend beaucoup plus Facilement le fait que c'est be seen l'absurde étiquettes pour les objets correspondant alors que si d'autres by syllabes sont présentées en même temps que d'autres objets mais ils n'ont pas fait partie de
la série de départs l'apprentissage ne se produit pas donc quelque part les statistiques intra modalités facilite ensuite la mise en conjonction des mots avec les choses auquel il se réfère j'ai l'expérience est assez remarquable tout de même Puisqu'il ya toute une série d'apprentissage qui doivent se produire les objets eux-mêmes sont nouveaux jennifer safrane n'insiste pas tellement là dessus dans son article parce qu'elle s'intéresse à la partie linguistique de cet apprentissage mais l'enfant a aussi dû apprendre quelque chose sur cette conjonction particulière de forme qui tout à fait une nouvelle et particulière et que l'enfant a
pris en quelques secondes en quelques minutes associé à La forme particulière du motivés donc un espèce de double apprentissage qui se produisent alors ce qui va nous occuper dans le cours d'aujourd'hui c'est 7000 aux mises en liaison assez haut niveau entre les formes des mots et les référents correspondants et je m'appuierai sur un article de fait chaud et josh tenenbaum qui sont maintenant je pense des chercheurs que et qui sont devenus familiers puisqu'ils ont des personnages ça fait sans trop de cette Théorie bayésienne de l'apprentissage qui nous propose donc dans un article de sakho logique
que le review en 2007 une théorie bayésienne de l'apprentissage des mots il commence par listé un certain nombre de phénomènes qui sont en quelque sorte les piliers empirique de l'apprentissage des mots et dont ils vont essayer de rendre compte ensuite mais qui ne sont pas faciles finalement rendre compte dans d'autres théories Premièrement il est frappant que le sens des mots soit a pris par l'enfant sur la base d' extraordinairement peu d'exemples parfois un seul exemple je pense qu'on en connaît tous les cas parfois quelques exemples deuxièmement les exemples positifs suffisent l'enfant n'a pas besoin d'être
corrigés où on n'a pas besoin de lui dire ça ça n'est pas un chien s'il suffit de lui présenter des exemples positifs Troisièmement ça n'est pas un simple étiquetage j'en ai peut-être donner l'impression depuis le départ de cet exposé c'est beaucoup plus compliqué que ça puisque le même objet on peut y faire référence avec des mots extrêmement différents si vous prenez un chien par exemple je peux dire ah c'est un chien je peux dire aussi ce temps dalmatiens c'est un mammifère et suivant le contexte on va utiliser des registres de mots extrêmement différent donc l'enfant
Apprend à partitionner le monde à des degrés de granularité différents et chacun de ces degrés de granularité va avoir des mots différents troisième quatrièmement nous disent tout et tenenbaum l'apprentissage et graduelle et les inférences sur le sens des mots sont gratuits alors c'est peut-être un petit peu moins intuitif parce qu'on a le sentiment qu'un mot est attaché de façon discrète un sens mais si vous réfléchissez à certains des mots Que vous connaissez vous en avez une idée c'est vrai assez approximative ce je lisais récemment houellebecq et il y avait le mot bichon qu'est ce que
c'est qu'un bichon alors je me suis demandé quel était le sens que je pouvais attaché à ce mot là je sais que c'est un chien je sais que ces problèmes en un petit chien family etc mais je n'avais aucune idée concrète visuel du référencement je pense que c'est le cas pour de très nombreux maux Effectivement que le sens qui s'y attache et probabiliste on va voir dans une seconde que effectivement il expériences qui vont tout à fait dans ce sens là cinquièmement nous disent souhaiter des dom l'enfant apprend fait les inférences sur le sens des
mots en tenant compte de façon absolument massif du contexte d'apprentissage et il est vrai qu'il ya une liste très impressionnant D'expérience qui montrent que l'enfant est extrêmement attentif à la tension partager c'est à dire que il fait attention à ce à quoi le locuteur fait attention et le fait de partager la tension sur le g facilite l'apprentissage il fait attention également aux connaissances et aux intentions du locuteur lorsqu'il énonce un certain mot et il existe des données qui sont vraiment tout à fait frappante dans ce domaine je vais parler un peu Plus en détail de
ce concept de nouveautés des mots mais on peut citer par exemple cette recherche de grasmann 2009 dans lequel les enfants voient un adulte qui regarde un objet nouveau s'extasie draps cette voie là et qui dit à 7,1 galipeau c'est un magnifique galipeau avec beaucoup d'excitation dans ces conditions là les enfants apprennent que galipeau et effectivement le nom de ce nouvel objet mais si par hasard l'objet en question a déjà été vue par L'adulte auparavant pendant cinq minutes l'enfant et de l'adulte ont joué ensemble avec cet objet qui du coup n'est plus nouveau si l'enfant si
maintenant l'adulte a exactement le même comportement de s'extasier le dira c'est formidable ça galipeau etc l'enfant est surpris et l'enfant cherche un référent nouveau pour l'objet en question autrement dit l'enfant a l'air d'être sensible à l'idée que l'adulte à un concept de nouveautés et Suis en quelque sorte ce que l'adulte représente mentalement comme étant nouveau donc si l'objet qui est présent n'est pas un objet nouveau et que l'adulte se comporte comme s'il s'agissait d'un objet nouveau les enfants vont chercher un autre référent pour le mot autrement dit les enfants sont guidés dans leur apprentissage par
des inférences assez sophistiqué sur les intentions du locuteur deuxième exemple qui est dû à Thomas c'est le web barton en 94 un adulte énonce dans ce cas ci c'est il s'agit d'un verbe led ce clip de dole on va gripper la poupée et puis il fait une première action mais au moment où il fait cette action il dit oups en france et vers pardon je me suis trompé et puis il fait une deuxième action et il y voit là et bien dans ce contexte l'enfant associe le verbe glee peine le verbe nouveau non pas à
la première action qui a été fait mais la deuxième action gay Alors que dans toutes sortes d'expériences de contrôle on peut montrer qu'une seule instance d'une action suffit à l'enfant pour associer le verbe avec l'action correspondant donc ce qui se passe dans ce cas-ci tout à fait particulier c'est que l'enfant se rend compte que la personne s'est trompé que son intention n'était pas de faire l'action 1 mais c'était de faire l'action devait donc deux exemples parmi beaucoup d'autres on en verra encore Quelques autres dans un instant de recherche qui suggère que l'enfant est capable de
suivre les intentions du locuteur et d'en tenir compte dans son assignation d'un sens au mot qu'il entend alors chou et tenenbaum se propose de présenter un modèle complet de ce type de phénomène et ils vont aussi faire des expériences qui porteront sur l'apprentissage de mots nouveaux alors une expérience vous en Avez parlé je la représente et de retrait brièvement nous était proposé une expérience plutôt de penser en l'occurrence un nous était proposée par tenenbaum dans son article de sarrians en 2011 c'était l'apprentissage d'un mot comme tu fais qu'est ce qui se passe lorsque je vous
dis ceci c'est un tu vas et puis voilà ceci aussi c'est un tu fasses et cet objet là aussi c'est un tu fasses ça ressemble à la situation d'apprentissage de l'enfant qui reçoit 1 2 ou peut-être trois exemples de contexte dans lequel on peut utiliser un mot particulier comme le motif est bien tenenbaum attire notre attention sur le fait que immédiatement nous pouvons répondre à des questions complètement nouvelles sur des objets nouveaux est ce que par exemple ceci est un suffrage parce que me serais d'accord que c'est probable que oui ceci non ceci non celui
ci sans doute oui etc et on est capable puis la vie d'un tableau d'objets Complètement nouveau de décider individuellement pour chacun d'eux s'il s'agit ou non d'un tu faire alors tenenbaum et faye show vont utiliser cette situation comme une sorte de modèle de ce qui se produit dans l'apprentissage des mots essentiellement nous disposons de quelques instances et ensuite nous avons un très vaste espace de catégories qui peut être présenté sous forme d'un arbre et l'apprentissage du lexique va être vu comme la sélection D'hypothèses à l'intérieur de cet art rentrons un tout petit peu dans le
détail donc les données qui sont supposées acquises par l'enfant sont un certain nombre d'instances d'un nouveau monde c est associé avec un certain nombre de situations qu'on peut représenter par des vecteurs x1 x2 x3 qui sont autant de situations concrètes du monde extérieur dans lequel ce mot était in an c'est donc ce sont des entités dans un espace très une multi Dimensionnelle l'espace de la perception des objets le modèle suppose que l'enfant lui dispose d'un autre espace qui est un espace d'hypothèses concernant les concepts auxquels le mot c'est peu renvoyés et ses hypothèses vont être
en fait des sous ensembles d'objets possibles il faut imaginer que l'enfant le cerveau de l'enfant représentation mois hiérarchique ce l'espace des objets comme étant un sous n'est ce pas un sou Un jeu de sous-ensembles en chasser les uns dans les autres par exemple un des concepts possible c'est tous les êtres vivants année concept c'est tous les chiens tous les dalmatiens etc alors sur la base de ces observations l'enfant va mettre à jour la probabilité que chacune des hypothèses soit vrai et c'est là évidemment qui va agir dans l'hypothèse de tenenbaum échoue comme un bon petit
bayésiens il va mettre à jour la probabilité de chaque hypothèse Tenant compte des observations x en appliquant l'équation la ixième classique et évidemment tout le modèle va reposer dans la spécification de l'a priori d'ailleurs la probabilité de chacune des hypothèses et surtout de la vraisemblance c'est à dire quelle était la probabilité d'avoir fait cette observation particulière aux revues un tu vas particulier si tu vas voulait dire tous les chiens ou tous les Dalmatiens etc et c'est là que tenenbaum est chaud introduisent leurs hypothèses clés qui est que la vraisemblance dépend de la taille de du
sous-ensemble de référence donc si le sous-ensemble et très grand la probité de faire une observation individuel particulière dalmatiens particulier devient beaucoup plus faible 6-6 dalmatiens voulait dire de chien est bien là pour éviter que dalmatiens soit le mot qu'on entend à chaque fois avec Un dalmatien particulier deviendrait particulièrement faible juste pour vous montrer un petit peu comment ça marche dans le cas des tuffes à et c'est une diapositive que j'avais déjà montré l'an dernier voilà donc l'arbre qu'on peut dériver et il est possible par des méthodes automatique de dérivés ce type d'arbre similarités sur la
base des objets que je vous ai présenté tout à l'heure sous forme de tableau donc il y à des objets qui se ressemblent beaucoup Et puis les branches de l'arbre ensuite représentent des objets qui se ressemble de moins en moins et donc l'hypothèse c'est que le sens des mots va référer à des branches particulière de cet arbre chaque mot va pouvoir référer à une branche particulière de la main versement chaque branche de l'arbre est le référent possible d'un mot donc les hypothèses sur les sens des mots sont des sous ensembles d'objets alors voilà différentes hypothèses
possibles pour le Sens du mot tu fais maintenant comment va fonctionner le modèle est bien la vraisemblance donc on a observé trois instances particulière de tuf a qui sont encadrés en rouge ici comment est ce qu'on met à jour la vraisemblance comment est ce qu'on met à jour là plutôt la plausibilité de chacune des hypothèses donc verte orange et bleu ici étant donné qu'on a fait ces trois observations là et bien là vraisemblance de ces trois observations étant donné Chacune des hypothèses peut être calculé elle dépend uniquement d'après tenenbaum de la taille de l'arbre en
question et donc si on regarde ici l'arbre bleu à 14 branches donc à une priorité de 1 sur 14 de faire ses observation particulière l'arbre orange est plus étroit donc il ya une probabilité de 1 sur 8 de faire ses observation particulière l'arbre vert est encore plus étroits donc il a une vraie les observations une vraisemblance encore plus grande mais L'arbre vert à cette propriété tout à fait particulière qui l'exclût l'une des observations qui a été fait si le référent du motif a été l'arbre en verre ici eh bien on n'aurait pas pu observer cet
objet là comme étant un tu fais donc on voit immédiatement que le modèle va éliminer les hypothèses comme celle en verte parce qu'elles sont trop étroites elle ne recouvre pas ce que l'enfant a observé mais il va sélectionner automatiquement les branches de l'arbre Les plus petites qui s'ajuste finalement aux hypothèses qui sont observés le mécanisme attribue une vraisemblance le faible catégories les plus grandes et quelque part rencontre de cette intuition qu'on a que si par exemple le mot tuf a référé à l'ensemble de tous ces objets ici à gauche et bien ce serait une coïncidence
tout à fait extraordinaire que on nous est présenté que des exemples issus d'une branche tout à fait étroite de 7 donc le modèle Bayésiens peu formalisés ce qu'on peut appeler en quelque sorte une coïncidence win circonstances particulières de probabilités basse alors chaud et tenenbaum ne se contente pas de proposer ce modèle formelle mais vont faire des expériences pour le tester ces expériences sont menées à la fois chez l'adulte et chez l'enfant elle consiste à présenter donc aux adultes et aux enfants de 3 4 ans des mots Complètement nouveau comme tu femmes accompagnées d'exemples et une
vingtaine de mots vont être présentés certains vont être accompagné seulement d'un exemple par exemple ici un légume particulier un véhicule un animal d'autres mots vont être accompagnés de trois exemples est ici trois instances particulière du même légume trois instances du même véhicule trois instances du même objet du même chien dans une autre condition on va présenter Trois exemplaires de ce qu'on pourrait appeler la catégorie de base c'est à dire vous voyez on voit bien que c'est pas le même objet je suis désolé les photos devraient être en couleur normalement mais dans l'arctique elle était en
noir et blanc mais tout ceci était présenté en couleur et traçant beaucoup plus visible au sujet et donc on voit ici qu'il s'agit de trois exemplaires de couleur différente de forme légèrement différente de Caractéristiques légèrement différente mais du même objet de base le même sorte de camions ici et puis dans une quatrième condition les trois instances du même mot tuf avons est appliquée à trois objets qui appartiennent tous à une même catégorie niveau supérieur et ici il s'agit trois légumes et de genre tout à fait différente ici de trois véhicules il ya une moto et
un tracteur ou trois animaux de genre tout à fait différent alors donc on va forcer L'adulte ou l'enfant à apprendre un mot nouveau sur la base de seulement un ou trois exemplaires différentes et avec une variabilité dans l'exemplaire tout à fait différente suivant les conditions et puis ensuite on va demander à la personne de généraliser maintenant dites moi lequel est un tu fais ici un fait et évidemment on va poser la question à la fois pour des items qui sont qui correspondent à l'objet même que la personne a vu au départ à des objets du
Même de la même catégorie étroite et puis à des objets de la catégorie de niveau supérieur et puis bien sûr à des catégories qui n'ont rien à voir juste pour contrôler alors que va prédire le modèle la première chose que nous propose tout est énorme c'est une simulation dans lequel on fait tourner le modèle bayésiens et on regarde ce que va prédire le modèle en fonction des différentes conditions de l'expérience donc en abscisse ici Vous avez des exemples qui ont été données au sujet donc certains mots on a eu un seul exemple d'autres on a
eu trois exemples mais tous du même objet trois exemples de la même catégorie de base ou trois exemples de la catégorie super ordonnée et puis on teste ensuite avec des objets de ces différentes catégories envoyé immédiatement que le modèle bayésiens fait des prédictions tout à fait particulière et y compris pour la Condition on a un seul exemple cela fait prendre un seul exemple d'un seul mot on va déjà avoir des prédictions assez particulière qui sont que évidemment s'il ya une bonne mémoire la personne devrait généraliser à tous les objets identiques y compris vu sous un
angle légèrement différent et puis généralisé en partie et de façon probabiliste à des objets du même de la même nature mais éventuellement de couleurs de formes légèrement différente et généralise et Encore moins à des objets de la catégorie au dessus et puis cette forme de généralisation va changer du tout au tout suivant les instances qui sont donnés à la personne si on donne des instances extraordinairement variées et mais qui appartiennent tous à la même catégorie de niveau supérieur l'enfant va apprendre que et le modèle ici va apprendre à généraliser à l'ensemble des objets de cette
théorie alors que si au contraire les exemples sont Restreints à la catégorie de base il ne va pas généraliser autant à la catégorie du sud mais il va le faire de façon pour abily c'est bien ça c'est le modèle c'est un modèle qui est intéressant aussi dans la mesure il ne se contente pas de simplement d'avoir un formalisme sous forme d'arbre mais en fait il analyse très étroitement les jugements de similarité des personnes sur les items mêmes qui ont été présentés donc l'arbre des Hypothèses qui est supposé être à l'origine de l'apprentissage lexicale et dérivés
des jugements de similarités sur les images qui ont été présentés au cours même de l'expérience alors voici maintenant les résultats empiriques à la fois pour les enfants et pour les adultes et on voit que effectivement la généralisation de l'apprentissage d'un mot même sur la base d'une instance ou de trois instances est extraordinairement Différente suivant le contexte dans lequel le mot a été entendu si le mot a été entendue avec trois instances très différentes et tout faisant partie de la même catégorie supérieure donne est bien on voit immédiatement que l'enfant va généraliser c'est la colonne blanche
ici en particulier alors que si le mot a été entendu une seule fois et particulièrement s'il est entendu trois fois mais avec le même objet eh bien voyez qu'il ya très peu de Généralisation est ici si ces trois fois mais avec des objets avec une certaine variabilité dans la forme et la couleur eh bien vous voyez que la générisation va se produire sur la base la forme et de la couleur mais pas à la catégorie super entonnait et même chose pour les adultes on peut voir que c'est donner sa juste assez étroitement au modèle bayésiens
qui est proposé les auteurs discute le fait qu'ils aient des petites déviations avec les données Chez l'enfant ça juste assez étroitement au modèle bayésiens le politburo brut de fonderie si je puis dire le modèle adulte en dévient un tout petit peu dans la mesure où par exemple ici on a un petit peu plus de généralisation et voyez la forme de la généralisation n'est pas exactement la même quand on a une seule instance pour comme support de l'apprentissage alors les auteurs proposent un modèle légèrement révisée qui est intéressant dans lequel il Suggère que on peut ajouter
aux modèles un biais pour l'idée que les noms se réfère à la catégorie de base c'est-à-dire aux objets au sens où on les entend dans mon naturel c'est une hypothèse qui est très discutée dans la littérature psychologique peut-être l'apprentissage lexical aurait un biais pour les noms de base des objets mais ici on voit que ce n'est peut-être pas nécessaire pour rendre compte des données chez l'enfant mais peut-être Nécessaire seulement pour rendre compte des données chez l'adulte tandil adultes auraient appris des sortes de super stratégie du type 1 noms d'objets se réfère en général à la
catégorie de base et pas à un niveau du dessus ou un niveau d'en dessous bon c'est vraiment un détail et le modèle bayésiens de base déjà rencontre une très grande part des données on peut revenir aux observations initiales de chaux et hennebont mais Voir que d'abord le modèle effectivement fait changer toutes les probabilités a posteriori très rapidement après chaque observation même d'une instance d'un mot donc apprentissage ultra rapide il n'est pas nécessaire d'avoir des contre exemples on a vu qu'on pouvait éliminer des catégories entières de sens alors qu'il n'y a pas de contre exemple qui
est donné à l'enfant les enfants comme les adultes sont capables d'apprendre des noms qui Étiquette un ensemble en chasser un espace très complexe d'hypothèses en chasse est le fait que les hypothèses france ça ne pose pas de problème particulier aux modèles bayésiens le modèle rend compte des réponses graduelle du des sujets les connaissances lexical ne sont pas des connaissances exact mais semble bien être des connaissances pour un bis liste et là il ya toute une partie de l'article que je ne discuterai Pas mais dans lequel les auteurs montrent que d'autres modèles qui sont des modèles
beaucoup plus fondées sur des règles ou bien fondés sur des modèles connexio nist ne parviennent pas à rendre compte des données de la même manière bon c'est toujours discutable dans la mesure où l'espace des modèles est tout à fait vaste mais disons que des modèles logique dans lequel on verrait cet apprentissage lexical comme l'application de règles strictes de la Logique ne permettent pas de rendre compte de ce caractère graduel des apprentissages des enfants et des adultes alors il reste le point 5 que je voudrais discuter un peu en plus en détail c'est à dire l'idée
que l'apprentissage lexicale et flexible et tient compte du contexte pragmatique des intentions du locuteur et il ya là plusieurs possibilités d'extension du modèle bayésiens d'abord je vous avais expliqué que l'enfant est follement Sensibles au caractère aléatoire de l'échantillonnage chien qui se rend compte de façon très fine si un échantillonnage a été menée de façon aléatoire ou pas on avait vu ça au départ sur des urnes on va le revoir dans le cas des mots et puis il est tout à fait possible que l'enfant développe des modèles hiérarchique de la production vers bab c'est à dire
que non seulement ils apprennent le lien entre un mot est un objet visuel par exemple Mais ils apprennent aussi à tenir contre a résonné dans un cadre bayésiens qui fait des inférences également sur les intentions du locuteur alors voyons comment ça marche dans un cas qui a été très discutée dans le domaine de l'apprentissage lexical qui est ce qu'on appelle le principe d'exclusivité le principe d'exclusivité qu'est ce que c'est ça a été introduit dans une expérience de soucaret avec bartlett en 1978 expérience tout à fait classique Dans lequel on regarde ce qui se passe lorsqu'un
enfant on essaye de le lui faire faire quelque chose d'impossible en lui sont les seuils de le faire réagir un mot qui ne connaît pas donc on montre un enfant de deux ans deux plateaux qui est d'une couleur bleue tout à fait banale bleus standard qu'un autre qui est d'un vert olive brillante l'a fait inhabituel et ont dit à l'enfant à les ramène moi le plateau chrome et le plateau chrome est pas le Bleu chromé l'enfant connaît le mot bleus mais connaît pas le mot chrome et on aurait pu choisir d'ailleurs tu fars c'était l'idée
c'est que c'est un mot nouveau mais il ne connaît pas le sens du mot chromé mais est ce qu'il va être capable de ramener le plateau approprié eh bien on voit que l'enfant ramène le plateau qui est de la couleur inhabituelle la couleur qui n'est pas connu c'est ce qu'on appelle le principe d'exclusivité c'est à dire que le L'enfant a l'air de tenir compte du fait que étant donné que c'est un mot nouveau il doit ramener un objet ou une couleur dans ce contexte ici qui est une couleur nouvelle et les enfants effectivement semble s'appuyer
sur ce principe pour apprendre et donc cinq semaines plus tard se souviennent encore que chrome est réfère à cette couleur particulière donc il semble avoir une sorte de postulats dans l'apprentissage que chaque entité ne possède qu'un seul nom Par entité il faut entendre à une branche de cet art des hypothèses donc il ya beaucoup de données qui suggèrent et qui sont dues notamment au groupe de marque man qui suggère que aux orientaux de 16 mois les enfants et vivent déjà d'attribuer à la même entité des noms différents donc dès qu'ils entendent un mot nouveau il
postule que cela renvoie à un objet nouveau donc s'il ya deux objets d'un nouveau l'autre ancien ils vont choisir l'objet nouveau lorsqu'ils Entendent un mot nouveau et si ils entendent un mot nouveau qui est énoncé mais il n'ya pas d'objets nouveau devant eux comme référent ils vont chercher activement et ce comportement de recherche suggère qu'ils cherchent un référent qui n'est pas parmi ceux qui connaissent déjà donc ils sont réticents à attribuer le même mot plus tôt deux mots différents à un même objet il semble appliquer ce principe d'exclusivité alors ce comportement a Été également discutés
il a été élevé au rang de principe linguistique hélène markman propose elle appelle ça la mutuelle exclusivity assumption et yves clark et une autre linguiste tout à fait connu propose un principe de contraste de conventionalité bon l'idée c'est que des pénalités beaucoup discuté de cette manière là l'apprentissage du langage serait guidé par des grands principes qui en quelque sorte rendre l apprentissage possible sinon on Reviendra là dessus dans le court prochain il y aurait une telle pauvreté des entrées et qui sont disponibles à l'enfant que l'apprentissage ne serait pas possible donc le cerveau humain aurait
hérité de grands principes qui pourraient être particulier peut-être à l'apprentissage du langage et qui guiderait ses apprentissages évidemment on voit bien que ce type de principe pourrait guider en particulier l'apprentissage de choses qui ne sont Pas des noms par exemple ou alors les noms de catégorie mais les noms de partis d'objets lennon d'action une fois qu'on a exclu le fait que un nom ancien permet de référer à la catégorie de base on va être obligé d'aller chercher suivant ce principe d'exclusivité d'autres référents possible pour les noms nouveaux qu'on entend le problème c est ce qu'on
est vraiment obligé de postuler que ce principe est particulier au langage qu'il est là pour Guider les apprentissages linguistiques sans lui on ne pourrait pas à prendre est ce qu'on est vraiment obligé de supposer que les entrées linguistiques sont aussi pauvres que peut-être chomsky il a postulé et bien dans le cadre bayésiens tenenbaum et ses collègues sont amenés à réviser cette idée là et a montré qu'en fait sur la base de principes bayésiens tafer générique on peut peut-être rendre compte de ce type d'apprentissage et de ce type de Principe n'ont pas vraiment des principes sont
plutôt des conséquences d'apprentissage statistiques alors qu'est ce qui pourrait se passer ici et bien une origine principe du principe d'exclusivité et consiste à considérer l'ensemble du contexte de la production verbal est donc considéré que l'énoncé d'un mot ne dépend pas seulement de son sens et de la présence d'objets le monde extérieur mais aussi de l'intention du locuteur et de sa connaissance Par le locuteur de certains mots donc depuis le départ j'ai discuté simplement cette idée que les hypothèses sur les sens des mots faible veut dire x tu vas me dire y cetera sont mis en
relation par l'enfant avec le fait qu'il observe un mot particulier mais le bon modèle bayésiens de la situation d'apprentissage des monnaies pendant sans doute pas seulement celui là c'est aussi un modèle dans lequel un sont introduits des hypothèses sur les Intentions du locuteur l'enfant doit considéré que le locuteur à l'intention de nommer l'objet d'un bel objet b et si l'enfant est capable comme on le suppose depuis le début de secours de faire des raisonnements bayésiens inverse donc de remonter à ces hypothèses caché sur par exemple dans ce qui dans ce cas précis les intentions de
la personne eh bien il va être capable de créer des inférences assez sophistiqué et on voit que le principe de l'exclusivité va tomber donc Il faut absolument que dans le modèle bayésiens la probabilité d'observer un mot ne dépendent pas simplement de la présence d'objets dans le monde extérieur dans des hypothèses h mais aussi des intentions du locuteur en voyons comment ça marche imaginons qu'un enfant pardon un adulte soit en présence d'un chien et dise le mot truffe et l'enfant connaît le mot chien et L'enfant suppose évidemment que l'adulte connaît le mot chien alors comment est-ce
qu'on pourrait exploiter ce type de modèle béziers hiérarchique pour faire des inférences qui conduiront au principe d'exclusivité et bien la voie de gauche du modèle ici va nous permettre de déduire que si l'adulte avait voulu nommer le mot chien il aurait des chiens donc s'il n'a pas de chien c'est que il ne voulait pas nommé le chien s'il ne Voulait pas l'homme et le chien ça veut dire que le profité que le mot truffe renvoie au mot chien est faible et ça veut dire qu'il va falloir chercher parmi les hypothèses de droite autre chose que
l'hypothèse que le mot truffe réfère aux chiens tout entier est donc peut-être en l'occurrence qu'il s'agit d'une partie du chien une catégorie néo supérieur ou peut-être il faut réviser n'ont pas la partie droite du modèle mais la partie gauche du modèle ses Terres l'adulte est en train de jouer ils attendent plaisanté il s'est trompé et c est que le modèle bayésiens va automatiquement quelque part inclure ce principe d'exclusivité si on est capable de suivre ce type d'arborescence alors ce qui est assez frappant c'est le parallèle entre ce modèle que je viens de vous présenter et
le modèle que je vous avais présenté il ya maintenant trois semaines sur la sensibilité des enfants au caractère aléatoire ou pas de L'échantillonnage c'est presque exactement le même modèle dans le cas du modèle d'échantillonnage vous rappelle un l'enfant voyaient ils ont des enfants très jeunes de 13 à 18 mois donc juste au début de cette explosion lexical c'est tout à fait compatible avec l'idée qu'il ya des compétences sont là chez l'enfant pour faire ce type de raisonnement vous souvenez que dans cette expérience de guantanamo mais schulz l'enfant voit une urne et On la personne tire
des objets de ceinture mais elle ne tire que trois objets bleus alors qu'ils auraient beaucoup d'objets jaune et ensuite on regarde si l'enfant un fer que les propriétés des objets bleus il les généralises à des objets jaune et on voit que l'enfant ne généralise pas lorsqu'il a vu que l'adulte a sélectionné spécifiquement les objets bleus je vous renvoie au tour précédent on avait conclu avec gwen tenenbaum et Schultz que l'enfant était capable de tirer des inférences assez sophistiqué non seulement sur les propriétés particulières des objets ce que les objets bleus font du bruit est ce
que les jeunes font du bruit mais aussi sur les intentions de la personne en question ne pouvait rendre compte des données de cette expérience qu'en supposant que la personne suivait de façon assez fine les intentions des personnes étaient capables de détecter Le caractère non aléatoire de l'échantillonnage ici et bien exactement la même manière là ici si on suit le parallèle on peut penser que dans l'apprentissage du lexique un enfant va être capable de suivre les intentions d'une personne et de remonter donc à ses intentions cachées sur le fait de nommer ou pas un objet particulier
alors cette idée que le principe d'exclusivité n'est pas un principe gravé dans le marbre mais est en fait le Résultat d'une afférents statistiques tout à fait standard génériques eh bien il existe un certain nombre de données qui vont dans ce sens je voudrais vous présenter deux diapositives là dessus la première c'est une expérience tout à fait intelligent de djanet werker grands spécialistes de l'apprentissage du langage qui réfléchit à ce qui devrait se passer chez des enfants multilingue avant chez les enfants multilingue le principe d'exclusivité et violet ce que Le même objet peut avoir des noms
différents et c'est tout à fait pragmatiquement pertinent que le même objet puisse aborder des noms différents dans la langue 1 dans la de l'octroi donc idée très simple de djanet werker si le principe d'exclusivité est un principe rigide les enfants monolingue bilingues ou trilingues doivent se comporter de la même manière mais si le principe d'exclusivité est un principe inférées statistiquement et bien les Enfants multilingue doit se comporter différemment donc elle teste ça avec une situation très simple ça nous permet de voir au passage comment ces choses sont testés elle présente deux objets sur un écran
d'ordinateur par exemple la voiture et la balle on a maintenant chez l'enfant des systèmes de suivi des mouvements oculaires qui sont extrêmement pratique à utiliser qui permet de quantifier très finement ou est ce que l'enfant va regarder et on Regarde donc on suit le regard de l'enfant alors que l'on l'enfant entend le cadre de cas ou local de bord et on va regarder si l'enfant regarde du bon côté regarde le bon objet la situation claisse et celle d'en bas où il ya deux objets à nouveau sur l'écran l'un est une chaussure dont le nom est
connu supposé connu par l'enfant et l'autre est un drôle d'objet il se trouve que c'est un photo tubes et ont dit à l'enfant le cas de faute aux tubes c'est Un peu la même chose que tout à l'heure ce qu'on disait un regarder le plateau chromé c'est un peu un mot qui est supposé noms connus de l'enfant alors est ce que l'enfant va regarder utilisant le principe d'exclusivité va déduire que ce n'est pas la chaussure qu'il connaît mais donc ça doit être l'objet qui ne connaît pas et bien les résultats sont assez intéressants donc ici
vous avez la préférence pour le bon objet donc tout ce qui est au dessus de Zéro montre que l'enfant regarde du bon côté et donc dans la partie de gauche c'est les objets familiers voiture et balle et on voit que tous les enfants monolingue bilingues et trilingues regard du bon côté don la méthode marche on est capable de mesurer le regard de l'enfant vers le bon objet maintenant on voyait à droite la partie qui concerne l'étiquette nouvelle le photo tubes du poteau électrique et voyez que les Enfants monolingue utilise le principe d'exclusivité et donc parviennent
à orienter leurs regards vers le bon côté celui qui correspond à l'objet nouveau mais les enfants bilingues et encore moins les enfants trilingue et bien ne suivent pas ce principe d'exclusivité le principe d'exclusivité modulée par le fait d'avoir été exposés à des langues multiples et donc la pertinence du principe d'accessibilité n'est plus la même on pourrait toujours dire qu'il ya Un principe mais qu' on est capable de moduler son expression en fonction du contexte mais le modèle bayésiens va rendre compte de ces données de façon assez naturelle en supposant que en soit c'est une inférence
et que si on a affaire à des personnes multi la règle est bien différent ce qu'on faisait tout à l'heure je reviens sur cette diapositive qui est que si l'adulte avait voulu nommer le chien il aurait probablement dit le mot chien c'est Inférences l'année plus juste dans un contexte multi n'aurait alors le principe d'exclusivité quelque part se réduit peut-être à des inférences et ça va bien également avec d données supplémentaires dont je voulais vous parler qui sont assez amusantes qui montrent que l'apprentissage du lexique peut exister chez l'animal il existe une série d'articles et en
particulier celui qui est très connu celui de kaminski en 2004 qui montre que l'apprentissage des mots peut exister par exemple chez le chien domestique et on connaît des chiens en de façon anecdotique départ qui semble avoir un vocabulaire de plusieurs centaines de mots c'est à dire qu'on peut leur demander un objet particulier va chercher la poupée et ils vont aller chercher l'objet correspondant kaminski collet fischer s'appuie sur ses observations anecdotique mais dans cet Article de sarens et évidemment ils se disent bon comment on va pouvoir tester cette capacité d'apprentissage de mots et en particulier est
ce que le principe d'exclusivité existe déjà dans ces espèces qui ne sont pas humaine alors il étudiait un chien particulier qui s'appelle rico qui par le passé avec sa maîtresse a appris plus de 200 mots mais ils vont lui apprendre des mots nouveaux et comment est-ce qu'on teste alors si l'animal connaît vraiment les mots il ya Évidemment un problème fondamental ici qui est celui de problèmes du club hans et dire qu'on n'est jamais très sûr que ce soit vraiment l'énoncé du mot lui même ou peut être d'autres indices subtils du comportement de la personne peut
être son regard peut-être son attitude générale qui donnent des indications à l'animal alors pour faire un test tout à fait propre de la connaissance des mots chez ce chien est bien il propose une situation dans Lequel le les objets vont être placés dans une pièce la personne la maîtresse vais dans une autre pièce elle va donner des ordres aux chiens mais ne va absolument pas voir ni être en contact avec ce fait le chien est donc quelque part on va entendre dans une seconde on entend la personne donner des ordres aux chiens dans la pièce
d'à côté et le chien va se déplacer aller chercher l'objet approprié alors vous allez voir dans une seconde ce que ça donne donc Vous allez entendre trois mots et conte on va voir ce que le chien est capable de faire sur la base d'un échantillon d'objets qu'il a devant lui le point clé c'est non seulement est ce que le chien est capable d'aller chercher l'objet correspondance qui montrerait que ce n'est pas juste un effet clever en effet d'un 10 de la base sur la de la part de la propriétaire de ce chien mais aussi qu'est
ce qui va se passer avec des Objets nouveaux est ce que le chien qui entend un nom complètement nouveau qui n'a jamais entendu auparavant va être capable de choisir le bon objet alors je vais vous présenter cette vidéo qui accompagne la publication originale de sérieuses alors voilà dans la pièce d'à côté il ya toute une série d'objets tous ces objets sont connus du chien sauf la poupée blanchissez et en particulier il faut faire attention à cet objet là qui est le t-rex est un tyrannosaure rex le Chien a pris sa sous le nom de t-rex
et puis il a appris ici le nom de père noël en allemand pour ce cet objet là on va voir successivement ce que fait le chien et que là il a on lui a demandé j'ai pas si on peut avoir le son mais je crois qu'on n'entend pas très bien de toute façon merci donc là on lui demande le t-rex mais qu'il est très attiré par l'objet nouveau mais on lui demande le t-rex Alors il cherche il réfléchit je crois qu'il est parti je pense qu'il est parti avec la mais je m'excuse je vais pas
si on rembobine la vidéo alors on va voir la suite maintenant on lui demande le petit père noël rouge voilà il est pas voilà j'avais anticipé excusez moi il a fallu un petit peu de temps pour comprendre ce qu'on lui demande là mais il est parti avec le t-rex maintenant on va lui demander le Père noël rouge ces deux objets là sont des objets déjà connus sont des objets qui font partie de son vocabulaire normal donc quelque part bon ça valide le fait qu'ils connaissent et mots maintenant il vient le test crucial on lui demande
un mot complètement nouveau qui ne connaît pas et voilà immédiatement il va aller se saisir j'espère Voilà on n'entend pas très bien les ordres je pense qu'on n'était pas tout à fait synchrone il a vidé heures de la personne vous avez compris je crois que le micro ne fonctionne plus merci c'est un comportement statistiques de la part de l'animal c'est par un comportement parfait mais il semble bien que l'animal comprennent d'hommes d'une part qu'elle est le référent de certains mots et faire des objets connus et d'autre part utilisent ce principe D'exclusion d'exclusivité et les auteurs
teste ensuite si ce principe d'exclusivité a suffi à apprendre le sens du mot donc il ya eu une seule instance d'un mot nouveau qui a été associé à un objet nouveau que l'animal a rapporté comme on l'a vu ici plusieurs semaines plus tard lorsqu on teste avec neuf objets dont quatre sont nouveaux il yal celui qu'on vient de voir le lapin blanc et puis quatre sont anciens et bien le chien va relativement souvent C'est pas parfait mais va se souvenir du sens donc de la référence de ce mot particulier nouveau qu'il ait repris donc ce
principe d'exclusivité semble être utilisé même par des espèces animales non humaine et si tel est le cas évidemment on peut penser que ça n'a rien à voir avec l'apprentissage du langage en particulier c'est un principe beaucoup plus générique je ne sais pas si l'on peut conclure ce type d'expérience que ce type d'animaux qui Sont des animaux domestiques ça peut être une situation tout à fait particulières font des inférences sur les intentions du locuteur il ya quand même les interprétations plus simples qui peuvent être proposées également et une interprétation plus simple c'est que ce principe de
nouveauté peut être découvert de façon statistique lui-même c'est-à-dire sans être nécessairement est là encore je reviens en arrière mais diapositives sans être nécessairement Capables de tirer toutes les inférences d'un modèle des intentions du locuteur tels que peut-être le fait le jeune enfant le chien est peut-être capable tout simplement de se rendre compte que 1 mot nouveau correspond à un objet nouveau autrement dit que la nouveauté qui est quelque chose de tout à fait facile à calculer est calculée par de très nombreuses espèces animales la nouveauté elle même est un indice sur la Référence des skill
est prononcée par la maîtresse à un moment donné donc on voit ici l'irruption est tout à fait possible dans un cadre bayésiens de sorte de super principe d'apprentissage des règles d'apprentissage de niveau supérieur qui contraignent l'ensemble des apprentissages de niveau inférieur mais qui n'ont rien de particulier au domaine du langage qui sont des situations tout à fait standard dans le domaine d'apprentissage belge Alors justement cette notion d'apprentissage hiérarchique nous conduit aussi à d'autres contraintes sur le lexique et nous commençons à voir que cet apprentissage du lexique mental qui paraissait tellement mystérieux en fait énormément contraint
de toutes parts par des règles qui peuvent être un ferrer par l'enfant alors l'une de ses règles c'est le biais pour l'apprentissage des noms le biais pour la forme pardon dans l'apprentissage des noms voilà un Certain nombre de marteau voyez que ils partagent tous évidemment une certaine forme ils partagent tous une forme qui est adapté à la fonction mais ils ont par ailleurs une très grande variabilité dans les détails de la taille de la couleur des objets vois un certain nombre de chiens et bien entendu la catégorie chiens est extrêmement variable dans les détails de
la forme et de la couleur alors de manière assez générique à part Fait évidemment mais de manière assez générique il est vrai que les noms des objets que nous apprenons réfère à la forme abstraite mais pas au détail de la couleur ou de la taille des objets évidemment dans certaines limites et dans certaines limites qui sont là encore statistiques et probabiliste il est clair que lorsque j'apprends le morose une rose et bien j'apprends quelque chose de particulier sur la couleur mais même dans ce domaine voyez Qu'on a une tolérance et qu'on va accepter d'appeler une
rose quelque chose qui n'est pas de couleur rose donc il y à une sorte de principe statistiques générales qui est que en général les noms d'objets ont tendance à faire abstraction des détails de couleurs et de formes alors est ce que les enfants sont capables de tenir compte de ce principe eh bien je reprends ici là encore quelques diapositives que je vais présenter l'an Dernier qui montre que oui dans une recherche de linda smith il semble que les enfants soient capables de faire abstraction très vite de ce principe regardons cette expérience qui est toujours dans
cette période dont de l'explosion lexical entre 17 et 19 mois on va apprendre aux enfants des mots nouveaux mais on va leur apprendre un certain nombre d'instances qui leur permettent d'abstraire ce principe général alors voilà comment ça se passe On apprend aux enfants 4 mot et chaque mot est associé à deux objets particuliers donc le mot whif par exemple on va commencer par présenter à l'enfant cet objet là on va lui dire regarde ça c'est un riff un magnifique whif et puis ça aussi c'est un riff et qu'ils n'ont pas exactement la même taille et
ils n'ont pas la même texture ça c'est un super ça c'est un hub ici voilà d'accès voilà un autre date la texture change complètement mais la Forme globale de l'objet voici un legs après cet apprentissage l'enfant peut évidemment apprendre le sens de ces mots particuliers mais on va tester également qu'elle et sa connaissance des principes abstraits alors comment le tester premier test qui est proposé à l'enfant on lui présente un mot qu'il a déjà entendu le mot log ici on lui présente une nouvelle instance donc ils arrêtent troisième support pour l'apprentissage et Maintenant on lui
présente trois objets possibles et on lui dit regarde il ya un l'aigle il ramène moi le log montre-moi le legs et évidemment vous voyez que indices tracteur n'a rien à voir indice tracteur a la même forme mais pas du tout la même texture et un autre distincte sur dix tracteurs à la même texture mais pas du tout la même forme qu'est ce que leur forme à choisir et bien 88% du temps ce qui est tout à fait Considérable par rapport au niveau du hasard qui serait 33% l'enfant va choisir l'objet qui a la même forme
et faire totalement abstraction de la texture particulière le vrai test il est ici le vrai test c'est avec un mot complètement nouveau pour lequel on a une instance unique donc voilà un mot vite ici avec un objet complètement particulier et puis à nouveau à dix tracteurs qui n'a rien à voir un dix tracteurs qui a la même Forme mais pas la même texture indices tracteur qui a la même texture mais pas la même forme qu'est ce que l'enfant va choisir et bien 70% de réussite dans le choix de l'objet qui a la même forme indépendamment
de la texture particulière donc l'enfant a l'air de se servir d'un principe qu'il a pu abstraire de l'exposition préalable est une des choses qui est tout à fait particulière dans cette situation c'est que les enfants qui ont été exposés à Cette situation de laboratoire semble ensuite apprendre plus vite les noms je trouve que c'est tout à fait frappant parce que ça suggère que quelques minutes d'interaction dans le laboratoire peuvent avoir changé la trajectoire développementale de l'apprentissage lexical des enfants qu'est ce qui se passe ici c'est la découverte c'est que donc si on fait les mesures
d'inventaire lexical à 17 mois et à 19 mois chez les enfants donc quels Sont les mots qui connaissent un les mots normaux de la langue qu'ils connaissent et on voit bien entendu que le nombre de mots connus progresse mais dans le groupe qui a été entraînée par rapport au groupe contrôle eh bien les une performance sur l'apprentissage des noms d'objets dans la langue naturelle ont été bien supérieur une accélération de l'apprentissage des noms d'objets alors que ce n'est pas le cas pour les autres sortes de maux comme les verts Mes adjectifs et c'est donc il
semble bien ici qui est un principe général qui avaient pu être dégagées par l'enfant qui n'est pas parfait qui ne marche pas pour tous les maux mais qui marchent suffisamment bien pour avoir accéléré l'apprentissage doxique aussi ces recherches sont vraies elles sont extrêmement importantes à plusieurs points de vue d'abord elle montre et ça c'est un thème général de secours que l'enfant est capable d'aller très vite à L'abstraction que même à cet âge la première année de vie deuxième année de vie il extrait des inférences très abstraite sur l'existence de principes généraux et deuxièmement il montre
bien que ces grands principes peuvent guider l'apprentissage et que peut-être donc il peut y avoir un impact pratique aussi de ses recherches lorsqu'on présente des imagiers à l'enfant lorsqu'on pense qu'on cherche à enrichir le vocabulaire de l'enfant eh bien il ya peut-être là Des principes tout à fait élémentaire de diversification des entrées de l'enfant qui lui permettent non seulement d'apprendre le sens de certains mots précis ce qui est utile le mot rhinocéros le mot girafe etc mais aussi et peut-être principalement à prendre des sorts de super principes qui vont guider tous les autres apprentissages et
quelque part aussi à huile et cette machinerie statistiques qui fonctionne remarquablement bien déjà donc je pense Que on ne réfléchit peut-être pas assez un forme de généralisation qui sont que l'enfant est capable de mener dès cet âge là et qu'ils vont avoir un impact en cascade sur toute une série d'autres apprentissages ici on a un bel exemple de ce type de généralisation donc je clos ici le chapitre sur l'apprentissage du lexique en soulignant qu' il faut vraiment tenir compte de toutes cette hiérarchie de principe et ne pas du tout pensé que l'apprentissage Du lexique c'est
simplement la mise en relation concept prêts existants avec des mots prêts existants mais c'est un travail de recherche sur un arbre d'hypothèses contraint lui même par une hiérarchie d'inférence statistiques alors maintenant je voudrais dire quelques mots pour terminer sur le lexique à l'âge adulte le lexique à l'âge adulte pourquoi parce que on a vu apparaître récemment toute une série d'articles qui Font tomber je dirais ce domaine de leur connaissance des monts dans l'escarcelle des modèles bayésiens et là encore je trouve très intéressant kink un cadre théorique générale le cadre bayésiens permettent de rendre compte de
tout cet espace temps je vais sauter cdja peau parce que je vois que j'ai pas le temps voilà donc le lecteur bayésiens c'est le titre de l'article dennis norris nous propose en 2006 et est suivie ensuite de toute une série d'articles par le même Moteur qui en quelque sorte découvert et mis en valeur à côté d'autres mais peut-être mieux que les autres le potentiel des modèles parisien dans le domaine de leur connaissance du lexique qu'est ce qui se passe lorsque nous entendons un mot est bien de nice norris nous propose de faire ce qu'on appelle
une analyse rationnelle c'est à dire d'essayer de poser les principes de ce qu'on devrait faire si on est un observateur idéal optimale lorsqu'on Entend un mot particulier dans un contexte qui est toujours évidemment brut c'est ce qu'on appelle l'analyse rationnelle du comportement qui est un grand domaine maintenant les sciences cognitives étaient bien d'essayer de formuler des modèles optimaux des modèles génériques de ce que devrait être le comportement donc une analyse qu'on peut appeler computationnelle au sens donné vie de marc qui ne s'intéressent pas à l'implémentation Particulière des opérations cognitives mais juste aux principes mathématiques qui
devrait les guider alors comment se pose le problème est bien les entrées sensorielle lorsqu'on entend un mot sur nécessairement ambiguë elles ne sont pas parfaits ne sont pas dépourvus de bruit a toujours de l'ambiguïté la solution bayésienne est donc la solution team a essayé de calculer la probabilité que tel ou tel mot et était à l'origine des entrées sensorielle que nous avons Observé je vous renvoie au cours de l'année précédente pour cette approche dans le domaine de la perception visuelle mais si on va en parler dans le domaine du lexique donc il s'agit de calculer
la probabilité qu'un mot était observé étant donné les entrées et par inversion bayésienne on va donc calculer la probabilité que les entrées étaient observés s'il s'agissait de tels mots multipliaient bien entendu par la probité a priori d'avoir observé tel ou Tel mot le point important c'est que les mots sont représentés dans un très vaste espace multi dimensionnelle ça c'est un autre principe général maintenant en sciences cognitives donc tu peux imaginer l'espace par exemple de tout lady g possible toutes les paires de l'aide possible ça représente un espace de représentation possible des mots écrits et le
modèle va accumuler l'évidence au fil du temps issus des échantillons sensorielle qu'il reçoit en Faveur de tel ou tel mot possible donc il va considérer en parallèle toutes les hypothèses possibles sur les mots que l'on peut avoir entendu et les entrées sensorielle vont contraindre le modèle à converger vers le mot qui est le plus plausible étant donné les entrées alors d'aunis norris nous propose une simulation particulière de cette chose là il s'est assez complexe les modèles bayésiens dès qu'il s'agit de les implémenter et en particulier la Vraisemblance c'est à dire la fonction qui définit la
probabilité d'avoir tel intérêt sensorielle étant donné que le mot serait le mot chat c'est une fonction assez complexe alors ici d'aunis norris simplifie le problème en supposant qu'on est dans un espace très multidimensionnelle qui représentait juste ici par un axe horizontal donc les mots occupent des positions sur cet espace est il suppose que chaque mot a une espèce de distribution gaussienne Autour de cette position centrale donc qui définit la probabilité qu on observe des échantillons qui s'écarte un petit peu de ce prototype du mot et il va simuler l'accès au lexique en supposant qu'un de
ses mots et sélectionner ou peut-être un pseudo mots c'est à dire quelque chose qui serait entre les monts qui serait pas un mot possible dans le lexique mais qui serait donc un nom mot ce dôme haut et que les entrées vont s'accumuler autour de ce point qui a été Choisie comme entrez donc il va y avoir une certaine distribution statistique des entrées et en fonction du niveau de bruit auditif ou visuel par exemple eh bien les entre l on est plus ou moins dispersées autour de la position du mot qui est donné en entrée alors
on voit immédiatement que ce modèle va recevoir des votes qui vont être principalement en faveur du mot qui est réellement présentait mais en fonction de la dispersion des entrées vont également en Quelque sorte c'est aller au mot voisins les mots voisins vont être des candidats possibles pour la reconnaissance lexicale et pendant un certain temps en fonction du degré de bruit d entrée le modèle va hésiter entre plusieurs candidats possibles pour le moc est entendue et bien cette hésitation et cette accumulation d'évident statistiques en faveur du mot le plus plausible va rendre compte d'un grand nombre
des faits ou peut-être de tous Les effets qui ont été décrits jusqu'à présent dans le domaine de l'accès au lexique et c'est une littérature tout à fait vaste la littérature sur l'accès au lexique mentale en psycholinguistique je vais pas rentrer dans un immense détails mais commençons par quelque chose d'extraordinairement simple c'est ce qu'on appelle l'effet de fréquences l'effet de fréquences et quelque chose d'extraordinairement simple c'est que si vous prenez des mots dans le lexique Dans le dictionnaire certains sont très fréquents le le peut-être en français et et puis d'autres sont extraordinairement rare le mot ornithorynque
vous avez tout un continuum de fréquences possibles et on sait depuis très longtemps que la fréquence des mots détermine de façon absolument massive la vitesse avec laquelle une personne va être capable de répondre à un mot donné vous voyez ici des données issues de trois grands jeux de données différents jeux je vois que Je n'ai pas mis les étiquettes mais il me semble que c'est en anglais en français et en hollande et la vitesse avec laquelle une personne n'est capable de dire si un objet s'il ya une chaîne de caractères devant elle est un mot
ou n'est pas un mot donc son appel la décision lexical mais que la ici il s'agit des mots avec la vitesse avec laquelle on décide que c'est un mot est une fonction très caractéristique du log de la fréquence et c'est le log de la Fréquence qui compte ce qui veut dire qu'il ya un espace de fréquences possibles extraordinairement vaste de louvoyer plusieurs échelles de grandeur ici c'est de l'ordre de 5 échelle de grandeur pour cette courbe bon la partie droite de l'accord est peut-être un peu moins bien estime m ce sont des mots extraordinairement rare
et que sur toute une partie du de cette courbe on a une relation linéaire entre la vitesse de décisions lexicale et le loch de la Fréquence j'en profite pour dire que ce sont des données qui sont maintenant disponibles et qui sont tout à fait exhaustive en psycholinguistique qui font partie des projets de lexique massifs qui ont été lancées par balle haute à ses collaborateurs qui existe maintenant français aussi on a des données sur des dizaines de milliers de mots du français avec des milliers de personnes qui ont fourni les temps de réaction pour la décision
lexical Également pour la dénomination des mots et donc ces données sont disponibles pour quiconque souhaite les analyser et développer des modèles du lexique mental ou développer également des applications informatiques ce sont des bases de données qui sont extrêmement intéressants et on voit à quel point cette régularité réplicable dans des langues très différentes alors pourquoi le log de la fréquence en fait l'histoire du loch de la fréquence Évidemment connu de façon très ancienne et a été introduite dans de nombreux modèles connexio nice tous des modèles logique de l'accès au lexique mais la plupart de ses modèles
se contentait de stipuler que cet effet existe par exemple dans les modèles connection east on allait dire le seuil de déclenchement d'une unité était fonction du loch de la fréquence mais en excès on n'explique pas pourquoi cet effet là allaient émerger dans un modèle d'autres modèles Supposer que c'était un effet d'apprentissage c'est à dire que évidemment les mots qui reviennent fréquemment son mieux a pris les mots qui reviennent rarement sont moins bien appris mais ça ça pose énormément de problèmes d'abord pourquoi logarithme pourquoi les mots plus fréquents n'écrase pas les mots rares en fait dans
les modèles connexio nist a été un problème absolument majeur c'est à dire que est ce qu'on appelait la catastrophe D'apprentissage c'est que des mots qui sont présentés dix puissance moins cinq fois plus rarement que les autres ne sont jamais appris le modèle connexio nice n'est pas capable d'apprendre des mots qui ont une telle rareté alors qu'il est présenté de façon beaucoup plus massive il reçoit des mots infiniment plus fréquent que les autres et puis il ya un problème tout à fait simple si si on attribue cet effet à l'apprentissage qui est de penser qu'on Devrait
avoir une asymptote chez l'adulte tous ces mots sont des mots familiers au moins tous ceux de la partie gauche de la courbe ici tous des mots familiers pourquoi est ce qui reste un effet de fréquences pourquoi est-ce qu'on n'a pas finalement converger et a pris tous ces mots avec la même capacité alors cet effet fréquent c'est donc en quelque sorte un mystère encore non résolus maintenant je pense que vous êtes familier avec les modèles bayésiens Vous voyez vous-même immédiatement que ça en découlent directement en fait il s'agit d'un effet de la priori je vais aller
très vite parce que le temps passe un mais donc si on cherche la probabilité que l'entrée x correspondent à un mot particulier w il faut calculer donc 7 il faut appliquer la règle malaisienne classiques dont tenir compte de la vraisemblance mais aussi de la probité a priori de chacun des mots et en L'absence de tout autre connaissance c'est la fréquence de base du monde si je ne sais pas très bien ce que j'entends je dois faire l'hypothèse en bon bayésiens que c'est la fréquence de base qui compte et si je dispose de plusieurs échantillons indépendant
je vais à cumuler les données donc je vais essayer de calculer la fréquence plus tôt la plausibilité que ce soit tellement w étant donné tous les échantillons que je reçois Successivement mais je vais devoir tenir compte de la probabilité a priori lui multiplié ensuite parlé plausibilité successives ans passés en longueur logarithme et j'avais déjà discuté de cette accumulation d'évidence si on passe au logarithme on a on arrive à une marche aléatoire c'est à dire que chaque échantillon sensorielle fournit un pas supplémentaire dans une séquence dans une sommation qui part du log de la probabilité a
priori des mots et donc il Faut imaginer dans le cerveau autant de marche aléatoire qui a deux mots possibles dans le lexique le cerveau considère en parallèle tous les maux possibles correspondant à une entrée sensorielle mais le pas d'où il part est fonction du log de la probabilité donc de l'ocs de la fréquence de ce mot dans le lexique de la personne ce qu'on peut de façon équivalente dire aussi que le seuil d'arrivée n'est pas le même que les mots fréquente un seuil plus bas ça Revient exactement au même que de dire que le point
de départ n'est pas le même et que c'est une conséquence logique normale des équations bayésienne et donc pour aller vite de nice norris en 2006 simule son modèle avec d'autres détails montrent tout à fait clairement que le temps de réaction dans son modèle est fonction du loch de la fréquence des mots c'est normal c'est dans les équations bayésienne il ya une étape intéressante c'est exactement au même Moment en 2006 rogers radcliffe qui est un grand spécialiste de ces modèles de diffusion donc de marche aléatoire dans la prise de décision dans le temps de réaction montre
que la diffusion est effectivement un excellent modèle de du temps de réaction dans ce qu'on appelle la décision lexical c'est à dire le fait de se décider si un objet est un mot n'est pas un mot et en particulier il montre au delà de ce qu'ils avaient montré norris qui regarde juste la Moyenne des temps de réaction ici ratcliffe montrent que la distribution des temps de réaction c'est leur caractère aléatoire peut aussi être rendu compte par ce modèle de diffusion et de marche aléatoire c'est tout à fait frappant que lorsque vous recevez un mot même
très connus lapin votre temps réaction pour dire si c'est un mot ou pas n'est pas constant il est extraordinairement variable il ya une distribution Statistique donc ici on voit les quartiles de la distribution la moyenne est peut-être aux alentours de 500 millisecondes ici ou là médiane mais la distribution est extraordinairement vaste de temps en temps vous allez mettre 8 100 millisecondes de temps en temps vous allez mettre 450 pourquoi cette variabilité bien le modèle bayésiens on rencontre directement en supposant qu'il ya cette marche aléatoire il ya un caractère Inéluctablement aléatoire dans ce type de prise
de décision alors on voit que radcliffe avait réussi à rendre compte de la forme de l'effet fréquence et on voit en particulier que les mots de basses fréquences non seulement une moyenne plus élevée de temps de réaction mais aussi une distribution de formes différentes avec une dispersion plus grande est la forme tout à fait précise de cette distribution qui n'est pas une gaussienne qui a une que Particulièrement longue ici pour les longs temps de réaction est bien cette forme on n'en rend très bien compte par ces modèles de diffusion et la boucle est bouclée lorsque
dennis norris reprend ses simulations et montre que les paramètres qu'il faut injecter dans la simulation sont pas du tout aléatoire mais sont ce qu'ils sont dérivées des paramètres du lexique manteau du lexique mentalement alors simulation de la décision lexical je rentre Alors encore peut-être pas totalement dans le détail mais on voit que comment est ce qu'on va faire pour simuler une tâche particulière par exemple la personne doit appuyer sur le bouton de gauche pour dire c'est un mot et sur le bouton de droite pour dire ça n'est pas un mot et bien le modèle bayésiens
nous dit exactement comment faire il faut calculer la probabilité que la réponse gauche soit correcte étant donné les entrées on n'a pas besoin de calculer la Probabilité qu'un mot particulier soit reconnu et ça c'est assez intéressant c'est à dire que la tâche de décisions lexical contrairement à ce qu'ont pensé pendant de nombreuses années ne demande pas nécessairement de savoir de quels maux il s'agit elle demande simplement de savoir s'il ya de bonnes chances que ce soit un mot ou pas et donc ça n'est pas la même tâche que d'identifier le mot ou de répéter le
mot ou de nommer un mot particulier c'est une tâche Particulière et on peut rendre compte donc deux de la vitesse avec laquelle des personnes prennent leurs décisions en modélisant correctement la probabilité que la réponse mot soit la bonne étant donné les entrées alors il faut aussi tenir compte du fait que la réponse non mot soit la bonne étant donné les entrées ce qui suppose un modèle interne des pseudos mots là il ya tout un travail qui est réalisé par dennis Norris je vais pas rentrer énormément dans le détail parce que vraiment ça concerne les spécialistes
mais il faut penser que suivant les noms mots qui sont choisis dans l'expérience la plausibilité des entrées étant donné l'hypothèse que c'est un bon mot qu'on a sous les yeux n'est pas la même et donc ça va changer radicalement la tâche et on arrive à rendre compte de cette manière là de toute une littérature psycholinguistique qui montrent que la Tâche de décisions lexical varie dans ses caractéristiques suivant la nature des pseudos mots que l'on a choisi d'injecter dans l'expérience il n'y a pas que les mots qui contient aussi les pseudos mans et puis je voudrais
terminer en mentionnant un effet tout à fait classique qui s'appelle l'effet de voisinage qui est en effet mystérieux et qui n'a pas été bien compris jusqu'à présent alors qu'est ce qu'on appelle voisin orthographique ce sont des mots Qui ne diffèrent que d'une lettre par exemple le mot chat et le moche a alors été remarquée depuis bien longtemps que les confusions qui sont fait lorsqu'on entend qu'on lit un mot ont tendance à être des voisins et il ya des mots qui n'ont pas de voisins par exemple le mot froid n'a pas de voisins et le nombre
de voisins va avoir une influence considérable sur la décision lexical alors ce qui est curieux c'est qu'ils avaient été notées depuis longtemps C'est que cet effet de voisinage varient suivant la tâche si vous êtes en train d'identifier un mot donc par exemple vous devez répéter ou nommer un mot qui est écrit et bien la décision se ralentit à mesure qu'un mot a beaucoup de voisins donc plus un mot et de voisins plus la décision est ralentie c'est ce qu'on appelle un effet inhibiteur et on peut le montrer même dans des tâches écologiques comme la lecture
naturel par Contre dans la tâche de décisions lexicale et là la confusion a commencé l'effet du nombre de voisins n'est pas le même suivant qu'on a affaire à un mot ou un pseudo mot pour les mots typiquement la décision s'accélère lorsqu un mois beaucoup de voisins commencent à rentrer dans une sorte de confusion étrange pourquoi est-ce que la capacité de nos mails moss ralenti avec le nombre alors que la capacité de décider si c'est un mot ou pas S'accélère le nombre de voisins et puis encore plus compliqué pour les nombreux celle inverse pour les noms
mots si on compte le nombre de voisins qui sont des mots pour un pseudo mode n'est bien l'addition se ralentit lorsque n y croient et puis encore plus compliqué des gens comme johnson et puke par exemple on trouvait que ça dépend des du choix des pseudos mots s'ils ont choisi des noms mots qui sont non prononçable c'est pas la même chose que s'ils ont Choisi des nombres qui sont prononçable et cetera et c'est donc très grande confusion je crois que c'est honnête de le dire dans la littérature sur l'origine de ces changements des effets de
voisinage des mots suivants la tâche et suivant la nature exacte de l'expérience eh bien tous ces effets tombe dans l'escarcelle naturel du modèle bayésiens et je voulais terminer là dessus c'est assez facile à comprendre je vais juste essayer de Booster en quelque sorte votre intuition de ce domaine imaginez un espace lexical dans lequel tous les points ici donc dans ce très vaste espace qui pourrait être encore donné hyper multidimensionnelle qui seraient tous les big g possible des mots par exemple et chacun de ces points est un mot les coordonnées d'un mot un endroit où les
le nombre de voisins et grands c'est un endroit dans lequel donc il ya beaucoup de mots qui occupent des positions Proches à quelques lettres près voilà un endroit de au voisinage et voilà un endroit de ba voisinage des mots alors maintenant imaginer que la tâche soit de nommer un mot particulier donc les entrées tombe ici et vous devez juste nommé si c'est ce mot là aussi c'est ce mot là aussi cela est tout à fait évident que l'effet de voisinage va être inhibiteur ici c'est à dire que plus il ya des voisins puis ça va
être difficile de choisir de Quel mot il s'agit pour le nommer par contre pour les faits de décisions lexical ce exactement inverse on les fait décision ex ical s'il s'agit de dire est-ce que l'entrée que je reçois est un mot ou pas et bien s'il entrait tombe dans ce voisinage là la probabilité que ce soit un mot est immédiatement élevé puisque il ya beaucoup de mots dans le voisinage je n'ai pas besoin de savoir de quels maux il s'agit particulier j'ai juste besoin De calculer la probabilité que ce soit un mot immédiatement ma décision va
être augmenté et inversement si les entrées tombe dans ce genre de voisinage là la probabilité que ce soit un mot et paie plus diminué alors on voit immédiatement aussi que ça va dépendre du modèle des pseudos mots si je sais que tous les pseudos mots qui peuvent apparaître dans l'expérience sont toutes ses positions intermédiaires qui ne sont pas des mots donc ce sont des choses qui ressemblent À des monts donc si les pseudos mots vont ressembler au mot et bien je vois que ces effets vont apparaître de façon majeure par contre si les pseudos mot
occupent des positions complètement différente dans l'espace peut-être ce sont des chaînes de consonnes non prononçable et bien ces effets vont être radicalement modifié et on peut prédire de quelle manière exactement ils vont être modifiés et en ce qui est fascinant c'est de voir que le système de décision De l'adulte humain tient compte de ce genre de statistiques lorsque nous faisons quelque chose d'aussi simple que en une demi-seconde décider si une chaîne de caractères est ou n'est pas un mot du lexique du français est bien notre cerveau réalise ce type d'opération il tient compte il pondère
la plausibilité qu'on soit dans un espace lexical où il ya beaucoup de mots il y en a pas beaucoup donc quelque part le modèle bayésiens Simplifie les choses en montrant une équation générique qui permet de rendre compte de tous ces aspects différents de l'accès au lexique quelque part aussi il déplace le problème vers le système de décision il va falloir et ce n'est pas fait pour l'instant à comprendre comment sur la base de quelques instructions verbales ont dit à une personne clique et à gauche si c'est un mot cliquez à droite si ça n'est pas
un mot le système se Configure pour créer des pondérations optimale qui réalise cette implémentation bayésiens alors bon donc je veux pas sur ces diapositives qui montrent que ça marche bien juste mentionné que dans des publications plus récentes de nice norris à généraliser cette approche non seulement à la reconnaissance lexical de mots écrits mais également à la reconnaissance de mots parlés alors la reconnaissance des mots parlés ne pose Pas de problème particulier sauf que l'information se déroule dans le temps on n'a pas toute l'information d'un coup donc si on imagine cet espace multi dimensionnelle toutes les
coordonnées ne sont pas donnés en même temps ça se déroule dans le temps alors il faut tenir compte du fait en particulier que non seulement les mots sont en compétition mais des chaînes de mots comme catalogue peuvent être en compétition avec un mot unique catalogue De nice norris fait à peu près les bonnes mathématiques qu'il faut c'est pas mon avis c'est pas parfait il ya du travail pour les théoriciens pour vraiment nettoyés les prédictions théoriques encore un petit peu plus qu'elles le sont dans ces articles mais ils simulent surtout ces données et il montre en
particulier que les expérience humaine se conforte avec les prédictions du modèle bayésiens lorsque vous entendez par exemple le cadre de Bench et que bench est un mot relativement rare dans le lexique il ya des mots plus fréquents comme bed c'est un voisin fréquents et bien si on mesure le temps du regard des personnes pour regarder parmi ces images le molly vol un objet lit un objet banc un objet cloche un objet omar ici donc belle belle lobster et bench on voit que le regard de la personne avant de se diriger vers le bon le bon
objet qui est banshee si le regard de la personne va Transitoirement se diriger vers le compétiteur de haute fréquence et à confondent on est capable de mesurer par le regard de la personne ce processus de compétition interne qui se produit avec un mot intermédiaires qui est le mot bed qui n'est pas le bon mot mais qui parce qu'il est fréquent transitoirement à une plausibilité un petit peu grande jusqu'à ce qu'on entende la fin de l'entrée bench et qu'on soit capable de l'éliminer complètement et de converger Vers le bonbon donc ce sont des données qui sont
assez classiques et toute une série d'expériences qui utilise ces méthodes en temps réel pour essayer de tracer le profil d'activation dans notre tête de différents items lexicaux est frappant de voir que le modèle bayésiens peut rendre compte de ces profils alors qui a pratiquement pas de paramètres libre dans ce modèle mais c'est un modèle qui est un modèle proche de l'optimalité de ce qu'il faudrait faire Si on est un bon bayésiens face à des mots alors je termine donc en disant qu'aujourd'hui nous avons vu en quelque sorte de nouveaux succès pour la théorie bayésienne il
faut donc penser que avant l'explosion lexical l'enfant dans la première année de vie compile des statistiques sur les candidats pour les mots de sa langue et une hiérarchie l'hypothèse sur les objets les concepts auxquels ces mots peuvent se référer Dans des modalités donc distincte et puis dans la phase explique sical ces deux ensembles vont être mis en relation et la théorie bayésienne peut expliquer la vitesse avec laquelle ça se produit parce que en fait très peu d'entre elles suffisent à sélectionner très rapidement parmi l'espace des modèles possibles et les contraintes et hiérarchique que le cerveau
de l'enfant applique pour contraindre ses apprentissages et une fois qu'on tient compte de ces Contraintes le problème de l'apprentissage est radicalement simplifié ne paraît plus aussi complexe que ça pouvait être le cas au départ et puis à l'âge adulte la théorie balises yen continue de rendre compte de l'apprentissage le mot nouveau n oublions pas ça on a vu des expériences sur l'apprentissage de mots nouveaux chez l'adulte et les adultes se comporter à nouveau de manière bayésienne et puis de la manière dont Les mots sont reconnus en temps réel de la manière dont on sélectionne une
coordonnées particulière pour un mot dans l'espace du lexique mental merci de votre attention [Applaudissements]