Nachdem wir uns hash funktionen angesehen haben wollen wir uns jetzt überlegen wie wir mit kollisionen umgehen beziehungsweise welche verschiedenen möglichkeiten wir haben um kollisionen zu behandeln dazu machen wir uns zuerst noch mal klar dass wir mit kollisionen rechnen müssen und ich möchte da zum beispiel verwenden dass ihr wahrscheinlich kennt und zwar das geburtstags problem Die fragestellung ist wie viele personen müssen sich mindestens in einem raum aufhalten damit die wahrscheinlichkeit dass zwei oder mehr von ihnen am gleichen tag geburtstag haben größer als 50 prozent ist diese wahrscheinlichkeit zwei oder mehr von ihnen am gleichen tag geburtstag
haben das entspricht einer kollision wenn man das problem nicht kennt dann ist die antwort auf den ersten blick erstaunlich es genügend nämlich schon 23 Personen das heißt wenn ich wenigstens 23 personen in einem raum habe dann habe ich schon die wahrscheinlichkeit von knapp über 50 prozent dass es und kalender eine kollision gibt also dass wenigstens zwei von diesen personen am gleichen tag geburtstag haben bonns diese wahrscheinlichkeit für eine kollision über die anzahl leute im raum ansehen Die blaue linie dann sehen wir dass die sehr schnell gegen die einst geht also gegen eine sichere kollision spätestens
dann wenn wir genauso viele leute im raum haben just a game ja gibt 365 schaltet dann immer mal aus und noch eine weitere person in den raum kommt spätestens dann muss es sicher eine kollision geben also ab hier ist diese funktion tatsächlich 1 dieses beispiel zeigt uns dass wir in der regel davon ausgehen müssen dass Kollisionen stattfinden also müssen wir sie auch irgendwie behandeln hier haben wir gefragt nach mindestens einer kollision die annahme war dabei dass wir eine gleichverteilung der geburtstage haben und wir haben gesehen die wahrscheinlichkeit für mindestens eine kollision steigt mit der anzahl
der leute im raum rapide an tatsächlich interessiert uns für die hash tabelle gar nicht die fragestellungen die mir gerade Betrachtet haben aber die aussage bleibt trotzdem die gleiche die wahrscheinlichkeit für kollisionen steigt mit der belegung im raum wenn man das geburtstags beispiel trotzdem nochmal übertragen auf unser cash problem dann ist das hier eigentlich die frage die uns interessiert es sind bereits in personen im raum und jetzt kommt eine neue personen dazu wir fragen wie hoch ist die Wahrscheinlichkeit dass keine der bereits anwesenden personen am gleichen tag wie diese person geburtstag hat das bedeutet dass keine
der in personen am gleichen tag geburtstag haben darf dieser tag ist einer von 365 tagen das heißt für alle anderen personen bleiben noch 364 von 365 möglichkeiten und dementsprechend ist die wahrscheinlichkeit dass keine der bereits anwesenden personen am gleichen tag geburtstag hat also die Wahrscheinlichkeit für keinen kollision schreibt es hier als von nicht gleich 364 365 m uns interessiert hier das gegen ereignisse also wir wollen wissen wie hoch ist die wahrscheinlichkeit für eine für eine kollision und das ist einfach eins - die wahrscheinlichkeit dafür dass es keine kollision gibt und wenn wir uns das auch
wieder grafisch anschauen dann sehen wir eine kurve die so aussieht Die blaue linie zeigt wieder den grafen einer wahrscheinlichkeit funktion die mir an gibt die wahrscheinlichkeit dass es bei der nächsten person die den raum betrifft eine kollision gibt also dass eine andere person im raum am gleichen tag geburtstag hat übertragen auf unser hash tabelle bedeutet das wir haben hier eine tabelle der größe 365 dass wir die tage im jahr das sind die möglichkeiten für geburtstage und wir haben in personen Die tatsächlich schon im raum sind das ist quasi der füllstand unserer tabelle und wir messen
die wahrscheinlichkeit für das nächste dass beim nächsten einfügen in die tabelle eine kollision auftritt hier ist immer dass diese funktion sehr viel langsamer gegen die 1 strebt und tatsächlich die einst also ist das sichere ereignis nie erreicht denn es besteht immer eine sehr geringe wahrscheinlichkeit dass alle personen ja sag mal an 364 tagen Geburtstag am und für die nächste person immer noch ein tag frei ist die wahrscheinlichkeit ist gering dass es solche freien plätze noch gibt die mehr personen im raum sind aber sie ist immer noch da jetzt wollen ein kleines bisschen abstrahieren und zwar
wir haben hier 365 tage im jahr und füllen unseren raum entsprechend mit leuten und wir wollen eine neue größe einführen den sogenannten füllgrad unserer tabelle Unsere tabelle hat die größe m m sind hier die anzahl tage im kalenderjahr und gleichzeitig einen füllstand n das sind die anzahl leute die gerade im raum sind also die an geburtstage wir in den kalender eintragen aus diesen beiden zahlen bilden wir den quotienten n geteilt durch m und das ist der so genannte füllgrad der tabelle den kürzen üblicherweise mit alpha ab auf englisch heißt erfüllt lot faktor wenn 365 leute
im raum sind dann habe Ich dementsprechend einen füllgrad von 1 wenn die doppelte anzahl von leuten im raum sind 730 leute dann habe ich entsprechend einen füllgrad von zwei der füllgrad misst also die relative auslastung unserer tabelle ohne dass man tatsächlich im und in als größe angeben müssen wir sehen entsprechend auch hier könnten wir die horizontale achse nicht über die anzahl einträge die anzahl leute im raum laufen lassen sondern über dem füllgrad Mit steigendem füllgrad nimmt die wahrscheinlichkeit für kollisionen zu wir werden uns als nächstes verschiedene möglichkeiten ansehen kollisionen zu behandeln wir können die kollision
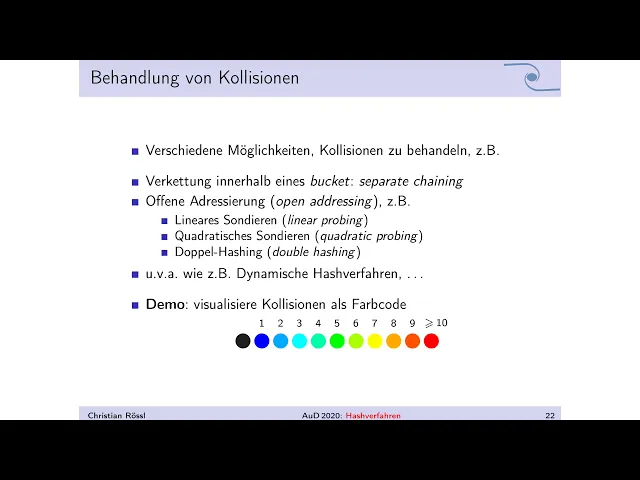
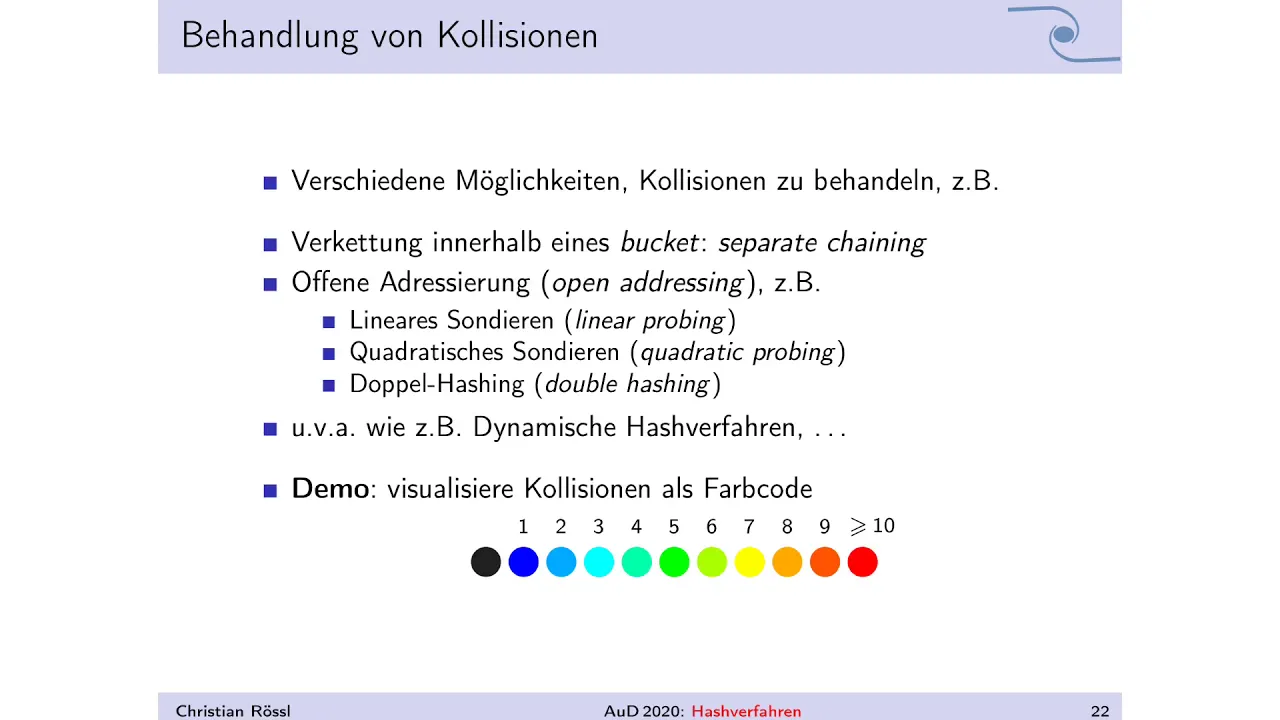
nicht vermeiden wir müssen irgendwie damit umgehen dabei schauen wir uns zwei prinzipielle möglichkeiten an das sogenannte check separat training und die so genannte offene adressierung ich möchte an dieser stelle noch mal kurz auf das demo verweisen hier könnt ihr Mit verschiedenen tabellen größen verschiedenen anzahl einträgen in der tabelle verschiedenen funktionen experimentieren und euch die kollisionen auch visualisieren lassen dabei zähle ich die anzahl der kollisionen auf einen bestimmten index der tabelle und verwenden im carport um zu sagen es hat eine kollision gegeben zwei kollisionen und so weiter von blau nach rot wenn es immer mehr auf
die art und weise können auch noch einmal nachvollziehen wie gut Eine hash funktion streut oder ob sich tatsächlich die hash werte auf einzelne indizes der tabelle konzentrieren die erste methode zur behandlung von kollisionen ist die sogenannte verkettung der überläufer oder auf englisch separate die idee ist ganz einfach unsere tabelle hält jetzt nicht einzelne schlüssel sondern jeder tabellen eintrag speichert eine liste von schlüsseln oder eine liste von einträgen in unsere hash tabelle Diese tabellen einträge die werden auch oft backes genannt bucket auf englisch eimer bedeutet einfach ich kann in so einem baguette beliebig viele schlüssel speicher
und was ich hier anbietet ist tatsächlich einfach verkettete liste zu verwenden also tag den ersten eintrag und wenn noch einer kommt dann trage ich die nächsten eintrag ein und so weiter es reichte einfach verkettete liste das heißt tatsächlich wenn man das effizient machen wollen wird man natürlich immer Am anfang der liste einfügen nicht so wiest hat gezeichnet habe ich wollte einfach nicht lassen müssen das heißt jeder eintrag in meinem feld hält eine verkettete müsste also die ganz einfache datenstruktur das ist ein schönes beispiel dafür dass man eine verkettete liste manchmal doch noch mal zu fuß
implementiert und nicht nur bestehende datenstruktur verwendet diese verkettung hier so einfach dass eine separate janning tatsächlich eigentlich Immer so implementieren würde dass man nicht nur listen datenstruktur verwendet sondern dass gerade zu fuß macht ich könnte an der stelle natürlich auch eine kompliziertere datenstruktur verwenden denn wir wären gleich sehen in diesen listen müssen wir nach versuchen das heißt ich könnte eine sortierte liste oder den zug bauen verwenden so dass ich eine binäre suche verwenden könnte oder effizienter suchen kann ich möchte das hier gerne ein klammern Weil in aller regel lohnt sich das nicht der clou an
der ganzen sache ist wir wollen diese listen sehr kurz halten wie funktioniert diese verkettung der überläufer eine verkettung der kollisionen wir haben drei operationen die uns interessieren wir wollen einträge einfügen suchen und löschen können wenn man den eintrag einfügen dann berechnen ich für den entsprechenden Schlüssel den hash wert und sortier den schlüssel oder den eintrag an dem entsprechenden index in das budget ein das heißt wenn man einfach verkettete liste dort stehen haben fügen am anfang dieser müsste ein wenn es dabei keine kollision war ist die liste leer wenn es eine kollision gab dann hat es
in diesem paket schon ein mindestens ein eintrag das heißt ich füge in eine nicht leere liste ein und das waschen einfügen ist ganz einfach Index bestimmen mit hilfe der hash funktion und in eine einfach verkettete liste vorne einfügen als nächstes das suchen wenn ich nach dem eintrag suche berechne ich auch wieder den entsprechenden hash wert den index in einer tabelle danach suche ich in der entsprechenden liste jetzt würde ich das ich habe schon gesagt mach dir in der regel wenig sind eine vorgefertigte listen datenstruktur Zu verwenden sondern die verkettung macht man zu fuß macht man
selber das heißt wenn ich eine lehre liste stehen habt dann hätte ich ihn java in dem entsprechenden feld eintrag 0 referent stehen dann sehe ich sofort da steht nichts da brauche ich gar nicht weiter suchen die suche erfolglos wenn in diesem feld aber tatsächlich wenigstens ein eintrag ist dann muss ich die liste die da steht nach diesem eintrag durchsuchen Und zwar muss ich jeden listen eintrag testen also testen ob diese eintrag gleicht der gesuchte eintrag ist so lange bis ich den gesuchten eintrag entweder gefunden habe oder bis ich am ende der liste angekommen bin im
ersten fall ist die suche erfolgreich im zweiten fall ist diese suche erfolglos dieses durchsuchen hier das ist ganz wichtig denn da es kollisionen geben kann ist es möglich Dass verschiedene schlüssel auf den gleichen hash wert abbilden also verschiedene schlüssel sich in eine liste befinden das heißt bin ich nach einem bestimmten schlüssel suche dann kann das immer noch sein dass das ein ganz anderer schlüssel ist der nicht in der liste ist aber auch den gleichen hash wert also gleiche hash werte sagen wir noch nicht dass ein eintrag in meiner hash tabelle ist nur weil die liste
nicht lässig muss die Liste tatsächlich auch durchsuchen an der stelle muss ich natürlich auch wieder sicher sein dass meine hash funktion konsistent ist und der gleichheit redaktion ich brauch hier beides ich muss die hash funktion berechnen um den index das backes zu bestimmen und ich muss danach eine sequenzielle suche starten das heißt einträge tatsächlich auf gleichheit es wir erinnern uns bei der konsistenz hat mir gesagt für gleiche schlüssel müssen Auch die hash werte gleich sein es gilt aber eben nicht die umkehrung deswegen muss ich die sequenzielle suche zu guter letzt wenn man den eintrag aus
der tabelle löschen ist das hier relativ einfach ich suche nach diesem eintrag diese suche sollte erfolgreich sein ansonsten gibt es nichts zu tun wenn ich den eintrag gefunden ablöschen aus der liste aus wenn wir uns noch mal kurz überlegen was kosten uns die operationen Dann geht das einfügen von 1 wenn man davon ausgehen dass wir die hash funktion in konstanter zeit berechnen können denn ich muss nur den index bestimmen und dann vorne in der vergitterte liste einfügen moment stimmt das noch mal nachdenken so wie es gerade erklärt habe das heißt bis hin zu einfach ich
möchte er nicht den gleichen eintrag zweimal einfügen das heißt beim einfügen wird man tatsächlich auch wie das das heißt Bevor wir in die liste einfügen einmal die liste durchsuchen und schauen ob der eintrag nicht schon drinnen steht also sind wir doch nicht von einst sondern wir haben den gleichen aufwand wie die suche welchen aufwand haben wir bei der suche im schlechtesten fall ist man die gesamte liste durchlaufen wenn wir insgesamt in einträge haben in der tabelle der größe m dann können wir bei gleichverteilung der schlüssel also bei gleichmäßiger Streuung der schlüssel über die tabellen einträge
davon ausgehen dass wir in jedem parkett im schnitt geteilt durch einträge haben und dementsprechend müssen wir auch in geteilt durch einträge im schlechtesten fall durchsuchen auch das stimmt wieder nicht ganz denn ich habe jetzt den schlechtesten fall angenommen dass wir die liste bis zum ende durchlaufen müssen wenn unsere hash funktion nicht gut streut Dann können wir nicht davon ausgehen dass wir in durch m einträge in der liste haben das ist ja ein durchschnittswert sondern dann kann es im schlechtesten fall sogar passieren dass wir eine liste der länge enden haben und ausgerechnet in der liste suchen
müssen das heißt wir haben im mittel ein aufwand von von endrich m und wenn ein konstantes sind wir immer noch bei dinge haben aufwand von n Also von daher habe man erst mal nichts gewonnen auch eine kurze anmerkung dieses durch m kennen wir natürlich schon hier haben wir wieder den grad unserer tabelle für das löschen haben den gleichen aufwand wie versuchen denn wir müssen ja eine erfolgreiche suche erst durchführen danach hat man auch mal konstanten aufwand um den eintrag aus der liste zu löschen ich habe jetzt hier ein paar mal Zurückgezogen und mich wieder korrigiert
bzw erst die scheinbar in scheinbar einfachen fall erklärt und dann gesagt das ist tatsächlich doch ein bisschen komplizierter tatsächlich ist es so dass cash verfahren oder die analyse von hess verfahren obwohl die algorithmen tatsächlich sehr einfach sind diese analyse schnell kompliziert werden kann für das separat training für die verkettung der überläufer ist noch Relativ einfach für die offene adressierung hört sie deutlich schwerer wir werden uns den wir hier in der vorlesung nicht machen beziehungsweise nur so pi mal daumen rechnen und paar daumen regeln uns auch anschauen ohne dass wir die tatsächlich beweisen werden schauen wir
uns jetzt ein beispiel wir haben eine tabelle der größe hängt gleich sieben das heißt wir haben sieben tabellenplätze 7 Backes indizes von 0 bis 6 und wir wollen die zahlen 9 12 323 5 40 10 und 21 einfügen dazu verwendet man als hash funktion wieder zahl modulo 7 das heißt 9 modus 79 geteilt durch 7 bis 12 und so weiter hier habe ich alle grad durchgerechnet also alle zahlen modul 7 und jetzt fügt der reihe nach ein also die neuen wird abgebildet auf den index 2 als wir führen hier in die verkettete liste gegen die
zwölf wird abgebildet auf den Index 5 und wir fügen in die liste ein die drei wird abgebildet auf den index 3 die 23 auf den index 2 da steht die neuen schon drin wir fügen jetzt machen das tatsächlich so wenn man uns gesagt haben oder wie effizient wäre wir fügen vorne in der liste ein es ist effizient vorne einzufügen ist es für mich nicht ganz so effizient dass auszuzeichnen weil ich muss dazu einmal löschen aber wir wissen einfügen in einfach verkettete liste geht in ruf von Einzelner vorne einfügen so die fünf steht an der stelle
fünf dann machen wir genau das gleiche also die fünf steht vorne dann kommt die zwölf die wir schon eingefügt hatten jetzt kommt die 40 in die gleiche liste ein die zehn kommt an die stelle 3 und schließlich die 21 in die liste am index 0 und so sieht unsere hände aus wenn wir jetzt wissen wollen ob die zwölf in unserer tabelle ist dann müssen Wir suchen das heißt wir berechnen den hash wert zu zwölf das ist die 5 und schauen uns das paket an der stelle 5 1 bedeutet wir müssen diese liste hier durchsuchen und
schauen ob er den eintrag 12 finden also müssen schon 40 ist ungleich 12 5 ist ungleich 12 12 ausgleich 12 und wir haben die zwölf gefunden wenn wir nicht nach der 12 suchen sondern nach den 19 19 mono 17 model 719 geteilte 7 ist 25 dann muss man dieselbe Liste durchsucht wir haben auch wieder das paket am index 5 und durchsuche die gleiche liste 40 es ungleich 19.5 es ungleich 19 12 ist ungleich 19 und am ende der liste also ist die 19 nicht in unserer tabelle wenn man stattdessen nach der 8 suchen 807 ist
1 dann sind wir schneller denn wir müssen hier nur am index 1 nachschauen dame gleich leere liste und wir wissen sofort die acht ist nicht in unserer tabelle Wie gesagt gleiches muss ich eigentlich auch beim einfügen machen weil wenn ich jetzt hergeht und die zwölf zum beispiel nochmal einfügen möchte dann sollte ich das natürlich nicht tun jeder eintrag schon einmal in der hash tabelle sei also die mengen semantik möchte ich hier und ich möchten abstrakte datentypen set implementieren können das heißt beim einfügen das habe ich gerade nicht gemacht musste ich auch Noch jede liste erst
überprüfen ob der eintrag denn schon da ist wenn ja füge ich ihn nicht noch mal ein wenn man jetzt den eintrag löschen wollen nehmen mal hier die 5 die wollen aus der liste löschen dann schauen wir wieder die fünf finde ich in dem paket an index 5 das heißt ich laufe auch wieder durch meine liste und sucht die 540 ist ungleich 55 ist gleich fünf ich habe die fünf gefunden ich kann so löschen wenn ich mir den Vorgänger in der liste gemerkt hab dann sollte ich dir jetzt einfach indem ich diese referenz hier umwege also
löschen außen einfach verketteten liste und ich bin fertig wie gesagt es ist eine sehr einfache datenstruktur hier sehen wir das gleiche beispiel noch mal allerdings habe ich hier am ende der liste eingefügt also nicht wie das mit einfach verketteten ist normalerweise machen würden sondern wie es mit papier und stift bisschen einfacher geht Wenn man zusammenfassen es dieses separate janning vor allem eins es ist sehr einfach zu implementieren ich kann sehr leicht einfügen ich kann sehr leicht löschen ich muss mit tabellen mit rx umgehen können und ich muss einfach verkettete listen verstanden haben das ganze ist
vor allem sehr gut allgemein einsetzbar deswegen wird separat training in sehr vielen bibliotheken verwendet immer dann wenn eine hash tabelle grundlage zum Beispiel für eine mengen datenstruktur oder für so was wie eine map wurden dictionary ist ist dahinter in aller regel separat vor allem immer dann wenn ich nicht weiß wie oft ich einfügen und löschen muss wie oft sich meine tabelle im lauf der zeit verändert oder wie dynamisch sich meine tabelle verändert ist separat chaney man gehe ich immer guter kompromiss es kann dabei nur sehr wenig schiefgehen ich kann fehler machen dazu komme gleich Diese
fehler tun auch weh aber sie bedingen höchstens mit zeitstrafe sie machen mir nix tatsächlich kaputt anders als bei der offenen adressierung möglich ich kann tatsächlich in konstanter zeit einfügen dabei zähle ich grad nicht die zeit die ich brauche um mich zu gewässern dass der eintrag den ich einfügen er möchte nicht tatsächlich auch in der liste Ich habe hinten noch stehen ohne mögen der spezielle sortierung der liste so eine sortierung ist in aller regel auch nicht sinnvoll sondern ich vorne in die einfach verkettete liste ein wir haben uns für den aufwand schon ein bisschen dass überlegt
tatsächlich reduziert sich die anzahl der vergleiche im vergleich zu einer sequenziellen suche für support training im mittel um den faktor m dazu stellen wir uns vor würden wir eine Sequenzielle suche auf unseren daten machen und die daten liegen in einer verketteten liste dann müssten wir im schlechtesten fall alle in knoten der liste durchsuchen jetzt aber nicht eine liste sondern wir haben im backes in unserer tabelle also m kleinere listen wir haben die annahme dass unsere hash funktion gut streut das heißt alle einträge möglichst gleichmäßig über die ganze tabelle verteilt das heißt wir gehen davon aus
dass jede liste im Mittel 1 geteilt durch im einträge hat und ich muss einmal bestimmen in welcher liste ich so nämlich die hash funktion auswerte das geht in konstanter zeit danach muss ich die liste durchsuchen und ich muss jetzt eben nicht mehr wie sequenzieren fallen in ein träges durchsuchen sondern in geteilt durch in einträge im schlechtesten fall bin ich immer noch bei den einträgen nämlich dann wenn ich eine schlechte hash funktion hab oder fügen wiegands Ungünstige schlüssel erwischt hat es ist sehr unwahrscheinlich wenn meine hash funktion gut ist aber es kann immer noch passieren dass
ich tatsächlich nur eine lange liste hat oder dass dieses aufteilen auf die listen nicht klappt es kann sein aber es ist unwahrscheinlich wir erwarten tatsächlich dass unsere listen im schnitt länge von n durch m eine länge von alpha das war unser füllgrad haben trotzdem gilt natürlich asymptomatisch Dass wir den aufwand von oven haben weil es ist eine konstante aber das nicht so schlecht wie es aussieht dazu kommen gleich noch ein weiterer vorteil von separat training ist dass das löschen sie einfach ist ich brauche keine sonderbehandlung von gelöschten einträgen sondern ich suche einfach und löscht danach
aus der entsprechenden liste schauen wir uns den aufwand noch mal genauer also wir haben unseren füllgrad N geteilt durch cam die nennen wir alpha und unter der annahme dass unsere hash funktion gut streut können wir erwarten dass unsere listen im durchschnitt eine länge von alpha h es ist tatsächlich was was wir mit hoher wahrscheinlichkeit erwarten können wenn wir eine gleichverteilung in den erschwerten haben wir können das zeigen könnte es beweisen das ist nicht ganz einfach wir machen das hier in der vorlesung nicht aber es ist mehr als etwas was im Durchschnitt passiert es ist etwas
was wir mit einer hohen wahrscheinlichkeit erwarten können also wenn wir alles richtig machen wenn keine gute hash funktion haben dann sind unsere listen mit hoher wahrscheinlichkeit nicht viel länger als alpha als in durch m der durchschnittliche aufwand für eine suche ist 1 + alpha einmal muss ich in jedem fall nachschauen nachdem ich die hash funktion ausgewertet habe und dem Entsprechenden und im entsprechenden bucket nachgeschaut hat danach muss ich im erfolglosen fall die liste einmal durchgehen alle einträge durchgehend im erfolgreichen fall muss ich etwa die hälfte der einträge durch die in die formel die hier steht
nicht ganz genau tatsächlich spielt es auch keine rolle ob welche alpha oder alpha halbe stehen haben es wird nämlich gleich darum gehen dass Wir ihm dieses alpha diesen füllgrad möglichst klein halten sodass wir erwarten können dass die listen tatsächlich kurz bei und das ist genau der andere schlüsse neben der wahl der hash funktion der dafür sorgt dass cash tabellen zur suche funktioniert in der praxis mache ich diese tabelle nämlich nicht voll ich möchte einen füllgrad der kleiner ist als 1 damit kann ich auch erwarten dass meine listen mit hoher Wahrscheinlichkeit kurz oder sehr kurz bleiben
beziehungsweise das mit hoher wahrscheinlichkeit die länge der liste durch eine kleine konstante beschränktes wenn die tabelle größer ist als der teils die anzahl einträge und meine hash funktion gut streut bedeutet das natürlich gleichzeitig auch dass die wahrscheinlichkeit für kollisionen geringer ist eine daumenregel die man hier verwenden kann ist wir machen unser hash tabelle nicht größer voll als bis Zu drei viertel wollen keinen füllgrad der größer ist als drei viertel da bleibt die frage was machen wir dann wenn man den nächsten eintrag einfügen wollen in dem fall baumann die tabelle einfach neu auf das heißt wir
erzeugen eine neue eine größere tabelle und sortieren alle einträge dort ein und dann habe er wieder in füllgrad der entsprechend kleiner ist und wir haben listen von denen wir erwarten können dass kürzer sind Dieser vorgang dieses neu aufbauen der tabelle immer dann den der füllgrad zu groß wird der heißt auch wäsche vorsicht wenn ich dieses recession beim einfügen automatisch mit anstoßen dann kann es natürlich passieren dass einzelne einfüge operationen wenn linearen aufwand haben nämlich immer dann wenn die tabelle neu aufgebaut wird das hat in jedem fall den jahren aufwand ich muss jeden schluss nur einmal
in die neue tabelle eintragen Die situation ist ähnlich wie bei unseren vector kennen wenn die kapazität nicht erreicht muss ich um kopieren hier eine neue hash tabelle aufbau und die lösung damit das nicht allzu weh tut ist auch die gleiche wir sorgen dafür dass diese neue tabelle tatsächlich deutlich größer ist das heißt hier vergrößern sie um den faktor zum beispiel wählen eine tabelle die etwa doppelt so großes nicht genau doppelt so groß weil wir wollen ja dabei bleiben dass die anzahl einträge In meiner hash tabelle mit princess also wir machen sie doppelt so gross und
nehmen die nächste primzahlen die dieser neuen größe am nächsten kommt was passiert wenn ich das racing verschlafen naja dann passiert erstmal nix meine listen werden nur länger das heißt die suchen werden weniger effizient ich brauche mehr zeit aber es geht tatsächlich nichts kaputt also auch hier gilt das gleiche wie für den vektor es Ist gut wenn ich vorher etwa schon weiß wie viele einträge in meiner tabelle liegen werden dementsprechend wähle ich die größe schon mal groß genug dass ich jedem möglichst nicht beherrschen muss und auch hier gilt wenn es irgendwie geht möchte ich dieses beherrschen
das neu aufbauen nicht werten einfüge operation machen sondern vielleicht irgendwann wenn ich weiss es tut mir grad nicht wie ich habe die zeit dafür prüfe ich nochmal könnte sein dass ich Demnächst wie hirsch muss und wenn ja dann mache ich das einfach schon mal die zweite möglichkeit der koalitions behandlung ist die so genannte offene adressierung oder puppen etwas in und im gegensatz zum separat training zur verkettung der überläufer brauche ich hier keine sekundäre datenstruktur also keine liste sondern ich verwende tatsächlich nur das re und die idee ist erstmal sehr einfach wenn es eine kollision gibt
also ich möchte einen Eintrag in die tabelle einfügen aber am entsprechenden index das steht schon was drin dann suche ich einfach nach einer alternativen adresse nach dem neuen eintrag nach einem neuen index nach einer bestimmten vorschrift die natürlich für jede suche immer wieder gleich sein muss so dass sich die einträge später auch wieder finden wir schauen uns hier verschiedene möglichkeiten an wie diese alternativen Adressen berechnet ermittelt werden können und zwar einmal lineares sondieren quadratischer sondieren und das so genannte doppel herrschen diese offenen adressierung verfahren sind einmal die einfachere datenstruktur im vergleich zum supply chain allerdings
dürfen keine fehler machen einmal kann es passieren dass die tabelle irgendwann voll ist dann müssen wir die hessen das ist kein kann sondern ist ein muss wenn ich habe voll ist ist Voll also muss man sich irgendwie vergrößern und zum anderen werner sehen dass das löschen aus einer tabelle plötzlich deutlich komplizierter ist dann muss man aufpassen dass wir keine fehler machen als daumenregel offene adressierung eignet sich besonders dann wenn wir es tabellen anliegen in denen wir hauptsächlich suchen also die wir einmal aufbauen aber die wir eher wenig verändern wurde wenig Zwischen nach noch einfügen oder
löschen schauen wir uns jetzt die verschiedenen sondierungen an wir fangen an mit dem linearen sorgt die sondieren auf englisch linear probe was bedeutet sondieren oder pro ging das bedeutet wenn für einen schlüssel iks der entsprechende index sei von iks diese entsprechenden adresse schon besetztes also wenn es eine koalition gibt da steht schon was dann suche ich mir einen neuen index eine neue adresse und dazu Zähle ich beim linear problem einfach linear weiter also auf den index zähle ich eins drauf schauen ob ich dort was frei haben ein ziemlich 2 drauf schaut was drauf und dort
verstehen hat und so weiter und so fort ich gehe also einfach immer bis zum nächsten tabellen eintrag so lange bis ich einen freien eintrag gefunden habe ich kann's allgemeiner noch schreiben tatsächlich werde ich eine lineare funktion aus ich muss nicht 1 addieren Sondern ich kann auch jeweils eine konstante addieren oder mal eine konstante auf meine hash funktion addieren im eaton versuch dabei ist allerdings auch wieder wichtig dass ich diese konstante so wählen dass ich möglichst über die ganze tabelle laufen kann also dass ich keine zyklen bögen am einfachsten ist hier tatsächlich ich wähle diese konstante
gleich einzig gehe einfach zum nächsten eintrag Schauen wir uns auch hier wieder ein beispiel an wir nehmen das gleiche beispiel die gleichen zahlen gleichen in die cis module unsere tabellen größe in gleich sieben verfügen dabei nach 1 die neuen die zwölf die drei und so neue modul 7 ist 2 am index- 2 steht tatsächlich noch nichts also trage ich hier die neuen zwölf module 7 ist 5 am index- 5 dann steht noch nix also trage ich die 12 13 modelle 7 ist 363 ist auch noch frei ich trage die 323 modus 7 ist 2 jetzt
kriegen wir das erste mal eine kollision denn anderer städte 2 da steht schon lassen also sucht man an der nächsten stelle 2 + 13 da steht auch schon das ersuchen an der nächsten stelle jetzt ist frei jetzt mehr platz die 23 einzutragen also ja mal versucht die 23 einzutragen mussten zweimal weiterspielen als nächstes tragen die fünf ein wenn man die fünf eintragen Wollen geschieht es an index 5 da steht aber die zwölf schon das heißt wir springen 1 weiter da hat man tatsächlich ein fein platz und kriegen die 5 unter wir versuchen die 40 einzufügen
die 40 sollen auch an index 5 einfügen da ist aber kein platz das heißt wir springen weiter und springen noch mal weiter unten raus laufen laufen modulo 7 laufen oben wieder rein und ihren platz um die 40 unterzubringen so jetzt kommt die 10 17 wollen wir Unterbringen am index 3 der ist schon belegt also spring zu 456 weiter zu null und noch ein zweiter zu einst und jetzt am endlich platz gefunden für die 10 wir sehen schon je voller die tabelle wird desto größer wird die wahrscheinlichkeit dass man die kollision haben und desto größer wird
auch die wahrscheinlichkeit dass das man beim sondieren immer weiter und weiter springen müssen bis wir schließlich eine freie stelle gefunden Hier habe es zum extrem getrieben die tabelle ist jetzt voll und für den für die zehn- oder um die zehn einzutragen sind wir tatsächlich eine ganze weile gesprungen bis für den letzten freien eintrag in der tabelle gefunden haben das ist natürlich genau die situation die wir nicht haben wollen deswegen es wird auch offene adressierung vor hier das lineare sondieren immer so sein dass wir die tabellen größe so wählen dass es größer ist als die anzahl
einträge die Wir tatsächlich in der tabelle speichern wollen so wir haben hier immer noch die 21 die wir noch gerne einfügen wollen die passt jetzt aber nicht mehr rein die tabelle ist voll das heißt wenn ich die 21 tatsächlich noch unterbringen muss dann muss ich jetzt wie hessen das heißt ich mache mir eine tabelle die größer ist also wenn zum beispiel im gleich 13 wieder eine primzahl und für alle einträge die ich in dieser tabelle hat in die neue tabelle 1 und dann soll Die auch platz für die 21 sein macht es einfach selber hier
haben wir das gleiche beispiel noch mal in der linken spalte die tabellen indizes von 0 bis 6 danach die belegung der tabelle wie man es gerade gemacht dann und hier in blau nochmal angezeichnet welche indizes jeweils sondiert haben beziehungsweise jeder pfeil hier ist eine operation im linearen sondieren gerade eben anders die grünen pfeile die Ich gezeichnet habe uns jetzt überlegen welche eigenschaften das lineare sondieren mit sich bringt dann sehen wir müssen so wie gerade eben beim einfügen sondieren aber wir müssen auch beim suchen sondieren das bedeutet wenn man hier in der tabelle nach der 23
suchen 23 modulo 7 gibt 223 suchen wir fangen am index 2 an da steht die neuen die ist ungleich 23 also gehen wir einen eintrag weiter da steht die 3ds auch ungleich 23 also Thema einen eintrag weiter und wir haben die 23 gefunden also nicht nur beim einfügen auch beim suchen müssen wir sondieren was wir jetzt gewesen wenn man nach einem eintrag suchen der nicht in der tabelle ist dann macht man das so lang bis wir auf ein freies feld kommen beim sondieren das jetzt hier schwer weil man die tabelle ganz voll gemacht haben oder
so lang bis wir die tabelle tatsächlich einmal zyklisch durchlaufen sind das ist Hier natürlich genau der schlechteste fall für eine erfolglose suche müssen hier tatsächlich die ganze tabelle durchsuchen selber schuld werden die tabelle nicht ganz voll machen dürfen also beim suchen muss ich sondieren und die sondierung endet im zweifel immer erst dann wenn ich ein leeres feld gefunden hat also wenn ich weiß selbst wenn dann noch jemand was eingefügt hat und dabei sondieren müsste hier war ende war hier War noch niemand so wie es gerade gesagt habe wenn man das so machen wollen ein leeres
feld als and kritieren nehmen dann können wir fordern dass wir nur in kleinen einträge einfügen können dementsprechend hätten hier schon einen eintrag zu viel eingefügt also wir hätten dann immer einen leeren eintrag noch die uns anzeigen würde das eine suche terminiert wir bräuchten nicht den sonderfall das war einmal zyklisch Durchlaufen sind es ist auch egal ob wir jetzt in kleiner im einträge speichern oder bis ihm gleich viele einträge speichern spätestens dann muss die tabelle vergrößert werden gebraucht die hessin denn eine tabelle voll ist also voll bringt keinen antrag mehr rein wie gesagt leben tut das
ganze verfahren das verfahren davon dass wir die tabelle möglichst groß genug so dass wir möglichst wenige kollisionen haben so dass wir beim sondieren auch möglichst Wenig iterationen bei der sondierung brauchen um den eintrag zu finden oder entscheiden zu können dass die suche erfolglos ist auch hier gilt die analyse ist tatsächlich nicht einfach die ist ziemlich trickreich obwohl der algorithmus relativ einfach ist wir schauen uns dann schauen sie uns an der stelle nicht an wir schauen uns nachher noch ein paar formeln an die uns was über den aufwand über die kosten sagen Das große manko bei
den offenen adressierung verfahren ist dass das löschen nicht ganz einfaches es gibt prinzipiell zwei möglichkeiten zum löschen die einfachere ist ein sogenanntes fouls oder lacie löschen ich kann den eintrag nicht einfach rausnehmen aus einer tabelle warum wenn ich den eintrag einfach rausnehmen dann kann es sein dass sich die sondierung skate unterbreche die ich Durchlaufen muss bei der suche nach einem eintrag also beim einfügen habe ich sondiert bin dabei über mehrere einträge darüber gesprungen bis ich schließlich ein freies feld gefunden hat bei der suche mache ich das gleiche wieder wenn ich aber zwischendurch ein freies feld
findet das entstanden ist dadurch dass ich gelöscht habe dann funktioniert die suche nicht mehr dieses faule löschen bedeutet ich lösche ein feld nicht dadurch dass ich den eintrag Komplett raus nehmen und das als lehrer markiert sondern stattdessen lasse ich noch eine andere spezielle markierung zu die mir sagt hier stets war nichts mehr drin aber dieses feld vorher mitgespielt bei der sondierung das heißt ich sorgt dafür dass dieses feld zwar leer ist müssen da steht kein eintrag mit drin dem ich auslösen könnte gleichzeitig aber nicht wer es im sinn von beim sondieren betrachte ich es als
noch voll aber mit einem ungültigen Eintrag so dass ich weiter zu überspringen würde bei der suche das bedeutet im umkehrschluss natürlich dass das löschen die suche nicht effizienter macht wenn ich das so machen warum bedeutet dass faul oder lacie wies hier umschrieben hat weil ich tatsächlich nicht los und dann weil es mir einfach macht ich mag ihren nur als ungültig stadt tatsächlich zu löschen und die suchen wir neben nicht effizienter er kann stattdessen auch Gleich richtig löschen ich habe das hier als sieger eifrig bezeichnet üblicherweise der gegensatz zu was was ich als nazi bezeichnet dass
es allerdings ein kleines bisschen trickreiche man muss aufpassen dass man es richtig macht denn was wir hier machen muss ist wenn ich lösche muss ich dann hinter dem zu lasch einen eintrag noch weiter gehen und alle einträge aufzählen die dadurch eine sondierung gelandet sind und diese einträge muss Ich wieder neu einfügen das sind genau die einträge die sonst durch eine suche nicht mehr auffindbar werden ich mache dazu kein beispielen wir merken uns dass das löschen komplizierter ist und dass wir extra arbeit machen müsst uns extra arbeit machen müssen dass wir gleichzeitig das ganze ja sehr
vorsichtig machen müssen an der stelle kann man schnell den fehler machen das gilt nicht nur für das lineare sondieren sondern das gilt für Alle offenen adressierung gefahren das lineare sondieren ist relativ ist relativ einfaches sondieren ich gehe einfach immer ein zweiter hat aber den nachteil dass es so genannten clustering deutsch vielleicht übersetzen die klumpen bildung führt das heißt da wo ich wo sich einmal wir haben das gerade im beispiel gesehen wo sich einmal was aufgestaut habe weil ich angefangen hat zu sondieren es ist sehr wahrscheinlich dass ich weiter sortieren muss und dann Kriege ich immer
längeren und längere ketten die ich bei der suche auch wieder betrachten muss bedeutet das nützt mir dann vielleicht gar nichts gar nicht mal so viel dass die hash funktion gut streut wenn ich gleichzeitig solche klumpen hab ich nutze die tabelle gegebenenfalls schlecht aus der stelle wenn man gleich ansätzen mit dem quadratischen sondieren und den sogenannten doppel fest aber das machen nochmal eigenschaften Vom linearen sondieren ohne dass wir das hier beweisen haben wir hier formen für die anzahl sondierungen im mittel für eine erfolglose und erfolgreiche suche und er sehe das ganze hält hängt wieder ab vom
füllt alpha und wenn wir uns die formeln anschauen dann sehen dass wir diese diesen aufwand tatsächlich kleinkriegen in abhängigkeit von alpha wir schauen uns das nachher noch als hier kann man da sieht man das ganze schöne jemals nicht auch schön ausmalen Kann es 150 paar werte aus und setzte in die formel 1 und machten so merksätze oder daumenregel traums wie zum beispiel einfügen und löschen mit williams und dir bedeutet benötigt im mittel weniger als fünf sondierungen wenn der füllgrad kleiner als zwei drittel ist gleichzeitig wenn der füllgrad zu hoch wird also zb alpha größer als
80 prozent wird das einfügen und suchen plötzlich dramatisch schlecht da sondern kann bei uns im kleinen beispiel mit dem gleich Sieben gesehen damit schafft muss aber einfügen und löschen im mittel auch wieder in ruhe von 1 zu erreichen und nicht nur im mittel sondern wir dürfen einfügen und suchen in konstanter zeit erwarten und wenn man alpha entsprechend will den füllgrad also nicht zu hoch werden lassen ist die constantia konstante auch entsprechend klein wie gesagt hier oben für alpha kleiner zwei drittel brauchen wir im mittel weniger als fünf Sondierungen allerdings haben wir hier bei jedem einfügen
zwingend den aufwand den linearen aufwand für das beherrschen wenn die tabelle für dieses ein flügen zu groß wird das heißt wir müssen beim einfügen immer testen ob wir noch platz in unserer tabelle haben und wenn nein müssen wir die hessen beim supply chain hatte ich immer noch die wahl das quasi auf später aufzuschieben auch wenn ich dann vielleicht für die nächsten zug Bisschen mehr aufwand habe aber ich musste sich in dem augenblick machen hier muss ich irgendwann zwingend wie hessen ist auch tatsächlich nicht so bild weil wenn ich crash dann wenn die tabelle voll ist
dann habe ich tatsächlich schon was falsch gemacht weil wir haben gedacht wir wollen die tabelle nicht voll werden lassen zb bei dem volk art von zwei triple oder höchstens drei vierteln lassen das quadratische sondieren oder Quadratisch döring hat mir ganz kurz funktioniert im prinzip genauso wie das lineare sondieren das ziel her ist dieses cluster die klumpen bildung zu reduzieren und was man dafür macht ist ich zähle jetzt nicht linear sondern ich zähl quadratisch im einfachsten fall von dierig mit +1 danach +4 danach +9 also +1 grad dass zwei quadrat das 3 quadrat oder in frieden
sondierungs versuch plus e quadrat so lange bis ich einen freien eintrag findet allgemeiner hat dir ich Eigentlich eine quadratische funktion die ich noch mit zwei konstanten eine für den linke- und herren und eigentlich für den quadratischen tern parametrisieren kann auch hier muss man wieder ein bisschen aufpassen dass man diese konstanten nicht ungünstig welt so dass ich durch das auswerten diese quadratischen vorher adriatischen funktion nicht in irgendwelche zyklen kommen also nicht die ganzen essen ich schaffe die ganze tabelle zu durchlaufen Sondern nur einen teil zu durchlaufen das quadratische sondieren verbessert diese clusterbildung deutlich allerdings ist die
noch nicht ganz weg was effektiv hilft ist ein sogenanntes doppel herrsching oder double herrschen auf englisch hier ist die idee dass wir noch eine zweite hash funktion verwenden also wir haben unsere hash funktion habe und gleichzeitig noch eine zweite funktion hat zwei die von h verschieden ist Und die idee ist wenn wir an der stelle half onyx an dem index der kollision haben wenn der eintrag schon gesetzt ist dann testen wir jetzt nacheinander die einträge half onyx plus x und jetzt eine lineare oder quadratische funktion sondern x h 2 phoenix damit das funktioniert ist natürlich
klar diese funktion h2 musik so konstruieren dass niemals einen wert 0 liefert denn ansonsten würde ich hier im nieten schritt gar nichts machen und würde Immer bei half onyx bleiben h2 ist tatsächlich eine hash funktion ich muss nur dafür sorgen dass nicht auf werte von 0 bis abbildet sondern auf werte von 1 bis also das wir nie die null erreichen können eine möglichkeit wie man das machen kann sie mir hier unten wir wählen h2 als die primzahl - ex-model also statt x-modelle coni - x-men doku und haben dann entsprechend den wertebereich von kuh- oder von
1 bis einschließlich stadt von null bis plus 1 Auch wieder ohne dass wir die analyse und tatsächlich anschauen die anzahl sanierungen im mittel sind für das doppel hessing 1 durch 10 karten im erfolglosen fall und 1 durch füllt grabmal der natürliche logarithmisch von 1 - füllt im erfolgsfall das sieht vielleicht auch an den formeln schon dass die analyse nicht ganz so einfach ist wir wollen sie hier auch nicht machen aber wir können wieder einsetzen und dann aussagen treffen wie doppel Hessing binde benötigt die mittel weniger sondierungen als lineares sondieren hier zb weniger als fünf sondierungen
für eine erfolglose suche oder führen einfügen für den füllt von kleiner 80 prozent oder auch weniger als fünf sondierungen für eine erfolgreiche suche gleichbedeutend löschen für einen füllgrad kleine 99% es natürlich trotzdem preis zahlen muss denn ich muss gegebenenfalls zwei hirsche funktionen auswerten darf nicht vergessen Aber man sieht hier wenn ich die tabelle einmal aufgebaut habe und dann fiel in der tabelle suche dann darf ich die tabelle tatsächlich auch ordentlich füllen ohne dass die anzahl der sondierungen tatsächlich ein paar hoch geschafft das immer noch mit relativ wenigen mit fünf sondieren auch hier gilt natürlich werde
ich die tabelle grösse brauche ich mir speicher auch weniger sondierungen werde ich den füllgrad näher an der eins also hör Brauche ich weniger speicher aber dafür mehr regierungen je nach anwendungen mögen die fünf sondierungen guter kompromiss sein oder mögen vielleicht auch schon mehr sein dass ich eigentlich investieren möchte hier sah doppel hessing und lineare sondieren nochmal im vergleich die gestrichelten linien zeigen jeweils den aufwand für eine erfolglose suche die durchgezogenen linien kennzeichnen erfolgreiches und blaues doppel Eschenrod ist lineares sondieren auf der horizontalen achse hat den füllgrad alpha und auf der vertikalen achse den die anzahl
sondierungen also das was ich gerade als aufwand gezählt und was wir sehen ist dass wir für den kleinen füllgrad tatsächlich nur relativ wenig ist und die jugend brauchen bzw für eine hash funktion die gleichmäßig streut mit relativ wenigen sondierungen rechnen dürfen sprich die wahrscheinlichkeit dass es Dramatisch viel mehr sind ist sehr sehr gering wir sehen auf sobald der füllgrad eine grenze überschreitet ich würde dir hier mal zu lassen etwa bei zwei drittel fest machen steigt die anzahl sondierungen auch sehr schnell und das hier ist genau der bereich in dem wir nicht rein wollen also cash
verfahren leben davon dass wir diesen bereich meiden dass wir die tabelle möglichst nur bis zu einem gewissen grad füllen und dennoch mehr Brauchen dann baum so neu wieder auf dann macht man diese operation das gilt für offene adressierung wie auch für das supply chain wenn man noch mal zusammenfassen dann schaffen wir mit hash tabellen das grundstück suchen einfügen und löschen in eine hash tabelle in konstanter zeit durchführen zu können zumindest dürfen erwarten dass wir das ein konstanter zeit schaffen wenn wir mal kurz die möglichkeit von den Erzwungenen recession ausblenden abhängig ist das ganze vom füllgrad
alpha wenn der füllgrad zu hoch ist dann wird der aufwand plötzlich dramatisch schlechter dann habe ich tatsächlich linearen aufwand für die offene adressierung ähnlich für das supply chain wo ich weiß im mittel wird sich der aufwand um einen faktor 1 durch m verringern aber eben nur um den faktor verringern der schlüssel dass das ganze Funktioniert ist einmal eine gute hash funktion die möglichst gleich verteilte hash wert erzeugt und zum zweiten die tatsache dass dieser staat alpha klein genug bleibt wir machen die tabelle nie voll sondern halten uns an so eine daumenregel wie polka darf nicht
höher als zwei drittel seien keine frage wir verschwenden dabei ein bisschen speichern tatsächlich ist es aber gar nicht so viel und gleichzeitig dürfe nicht Vergessen es ist immer noch eine sehr einfache datenstruktur wir müssen eigentlich nur hash funktionen auswerten index arithmetik machen vielleicht einfach verkettete liste was einfügen oder dort was suchen oder was löschen es ist kein vergleich mit den algorithmen die wir brauchen um in den zug baum zu arbeiten für offene adressierung wie lineare sondierung oder doppel herrschen brauchen wir zwingend neuaufbau der Größeren tabelle zwingen die hessen wählen die tabelle zu groß wird und
gleichzeitig haben eine sonderbehandlung beim löschen löschen jetzt immer sonderfall hier ich empfehle euch deshalb diese offene adressierung nach möglichkeit nicht zu verwenden oder nur wenn es wirklich einen guten grund gibt in der regel ist es so lohnen tut sich das wie gesagt wenn ich meine tabelle einmal aufbau und dann fiel in immer den gleichen daten Suche habe die tabelle nicht mehr ändern die methode der wahl wenn ihr hash tabellen zu suchen verwendet ist die verkettung den überläufer da kann man nicht so viel falsch machen zumindest in dem sinn dass nichts kaputt gehen kann wenn die
anzahl einträge in meiner tabelle zu hoch hat dann zahle ich für meine suchen entsprechend mehr ich habe nicht mehr wirklich den vorteil der hash tabelle aber ich mache nichts kaputt die tabelle wird nie voll weil ich in die Verketteten listen immer noch einfügen kann besser ist es machen wie herrsching aber es steht mir völlig frei zu welchem zeitpunkt ich das mache gleichzeitig bleibt die verkettung der überläufer immer noch die wahrscheinlich einfachere implementierung lineare sondieren ist zwar auch relativ einfach implementiert zumindest wenn man das löschen mal raus nimmt aber die für die algorithmen für die verkettung
sind tatsächlich auch Super simpel und ich kann wenig falsch machen dabei denkt dran das wie hessen tatsächlich zu nutzen damit der füllgrad alpha tatsächlich auch klein genug bleibt also viele implementierungen von hess tabellen um zum beispiel einen datentyp set menge darzustellen haben als einen parameter tatsächlich den maximalen füllgrad und stoßen automatisch ein wie hessing an wenn dieser füllgrad zu hoch hat Wir können eine heß tabelle verwenden um den abstrakten datentyp set und abstrakte datentypen web zu implementieren allerdings kann man das natürlich auch machen in denen wir träumen verwenden also die frage ist wann verwenden den
such baum und wann verwenden die hash tabelle ohne dass ich nochmal alles aufschlüsse für den zug baum wissen wir dass einfügen löschen suchen in logarithmische zeit möglich ist wenn man Den suchraum balancieren zb in rot-schwarz baum verwenden für die hash tabelle wenn man das spiel erschien grad außen vor lassen wenn man alles richtig machen eine gute hash funktion haben der füllgrad klein genug ist dann könne erwarten dass wir suchen einfügen und löschen in konstante zeit schaffen also wenn man so will hat die hash tabelle hier scheinbar die nase vorn vorsicht beim such baum haben eine
garantie bei der hash tabelle haben wir Immer noch eine geringe wahrscheinlichkeit dass wir linearen aufwand haben im schlechtesten fall es gibt den schlechtesten fall aber er ist sehr unwahrscheinlich wie gesagt immer die einschränkung wir haben alles richtig gemacht wir haben eine gute funktion völker das nicht zu hoch der in der praxis wichtigere unterschied ist dass wir für den such bau die daten immer sortierten reihenfolge vorliegen Haben dass wir in der hash tabelle die daten aber in keiner kanonischen reihenfolge liegen haben beziehungsweise dass die reihenfolge undefinierte die daten in dem such baum kann ich sortiert auslesen
die daten in der hesta bälle wenn ich die auslese also wenn ich mir eine niete rate über eine heß tabelle macht dann ist die reihenfolge in der diese daten in der die einträge auftreten und definiert ich kann darüber keine annahmen machen Das heißt wenn es mir wichtig ist dass sich die daten auf sortiert ausgeben möchte oder wenn es mir wichtig ist dass ich bereich suchen machen kann was ich suche nicht ein bestimmtes datum sondern ich so alle von bis also ich suche nach namen die mit buchstaben zwischen a und f beginnen dann verwende ich den
suchraum solche anfragen kriege ich mit einem hash tabelle nicht hin wenn ich tatsächlich immer nach bestimmten schlüssel suche dann kann ich sucht oder Hash tabelle verwenden sagt die herrscher werden kann effizienter seien oft ist es auch ist deswegen oft das mittel der wahl wenn ich keine sortierung braucht und sie ist in gewisser weise auch die einfachere datenstruktur muss deutlich weniger implementieren für eine heß tabelle als von sucht deswegen es ist nicht unwahrscheinlich dass er beherrscht habe er auch mal selber implementieren müssen allerdings muss ich immer aufpassen dass Ich nichts falsch macht insbesondere dass ich eine
vernünftige funktionen das wiederum könne mit dem demo herrscht able example auch wieder visualisieren ich habe schon ein paar mal erwähnt schaut euch das demo an ihr könnt auf die art und weise mit verschiedenen hash funktionen experimentieren ihr könnt verschiedene kollision behandlungen euch anschauen ihr könnt für das separat training euch Die anzahl der kollisionen fabulieren lassen und dementsprechend auch noch mal schauen wie gut die bestimmte hash funktion streut und wie sich die hemmschwelle über die zeit verhält