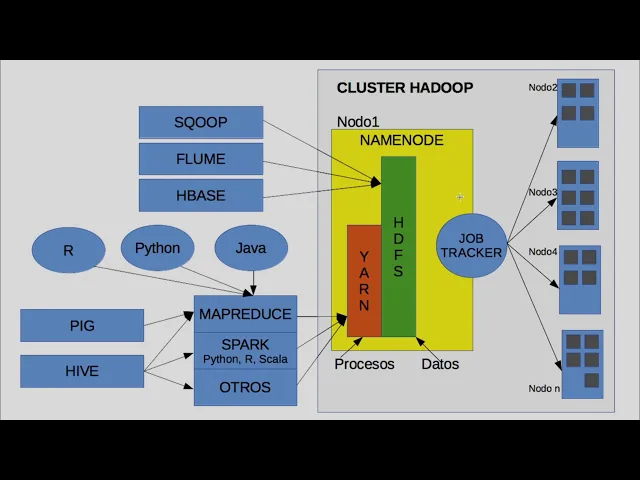
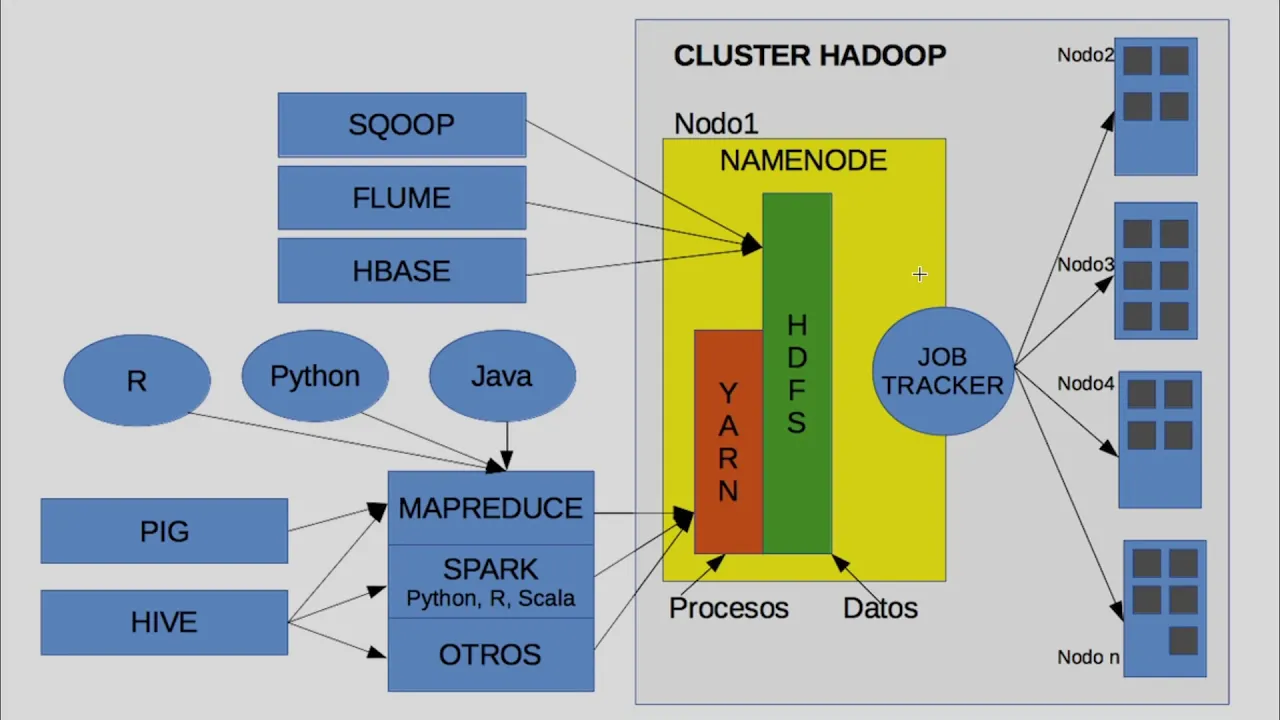
en esta serie de vídeos vamos a revisar la instalación de hadoop pero a diferencia de lo que estamos viendo en la imagen donde tengo múltiples nodos y que realmente así es como funciona un entorno distribuido con el propósito de procesar grandes cantidades de datos donde aquí en este nodo envía información a múltiples nodos y a su vez de esta información nuestros datos se puede segmentar en bloques aprovechando de esta manera el procesamiento de esta máquina bueno todos los recursos hardware está esta otra y esta otra y todas en conjunto es lo que justamente forman un
clúster pero bueno para este taller lo que vamos a realizar es solamente la instalación de lo que está en este recuadro en amarillo a través de una máquina virtual en linux con versión cientos su versión 7 y vamos a simular como si tuviéramos varios nodos de hecho solamente vamos a hacer la réplica en uno solo que de hecho va a estar en esta misma máquina virtual con linux 107 entonces ese es el propósito de esta serie de vídeos hacer la instalación de esta máquina para poder montar hadoop simular un ambiente distribuido con un solo nodo
y posteriormente darle foco o atención al sistema de archivos de hadoop que se le conoce como h de fs conocer los comandos principales cómo se manejan los archivos cómo se suben a este sistema de archivos cómo se crean y bueno en términos generales su familiarizarnos con este entorno posteriormente conocer toda su arquitectura de procesos como por ejemplo yarn que es el que recibe de herramientas fuera de hadoop como lo es este espacio scoop y algunas otras tecnologías o lenguajes de programación como r que se utiliza mucho para cuestiones estadísticas python para cuestiones científicas y ciencias
de datos java que ejecuta o puede ejecutar más bien procesos map reviews y algunas otras tecnologías que se están utilizando mucho en estos tiempos con como spark entonces todas estas tecnologías o herramientas se valen o hacen uso de estos clusters donde aquí en todo este ambiente es donde se manipulan los datos se procesa lo que yo esté enviando de este lado de este lado digamos que yo puedo tener pues incluso algoritmos de machine learning de inteligencia artificial de minería de datos pero cuando son grandes volúmenes de datos que estos grandes volúmenes como lo habíamos mencionado
anteriormente pueden ser gigas terabytes petabytes o algo que justifique el mover grandes cantidades de datos para que sean procesados con todos estos nodos y entregar resultados de manera ágil y rápida así como cuando realiza una consulta por ejemplo en google que evidentemente realiza todo un escaneo o toda una serie de consultas en toda la red imagínense nada más la cantidad de servidores que puede haber en toda la nube y entregarme resultados de manera ágil en múltiples páginas bueno pues justamente eso es lo que opera hadoop valiéndose de todos estos nodos y los recursos hardware de
todas estas máquinas para entregar resultados de manera ágil y eso es lo que vamos a estar realizando en esta serie de vídeos saludos