die letzte klasse von balancierten such bäumen die wir uns im detail anschauen sind baby wir kennen schon rafael bäume 234 bäume und rot-schwarz bäume und insbesondere die binären such bäume und rot-schwarz bäume erlauben effizientes einfügen das haben uns angeschaut und auch ein effizientes löschen das harmonisierende vorlesung nicht angeschaut es bleibt allerdings ein aber und zwar dadurch dass die knoten dieser binären sucht bäume nur jeweils einen schlüssel wert halten muss ich bei jedem mal einfügen inklusive der restrukturierungen relativ viele kleine daten oder datenblöcke anfassen sowohl lesen aber vor allem auch schreiben das tut man im hauptspeicher
nicht besonders weh allerdings ist das sehr ineffizient wenn ich die bäume auf einem externen speicher zum beispiel auf der festplatte halte also auf dem speicher auf den ich nicht schnell zugreifen kann wohl jeder leser und vor allem jeder schreibzugriff für sich teuer ist insbesondere dann wenn die daten irgendwie verstreut liegen das bedeutet für binäre such bäume zum beispiel java dass ich keinerlei kontrolle hat wo die knoten im hauptspeicher liegen gleichzeitig ist es auch im hauptspeicher so dass es günstiger schneller ist daten zu lesen und zu schreiben die eng beieinander liegen oder im besten fall unmittelbar
hintereinander liegen wir kennen das schon das genau diesen fall haben wir werden uns dieser vorteil in der verketteten liste oder eben auch im baum in dem fall in binär baum verloren geht mit den bäumen wollen wir diesen vorteil wenigstens zum teil wieder herstellen wir wollen versuchen eine baumstruktur zu schaffen die relativ gut gelesen und geschrieben werden kann insbesondere auf externen speichern also meine daten mein baum liegt auf einer festplatte womit der zugriff tatsächlich richtig weh tut so einen externen speicher wie die festplatte greife ich in aller regel nicht in kleinen teilen zu also nicht lesen
ich einzelne integer zum beispiel selbst wenn ich das machen würde im hintergrund das betriebssystem oder auch die java standard bibliothek und danach wieder das betriebssystem diesen speicher immer in größeren blöcken ansprechen das heißt auch wenn ich nur einen kleinen teil davon tatsächlich lesen möchte ich werde immer den ganzen blog lesen müssen auch wenn ich nur einen kleinen teil verändern möchte schreiben möchte ich werde wiederum den ganzen blog schreiben müssen aus diesem grund bietet sich an für such bäume die auf externen speichern liegen die struktur also die knoten diesen blöcken anzupassen also die knoten in einheiten
zu verpacken die sich effizient lesen und schreiben lassen und vor allem in große einheiten zu verpacken so dass ich nicht einzelne daten einzelne schlüssel ließ sondern nach möglichkeit eine vielzahl schlüssel auf einmal und danach möglichst schnell mit diesen schlüsseln im hauptspeicher weiterarbeiten kann es geht es hier wieder vor allem um das einfügen also wir wollen daten einfügen wir schauen uns auch beim baum das löschen nicht explizit an es ist komplizierter als das einfügen tatsächlich aber nicht so kompliziert wir können uns aber auch einen trick merken wenn man ganz bequem sind löschen explizit zu implementieren und
gerade weil so großen daten mag das eine option sein dann können wir auch einträge erstmal nur als ungültig markieren das heißt beim löschen haben wir nichts nicht mehr zu tun als eine erfolgreiche suche und irgendwann wenn man zuviel einträge haben die als gelöscht markiert sind können wir den baum wieder in ordnung bringen oder wir verwenden diese als gelöscht markierte einträge immer dann wenn sich anbietet um den neuen eintrag an der stelle einzufügen das geht natürlich auch mit den anderen bäumen es bietet sich manchmal an ist aber sicher kein patentrezept für jede situation spielen jetzt bäume
eine rolle die ich tatsächlich auf externen speichern ablege da sind insbesondere anwendungen die daten persistent also dauerhaft halten zum beispiel damit arbeiten alle von euch dateisysteme also das dateisystem beschreibt wie meine dateien meine daten zum beispiel auf der festplatte gespeichert werden die verzeichnisstruktur mit deren hilfe ich in dem dateisystem navigiert die verzeichnisstruktur die mir sagt wo tatsächlich die datenblöcke einer datei liegen die ist sehr oft mit hilfe von bäumen implementiert hier brauche ich auch wieder den schnellen effizienten zugriff im logarithmische zeit aber ich kann es mir eben nicht leisten kleine knoten wie zum beispiel für
den hvl oder rot-schwarz oder auch 234 baum zu schreiben sondern ich muss mich an der block struktur der festplatte orientieren damit das ganze effizienz geht gleiches für datenbanken hier definiere ich oft indizes wenn ich auf daten in einer tabelle effizient zugreifen möchte also nicht nur sequenziell von vorne nach hinten sondern wenn ich in dieser tabelle schnell nach dem schlüssel suchen möchte dann brauche ich den index und dieser index es in aller regel auch wieder als ein balanciertes baum implementiert und oft sind das auch hier wieder bäume oder eine variante davon und die schauen wir uns
jetzt an es ist nicht ganz klar woher der name baum tatsächlich kommt ob es eine referenz an den erfinder rudolf baier ist wichtig hier ist das blb bau steht für alles bloß nicht für binär ein baum ist kein binärer baum sondern wir machen was was man von den 234 bäumen schon kennen wir wollen einen ausgeglichenen baum so dass alle kader von der wurzel zu den blättern gleich lang sind also ein baum der in seiner höhe perfekt ausbalanciertes und um das zu erreichen haben wir einen variablen verzweigung grad ähnlich wie bei den zwei drei vier bäumen
anders als bei den zwei drei vier bäumen ist dieser verzweigung grad aber jetzt explizit hoch verzweigung grad 2 3 4 hier ist noch nicht viel bei den bäumen lassen wir richtig ruhe für zwei bis geradezu gleichzeitig speichern wir die knoten in einer datenstruktur die immer gleich viele einträge zulässt also die immer maximal viele einträge reserviert das bedeutet jeder knoten ist so implementiert dass er eben genau in einen datenblock auf der festplatte passt wir sprechen von diesen daten blocken auch als sogenannte seiten pages der ausdruck kommt gleich auch noch mal und das sind eben einheiten mit
denen das betriebssystem die hardware effizient umgehen kann es werden ganze blöcke gelesen geschrieben es werden knoten immer in solchen seiten dargestellt jetzt ist es natürlich so dass diese seiten nicht vollständig belegt sein müssen im prinzip verschwenden wir hier gewissen gewisses maß an speicher oder wir reservieren den vor für zukünftige einfüge operationen ähnliche idee hat man bei den listen bei dem vector bei dem dynamisch wachsenden harry oma die anzahl der elemente immer wieder verdoppelt haben oder vor anderhalb haben exponentiell wachsen lassen geht in eine andere richtung aber die idee ist die gleiche wir lassen zu dass
ein gewisser anteil speicher erstmal ungenutzt ist in der hoffnung dass man dafür später effizienter nutzen können wir schauen uns hier bäume an die bäume gibt es in zahlreichen varianten insbesondere gibt es zb sogenannte b + bäume oder b stern bäume die unterscheiden sich in details von den bäumen wenn man die bäume verstanden dann haben wir die anderen auch verstanden einmal ist es so dass in den inneren knoten nur schlüssel gespeichert werden und alle daten die wir referenzieren wollen durch diese schlüssel in dem blatt knoten gespeichert werden ein anderes mal ist es so dass die regel
wie die knoten jetzt konkret gefüllt sind oder welchen füllgrad sie minimal haben und wie die knoten dementsprechend geteilt und wieder miteinander verschmolzen werden dass diese regeln leicht anders sind als wir es jetzt hier für die bäume versprechen wir besprechen wie gesagt anwendung zum beispiel in datenbanksystemen oder dateisystemen und tatsächlich ist es so dass ja alle bekannten daten systeme oder auch alle modernen dateisysteme das immer noch leider immer noch weit verbreitete hat dateisystem ursprünglich von dos dann von windows übernommen benutzt diese wir wollen wir zumindest wein meines wissens nicht aber alle modernen dateisysteme benutzen in irgendeiner
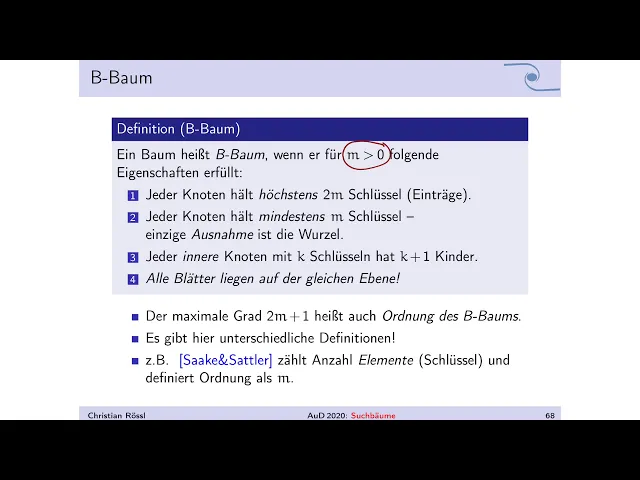
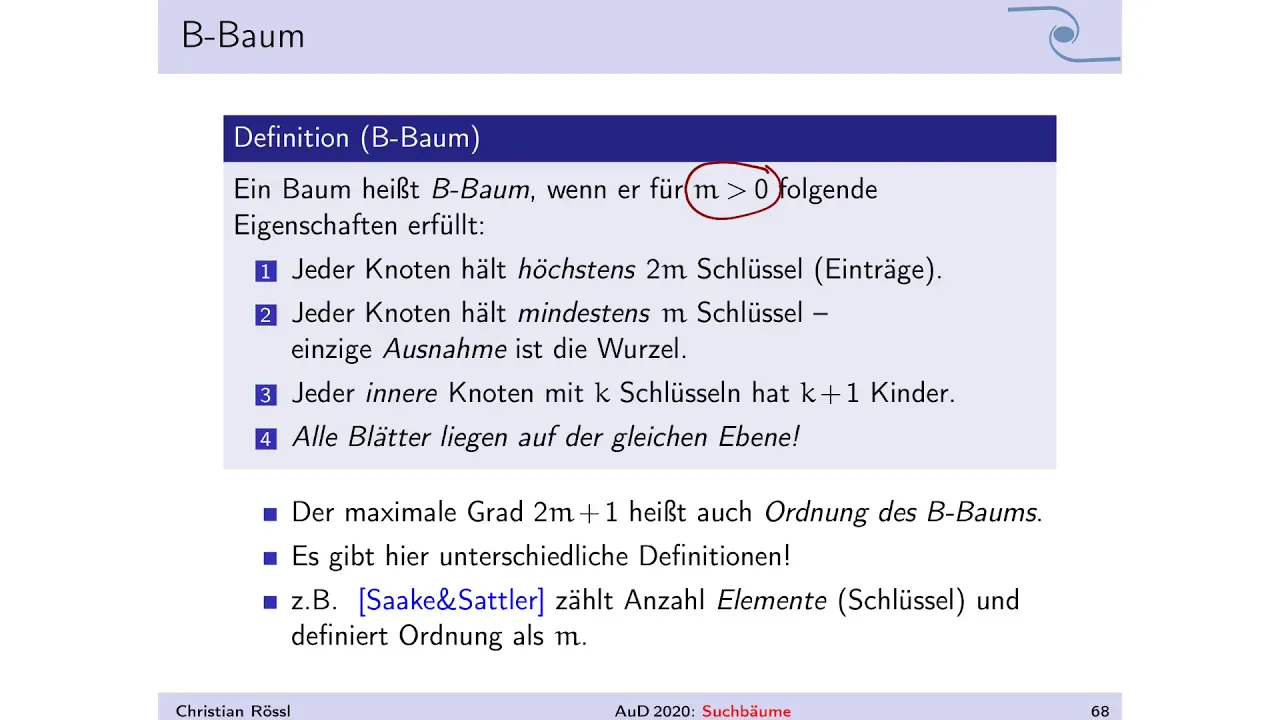
weise bäume oder varianten dafür um die verzeichnis strukturen darzustellen und auch effizient zu lesen und zu schreiben jetzt definieren die bäume ein bebauung heißt b baum wenn er für einen parameter m größe null die folgenden eigenschaften erfüllt jeder knoten hält höchstens zwei im schlüssel mit dem schlüssel und referenziert ich einträge also zwei im schluss zugleich bedeuten zwei in einträge das bedeutet auch dass der maximale verzweigung grad von einem knoten 2 m + 11 höher als die anzahl schlüssel die zweite regel jeder knoten hält mindestens mm schlüssel die ausnahme von dieser regel ist die wurzel wir
legen also einmal einen maximalen verzweigung scart fest und wir fordern außerdem dass der verzweigung grad in dem knoten mindestens zur hälfte benutzt wird dass wir also mindestens einen schlüssel in den knoten unterbringen oder mindestens einem verzweigung skat von m + 1 haben die einzige ausnahme von dieser regel ist die wurzel das ist auch klar wenn ihr im leeren baum anfang einen eintrag einen schlüssel einfügt dann kann die wurzel natürlich nicht mindestens einem schlüssel halten sondern ich muss mit weniger anfangen dritte regel jede innere knoten mit car schlüssel hat k + 1 kinder also für jeden
inneren knoten sind alle möglichen verzweigungen mit einem kind gesetzt und viertens alle blätter liegen auf der gleichen ebene diesen vierten punkt den kennen wir schon von den 234 bäumen und der baum wird tatsächlich nach einer sehr ähnlichen regel konstruiert wie die 234 bäume insbesondere wird so sein dass diese führte regel durch die konstruktion gilt die konsequenz aus dieser regel ist dass alle pfade von der wurzel bis zu den blättern gleich lang sind und dass wir damit die anzahl der knoten die wir bei einer suche besuchen müssen tradieren müssen die grenzen und für alle knoten gleichartig
begrenzen wer natürlich wieder logarithmisch begrenzen der maximale grad von einem baum heißt auch ordnung dieses baums dieser begriff ordnung wird in der literatur unterschiedlich verwendet mir gefällt diese definition besser weise ja die wenigsten fragen auf netzt oder die wenigsten mehrdeutigkeiten offen lässt aber es gibt unterschiedliche definitionen insbesondere wird im buch von sage und sattler nicht andere definition verwendet da wird die anzahl schlüssel gezählt und die ordnung als m also als dieser parameter vom baby definiert es ist deswegen eine gute idee den begriff ordnung entweder zu vermeiden oder je nachdem wo man nachliest erst mal genau
zu klären was orten beschreiben soll und auch was der parameter beschreiben soll da herrscht meistens einigkeit im buch von sagte sattler wird genau der gleiche hinweis gemacht es gibt unterschiedliche definitionen haben sie benutzten ihn genau die andere [Musik] ich bin der meinung dass das die geschicktere definition ist und auch die die öfter verwendet wird deswegen bleibe ich bei der definition aber wie gesagt wir merken uns ordnung des baums den begriff müssten im zweifelsfall erst klären ich wollen wir uns mit dem begriff auch nicht aufhalten sondern wir schauen uns an wie ein knoten in einem baum
aussieht jeder knoten im baum hält eine geordnete folge von k einträgen beziehungsweise verschlüsseln wir betrachten den beispiel das ganze synonym wenn ich den baum zeichne skizziere dann skizziere ich immer nur die schlüssel und wir können uns denken an den schlüsseln könnten noch daten dranhängen dementsprechend eintrag und schlüssel der für uns immer das gleiche diese geordnete folge von k schlüsseln das kennen wir schon aus den zwei drei vier bäumen amerika entsprechend 1 2 oder 3 und der verzweigung grad jeweils 1 das heißt wir haben hier in so einem knoten eine folge von schlüsseln insgesamt car stück
aber wir wissen auch dass wir in diesen knoten platzt haben für insgesamt 2 in viele schlüssel also bis hierher war der knoten gefüllt und alles was ich hier noch gelb schafft 4 da ist noch platz das ist noch leer so zusätzlich zu den schlüsseln speichern wir in den knoten noch die verweise auf die kinder und das sind bei vielen schlüsseln insgesamt k + 1 also hier können kind dran hängen hier hinten kind und so weiter hier ist ein kind und hier ist ein kind und jetzt habe ich nicht ganz richtig gezeichnet diesen letzten verweis den
braucht man natürlich auch noch also der knoten ist bis hierhin gefüllt der verweis c&a gehört noch mit dazu so für alle knoten außer der wurzel gilt dass der knoten wenigstens bis zur hälfte gefüllt ist das bedeutet dass wir die m schluss irgendwo hier schon erreicht haben und das k muss größer sein größer gleich sein als dem als der parameter im jahr also wenigstens die hälfte des knotens ist gefüllt ausnahme ist die wurzel die restliche speicher das was ich hier gelb hinterlegt hat was vorher auch so leicht ausgegraut war ist reserviert für einfüge operation so wenn
ich jetzt so einen knoten mir anschaue weil ich im baum zu oder weil ich was einfüge dann wird immer der komplette knoten von meinem externen speicher von der festplatte gelesen und deswegen passe ich diesen parameter m so an dass dieser knoten so groß ist dass er genau auf eine sogenannte seite oder page passt und diese seiten oder pages das in einheiten mit denen mein dateisystem meine festplatte mein betriebssystem effizient umgehen kann und die größe von diesen zeiten ist durchaus groß im vergleich zu einem einzelnen knoten im rot schwarz baum also wir reden von der größenordnung
von einem halben kilo watt aufwärts jetzt kommen wir zur suche und zu einfügen in den bb die suche würde ich nur ganz kurz beschreiben die funktioniert so wie bei 1 234 baum auch nur dass sich diesmal bis zu 2 m + 1 kinder im knoten haben kann die suche funktioniert relativ oder interaktiv in dem ich von der wurzel aus absteige also ich lese den wurzel knoten das gibt mir eine sequenz von schlüsseln in diesem schlüssel die ich jetzt in den hauptspeicher geladen haben dort mache ich eine binäre suche ob ich den eintrag den ich suche
gefunden habe wenn nein liefert mir die binäre suche die position wo ich weiter absteigen muss also in dem fall eine dieser referenzen zu einem kind knoten dorthin steige ich weiter ab und dann gehts regressiv oder interaktiv genauso weiter nach dem abstieg lese ich den knoten ein das gibt mir wieder eine folge von schlüsseln die sortiert sind ich mache eine binäre suche auf den schlüsseln und so weiter und so fort also was anders ist als beim 234 baum wo man nur einen zwei oder drei schlüssel haben jetzt haben wir viele schlüssel um 234 baum hat man
die fälle einfach sequenziell nacheinander geschrieben in baum ist es sinnvoll in den schlüsseln lieber eingelesen haben tatsächlich binär zu suchen zum einfügen einfügen bedeutet wir machen wieder genau wie m 234 baum erst mal eine erfolgreiche suche und in und damit an einem blatt knoten an diesem blatt knoten haben wir zwei fälle wir lesen diesen blatt knoten erst mal ein von der festplatte und schauen wie viele einträge stehen schon drin wenn in diesem knoten weniger als 2 m einträge oder weniger als 2 im schlüssel stehen dann habe ich da noch platz für das was ich einfügen
möchte und ich sortiere einfach in die liste der einträge ein diese liste der einträge kann ich mir vorstellen wie in haring mit weniger als 2 m einträge gelesen habe ich den knoten von dem langsamen externen speicher einsortieren tue ich im schnellen hauptspeicher also das tut mir tatsächlich nicht weh tatsächlich ist die operation immer noch als sympathisch in konstanter zeit möglich weil die anzahl einträge im baum oder umgekehrt der parameter im hier ist ja unabhängig von der anzahl einträge im bau also selbst bin ich 100 schlüssel in knoten habe und in der liste von sagt 90
noch den einen neunzigsten einfügen muss geht es relativ locker sympathisch und von 1 und tatsächlich deutlich flotter im hauptspeicher als auf der festplatte danach speichere ich den knoten wieder auf der platte ist schreiben also zurück nachdem ich den eintrag einsortiert so den zweiten fall können wir uns denken der zweite fall ist der fall das im blatt kein platz mehr ist in dem fall erzeugt einen neuen knoten tue dann erst mal so als ob ich den neuen eintrag einsortieren könnte ich krieg also mit diesen einen dazu eine liste von 2m +1 einträgen diese listet eilig in
eine linke und eine rechte hälfte die linke hälfte besteht aus m einträgen die rechte hälfte besteht aus m einträgen dann bleibt mir noch einer in der mitte übrig die linke hälfte bleibt in dem knoten also ich hab einen neuen knoten erzeugt ich habe den alten immer noch da macht den alten quasi zur hälfte leer linke hälfte bleibt rechte hälfte geht in den neuen knoten und der einzelne eintrag der mir noch über bleibt der nach dem sortieren in der mitte steht der wird nach oben in den eltern knoten hochgezogen also im prinzip ist das wieder ein
split and merge wie man es auch von 234 baum kennen das bedeutet auch wenn ich in den eltern knoten hochziehen setzt sich das gegebenenfalls regressiv nach oben fort weil hochziehen bedeutet ich füge in den eltern knoten ein und muss dann wieder den ersten und den zweiten fall betrachten und wenn ich am eltern knoten wieder kein platz ab dann geht's eine stufe höher bis zum großeltern toten und so weiter und so fort irgendwann wird so sein dass ich an der wurzel angekommen bin wenn ich viele einträge eingefügt habe in meinen baum und ich muss die wurzel
teilen dann und nur dann wächst der baum in der höhe um 1 genau wie die 234 bäume wachsen die bäume an der wurzel und durch konstruktion ist es so vorher waren alle blätter auf einer ebene dann füge ich ein jetzt freilich gegebenenfalls die wurzel dann und nur dann wächst der ganze baum in der höhe um 1 damit muss der baum nach dem einfügen auch wieder ausgeglichen sein zumindest was die höhe betrifft oder was die pfade von der wurzel bis zu den blatt knoten betrifft die beiden fälle noch mal grafisch dargestellt also erster fall ich habe
einen knoten in dem ist noch platz hier auf der rechten seite dann füge ich meinen eintrag 1 und das kommt jetzt hier nicht so richtig zur geltung dieses einfügen bedeutet ich sortiere den 1 also nach dem sortieren kann der eintrag irgendwo anders eingefügt sein ich muss die einzige position suchen ich habe es hier ausgerechnet am ende gezeichnet tomasso als ist das vor dem einsortieren ich brauche die entsprechende einfüge position zweiter fall der knoten in denen ich einfügen möchte ist voll hier das ist unser knoten sind schon 20 einträge drinnen und jetzt möchte ich noch einen
dazu nehmen was mache ich nehme diesen einen eintrag noch mit dazu kann man vorstellen ich kopiere den knoten und das hier ist jetzt mein neuer eintrag dann sortiere ich diese einträge danach ist dieser neue eintrag vielleicht an einer anderen stelle ich habe wieder eine mär aber die neuen habe ich jetzt dort einsortiert und jetzt teile ich diesen knoten oder teile ich diese liste in zwei teile und zwar einmal im links einmal im rechts und einmal der knoten der nach dem sortieren in der mitte zu liegen kommt alles was hier link steht bleibt einfach in meinem
ursprünglichen knoten also wenn man so will ich schreibe das nach dem sortieren zurück und danach habe ich genau diese einträge hier dieser knoten hier eine andere farbe dieser knoten hier ist tatsächlich dieser knoten das hier ist der identische knoten ich leg nicht noch mal einen neuen knoten an der knoten rechts hier lehrer hier gehen lege ich tatsächlich neu an und in diesen knoten zügig die restlichen anträge ein die auf der rechten seite was mir noch übrig bleibt ist der eintrag in der mitte den ziehe ich jetzt hoch in den eltern knoten hochziehen bedeutet ich füge
wieder regressiv 1 aggressiv bedeutet ich muss bei diesem einfügen wieder den ersten oder den zweiten fall betrachten also gegebenenfalls wieder nach oben laufen im zweifelsfall bis wir die wurzel teilen müssen zum beispiel an das problem mit beispielen für bäume ist die bäume wachsen nur sehr sehr langsam und das ist relativ mühsam für größere ems mit papier und stift sich beispiele zu besorgen selbst die java beispiele werden recht schnell unübersichtlich wenn die knoten zu groß sind aber schaut euch an der stelle tatsächlich beispiele an die er mit dem beispielcode ich sage gleich noch mal was dazu
generiert mit papier und stift wird dass gegebenenfalls ein bisschen mühsam wir schauen uns zwei beispiele mit papier und stift an 1 auf der folie und 1 schreibe ich gleich noch mal aus dabei schauen uns bei bäumen mit m gleich 1 und gleich auch noch mal mit ihm gleich zwei also mit relativ niedrigen verzweigung skaten gleich eins bedeutet der maximale verzweigung skat ist zwei mal eins plus eins also drei und in diesem baum wollen wir jetzt einfügen nacheinander die zahlen 1 5267 48 dran wir fangen mit der einst an gott die einst ist ein einzelner knoten
jetzt kommt die 5 die fünf hat noch platz in diesem knoten wir fügen sie ein wir sortieren sie ein so dieser knoten hat jetzt für zwei grad 3 das heißt hier passt tatsächlich nichts mehr rein wenn wir jetzt die zwei einfügen ist der knoten zu groß das heißt wir haben jetzt drei einträge drin entstehen wo eigentlich nur zwei platz wir haben diese drei einträge aber jetzt sortiert und ziehen den mittleren eintrag jetzt hoch in dem fall gibt es keinen eltern knoten das heißt die zwei wird hochgezogen als neue würze 1 und 5 bleiben als linkes
und rechtes kind stehen so verfügen die sechs ein die sechs hat noch platz neben der 5 wir fügen die 7 1 die sieben wird auch hier in diesen knoten eingefügt wenn man sortieren steht dann 567 aber dass es wieder ein platz zu viel wir haben nur platz für zwei schluss wird das heißt wenn man die sieben einfügen dann müssen wir jetzt auch wieder nachdem er sortiert haben den mittleren eintrag die 6 nach oben ziehen und in dem fall hat die noch platz im lotto morgen unser neuer baum sieht so aus wir haben den verteidigungs grad
hier oben in der wurzel erhöht weil wir einen neuen schlüssel hochgezogen haben dementsprechend haben jetzt drei kinder und ganz rechts haben die sieben jetzt kommt die 4 die vier kriegen wir hier links von der 5 unter da passt sie auch rein jetzt kommt die acht die acht passt ihr zu sieben noch mit rein nach dem sortieren stets rechts von der 7 und jetzt kommt noch die 3 die drei muss in diesen knoten mit rein sie ist größer als die zwei kleiner als die sechs wenn man hier mit einfügen wollen sie jetzt haben wir wieder einen
schlüssel zu viel wenn man die drei einfügen haben wir als sortierte reihenfolge 345 in der mitte steht jetzt die 43 bleibt als ein einzelner knoten stehen fünf wird neuer knoten und die vier wird hochgezogen in die wurzel so jetzt haben wir das problem dass wir in der wurzel auch keinen platz mehr hatten für die 4 das heißt wir schauen uns jetzt die sortierten einträge in der wurzel ein nachdem er die vier hoch geplant nachdem er die vier hochgezogen haben da steht die vier tatsächlich auch in der mitte und wir müssen die wurzel jetzt nochmal teilen
die vier hochziehen in dem fall gibt es oberhalb keinem eltern knoten mehr das heißt jetzt teilen der wurzel wächst der baum in der höhe wieder um 1 die vier wird nach oben gezogen die zwei und die sechs bleiben als einzelne knoten übrig und das ist unser baum das ganze lief ähnlich wie im 234 baum allerdings haben wir hier im 23 baum keinen vier knoten das heißt wir haben früher teilen müssen 100 auch für die bäume eine implementierung das entsprechende beispiel heißt petri exempel und ich verwende hier die gleiche klasse kathrin die ich auch für den
234 baum benutzt habt die implementiert einen ehren knoten das ist allgemein als nötig also die hat erstmal keine obergrenze und ich mache hier die folgende vereinfachung wie beim 2 3 4 baum auch ich gehe davon aus dass ich in diesen knoten erst mal einfügen kann und macht den split erst danach in der beispiel darstellen kann man das genauso gemacht also wir hatten immer wenn hier was rot umrandet war einen knoten der so eigentlich nicht sein darf in einer ordentlichen implementierung würde man die seiten die knoten lesen in ein anderes heraus lesen wo ich genug platz
hat also um einen eintrag mehr platz hat dort sortieren und wieder zurück schreiben wenn man es mit papier und stift machen dann machen wir es uns einfach und kennzeichnen nur die knoten die so nicht sein dürfen die ich noch teilen muss als inzwischen schritt und ich habe das gleiche oder was ähnliches hier auch bei der implementierung gemacht ich lasse zu dass ein knoten unmittelbar nach dem einfügen 22 m + 1 einträge habe sortiere und zidan den mittleren eintrag hoch die methoden die die arbeit machen sind die methoden split and merge teilt die parameter oder das
argument dass sie jeweils mit kriegen ist die position an der geteilt wird beziehungsweise die hochgezogen werden soll wenn man sich jeweils die grafische darstellung der bäume anschaut die mit btx ampel erzeugt werden dann zeige ich für jeden knoten nur die einträge die tatsächlich gespeichert sind also nur die ersten einträge und alles was gerade nicht benötigt wird wird auch nicht angezeigt ich lade euch ein dieses beispiel tatsächlich auszuprobieren und viele daten einzugeben und auch mal in größeren baum zu erzeugen er kann relativ große bäume erzeugen die man immer noch sinnvoll anzeigen kann muss dann vielleicht ein
bisschen rein zoomen ich werde noch ein anderes demo später ansprechen wo man das ganze nicht interaktiv schlüssel verschlüsse macht die x einfügt sondern wo man eine menge von schlüsseln in den baum einfügt und dann ein eine svg eine pdf datei erzeugen kann und sich den ganzen baum einmal anschauen kann für die bäume ist es mühsam mit papier und stift beispiele zu machen wo tatsächlich was passiert die interessant sind werden uns gleich eins noch anschauen deswegen ja schaut euch tatsächlich das demo und die grafische ausgabe von dem demo bevor wir zum abschluss beispiel kommen überlegte uns
noch warum die bäume jetzt tatsächlich gut sind einmal wir können einfügen und suchen oder vielleicht es andersrum suchen und einfügen von locken denn die höhe unseres baums ist wieder logarithmisch in der anzahl einträge begrenzt und zwar mit dem gleichen argument wie für 234 bäume auch auch das löschen kriegerin logarithmische zeit hin wir besprechen es hier nicht ihr findet den algorithmus zum löschen in angegebenen literatur insbesondere auch im buch von günter sage einmal schön beschrieben das gilt für alle bäume die und die manns anschauen das löschen ist immer etwas mühsamer als das einfügen wir lernen aber
nicht so viel neues beim löschen dass wir das ist an der stelle einfach weg die bäume glänzen für sehr große datenbestände also daten die ich auch gar nimmer in meinem hauptspeicher speichern kann wo ich auf den externen speicher ausweichen muss und dadurch dass der verzweigung grad hoch sein kann ist die höhe selbst für viele daten immer noch relativ niedrig und genau das ist das was wir wollen weil beim suchen oder gleichbedeutend beim einlösen beim einfügen muss ich ja jeweils knoten vom externen speicher lesen und diese lese operationen die möchte ich in ihrer anzahl möglichst klein
halten das bedeutet ich möchte hohen verzweigung grad und ich möchte wenig möchte möglichst große seiten oder große knoten speichern alles hat natürlich seine vor und nachteile und ich muss diese größe irgendwie sinnvoll balancieren wenn die seite zu groß ist dann kostet mich beim einfügen das einfügen im hauptspeicher das blatt schaffen bisschen mehr das suchen geht ja jeweils in logarithmische zeit innerhalb von dem knoten wenn ich eine binäre suche verwenden kann das tut mir alles nicht so weh aber wenn ich die seiten zu groß wähle dann verständig zu viel speicher der ungenutzt ist weil er jeder
knoten nur maximal bis oder nur minimal bis zur hälfte gefüllt sein muss deswegen ich will große seiten aber nicht zu große seiten übertreiben wollen das auch nicht tatsächlich ist es so dass sich die größe der seiten richtet nach dem was ich effizient vom externen speicher ein lesen oder in den externen speicher schreiben kann typische seiten größe sind vier kilobyte nehmen das einfach mal so an und jetzt überschlag man mal dass wir in diesen vier kilobyte in dem knoten einmal schlüssel speichern die jeweils 32 gbyte groß sind und außerdem braucht nur noch die verweise auf die
kind knoten und dafür müssen wir adressen auf der festplatte speichern und das macht man mit 64 bit intel brauchen also nochmal acht byte pro verweis das heißt wir brauchen pro eintrag 32 +8 macht 40plus nochmal acht byd am ende für den letzten verweis wenn man grob überschlagen passen also in die vier kilobyte 100 einträge 40 weit mal 100 so ein bisschen weniger als vier kilo also wir haben maximal etwa 100 einträge pro seite nach unserer regel verlangen wir die seite muss wenigstens zur hälfte gefüllt sein ausnahme wie gesagt ist die wurzel also wir haben wenigstens
50 einträge pro seite die tatsächlich existieren müssen das nehmen wir an dass in unserem baum insgesamt 100 millionen einträge stehen soll jeder knoten hält wenigstens 50 einträge für jeden inneren knoten wissen wenn er k einträge hält das alle k + 1 kinder auch existieren müssen das heißt im schlechtesten fall wenn jeder knoten nur zur hälfte gefüllt haben eine höhe von dem baum der beschränkt die beschränkt ist im logarithmisch von n aber diesmal zur basis 50 warfare 2 grad wo der ur mindest verzweigung scart hohe basis hier in loga rhytmus versuchen wir das mal kurz abzuschätzen
also wir haben den logarithmisch zur basis 50 und wir wollen den berechnen für 100 millionen das sind 10 hoch 8 ich würde den yoga rhytmus jetzt gern zur basis 10 schreiben das heißt wir haben hier rhythmus zur basis 10 von 10 hoch acht wenn man die basis weg sondern das wissen wir aus dem letzten semester dann müssen teilen durch den logos von 50 zur basis 10 so was hier steht zehnerliga rhytmus von 10 hoch acht die ist natürlich 8 und der zähne logarithmisch von 50 zähler logarithmisch von 10 bis 17 grad muss von 100 ist
zwei als ist das eine zahl zwischen 1 und 2 tatsächlich wird sie näher an der zwei als an der einst sein wenn man in taschenrechnern nachrichten sondern es ungefähr 1,7 machen dass herr schätzen das und gleiches bisschen schlechter ab also näher zu eins sind mit anderhalb also ein würden welche teilen durch drei halbe und das ist natürlich kein gleich mehr sondern ein ungefähr und dann haben wir hier ungefähr 16 drittel die wir ausgeben und 16 drittel ist ein kleines bisschen größer als 5 so das war unsere erste abschätzung ohne tatsächlich zu rechnen der taschenrechner tut
sich natürlich leicht diese zahl hier zu berechnen und da kommt was raus was tatsächlich kleiner ist als fünf das bedeutet im schlechtesten fall muss ich für einen baum mit 100 millionen einträgen nur fünf seiten von der festplatte vom externen speicher lesen um zu suchen das heißt dieser hohe verzweigung grad hier sorgt dafür dass die basis in unserem logarithmisch groß ist und wir hier eben noch mal weniger zugriffe bekommen wichtig an der stelle als sympathisch sind wir immer bei locken wenn die basis hier größer wird dann bedeutet das nur dass die anzahl der zugriffe um den
konstanten faktor kleiner wird aber dem fall tut uns eben jeder zugriff richtig weh weil er von dem langsamen speicher lesen müssen also jeder zugriff bedeutet dass wir daten von der festplatte nach laden müssen und diesen aufwand wollen wir möglichst gering halten ihr findet bäume auch in der angegebenen literatur auch mit beispielhaften implementierungen ich lade euch ein euch diese implementierungen tatsächlich auch mal anzuschauen und wer will natürlich sich auch mal das löschen noch an zu lesen dass verlieren der vorlesung nicht besprochen haben das gilt für die bäume wie für die a 42 34 und rot-schwarz bäume
damit sind wir mit den bäumen fast fertig ein beispiel möchte ich noch machen diesmal für einen baum mit m gleich zwei das heißt ich habe platz für maximal 2 m also vier schlüssel und damit den maximalen für 21 grad von 5 also jeder knoten kann bis zu fünf kinder haben ich habe diesmal buchstaben in meinem baum stehen und damit mir nicht ganz so viel machen müssen habe ich schon mal einen baum skizziert in dem man nach und nach slf kac und j noch einfügen wollen fange mit es hier an also es ist größer als je
grösser als k größer als coo also müssen zu diesem knoten abspeichern beim absteigen bei home verzweigung grad wird man natürlich hier nicht sequenziell suchen sondern wir würden mit einer binären suche entscheiden wo wir weiter absteigen müssen oder dass wir den schlüssel gefunden hat so hier in diesem knoten rtu hast dass es jetzt zwischen es zwischen r und t ich habe platz für vier schlösser das heißt die schmuggel dass es jetzt hier einfach dazwischen so jetzt kommt das gleiche spiel wir suchen wieder dass es zwischen dem chor und dem coo also muss ich hier ab speicher
absteigen entschuldigung und die reihenfolge ist ln und so weiter das heißt dass lw nicht einsortieren steht hier als erster eintrag in diesem kurs jetzt kommt als nächstes das m das muss auch in diesen knoten rein allerdings ist da kein platz mehr war da stehen schon vier schlüssel das würde hier zwischen dem m und den uhr stehen so was machen wir jetzt diesen knoten müssen wir teilen und das was in der mitte steht in dem fall ist dass das hochziehen wenn wir das n hochziehen hat das eng hier im wurzel knoten platzt diesen knoten hier das
mitteilen und hier ist noch ein platz frei geworden für ein kind und wir haben das in eingefügt machen wir weiter jetzt kommt das fsf muss hier in diesen knoten rein wenn ich's einsortieren ist es platz wenn ich's einsortiert steht dass es hier jetzt kommt das k so das stimmt nicht ganz das k steht hier schon hier haben hier verschrieben wir wollen ein h einfügen also jeder schlosser es höchstens einmal im baum das kommt davon wenn man so kritzer dass jetzt ein k das hier ist ein haar so und das haar ist klar muss hier diesen
knoten noch mit 1 da ist einfach platz stehen drei einträge drin und wenn ich es einst dort ihr steht hier das haar als nächstes das a das ist hier noch platz und das c für das c ist im gleichen knoten noch platzt nämlich hier zwischen dem b und dem d wenn nicht einsortieren und uns bleibt jetzt noch das j einzusortieren so und jetzt sehen wir schon an der stelle besetzt kleines bisschen komplizierter denn das j was hier in diesen knoten mit rein da ist aber kein platz das heißt wir müssen den teilen so wenn wir
teilen bedeutet dass wir ziehen den mittleren knoten wieder hoch dass j würde zwischen h und demi stehen der mittlere knoten ist somit das haar das harms hochgezogen werden wenn ich das hochziehen würde das kann hier wird er das haar hier zwischen das und das k zu liegen kommen hochziehen kann ich es aber nicht ohne dass ich die wurzel aufteilen das heißt ich muss jetzt weg nach oben laufen und aufteilen so ich habe jetzt ein bisschen leichter gemacht und den teil vom baum der sich nicht in dann wird hier einfach schon mal kopiert so hier müssen
wir den knoten teilen also wir haben einmal auf und geh noch in einem knoten und wir haben das neu eingefügte j und das in einem knoten jetzt müssen wir den wurzel knoten teilen bedeutet nach dem einfügen von j es wäre hier wäre h dem amerika entschuldigung der mit noten im wurzel knoten das heißt der wird nach oben gezogen oben gibt es nichts mehr das heißt das ist die neue wurzeln das linke kind ist der knoten mit und j also die beiden hier das ja dass ich hier hoch gezogen habe und das rechte kind enthält hier
und co so jetzt haben wir hier die für zweigen zu den entsprechenden kindern und unseren baum nachdem wir zu guter letzt sj eingefügt wir sehen dem beispiel dass wir einmal mit einem baum der höhe zwei angefangen haben in dem schon relativ viele schlüssel einsortiert waren dadurch dass wir bis zu vier schlüssel pro knoten zu lassen für m gleich zwei ist der baum recht flach obwohl wir schon einiges drin hatten und ja immer weiter eingefügt so lange bis wir ein blatt teilen mussten so dass beim hochziehen die wurzel geteilt worden ist dann und nur dann erhöht
sich die höhe von dem baby um 1 der baum wächst an der wurzel auch hier ihr könnt das gleiche beispiel mit den code bei spielen die ich euch gibt einmal interaktiv visualisieren ihr müsst einfach nur die buchstaben in der entsprechenden reihenfolge eingeben sowie was hier gemacht haben ihr müsst euch überlegen wie man vorher hätte einfügen müssen damit wir den ausgangs baum erzeugen können das lasse ich als knobelaufgabe für euch versucht das was ich hier gemacht hat tatsächlich nochmal ausgehend von den baum mit dem ich angefangen hat mit papier und stift nachzuvollziehen und wenn er verstanden
habt wie das läuft dann hat er die bäume auch verstanden und damit schließen wir das kapitel der balancierten zug bäume mit den bäumen ab und werden im folgenden noch ein paar andere bäume oder sucht datenstrukturen anschauen die wir haben nicht im detail besprechen werden