herzlich willkommen zum nächsten kapitel der vorlesung nachdem er uns relativ lange mit verschiedenen balancierten such bäumen beschäftigt haben schauen wir uns jetzt eine sehr einfache datenstruktur an die sogenannten apps bei den bäumen hatten wir die daten sortiert im baum gehalten und konnte nach beliebigen einträgen suchen in vielen anwendungen ist das gar nicht nötig sondern statt dessen wollen wir aus eine menge von daten immer nur den kleinsten bzw den grünsten eintrag finden und gegebenenfalls aus der menge entnehmen das führt uns auch zu einem neuen abstrakten datentyp der sogenannten im gegensatz zur crew first in first out
kommt hier immer der eintrag als nächstes aus der priority kyu der die kleinste oder größte priorität hat wir können das ganz einfach vergleichen mit dem nun anziehen zum beispiel an der fleischtheke ich möchte mich nicht anstellen in rate schlange stattdessen ziehe ich eine nummer und dann werden die nummern der reihe nach aufgerufen die kleinste nummer zuerst oder ich erledige aufgaben nicht indem ich sie der reihe nach in der kuh ablegt sondern ich gebe ihnen noch prioritäten bestimmte aufgaben sind wichtiger als andere die möchte ich zuerst erledigen in gewisser weise verallgemeinern wir dabei die kuh bzw
den stack beziehungsweise deren prinzipien first in first out oder last in first out zu einem kleinste bzw größte priorität zuerst wir wissen natürlich schon wie wir so eine priorität implementieren könnten wir nehmen einfach einen basierten suchbar tatsächlich wollen wir aber hier nicht auf beliebige einträge zu greifen sondern immer nur den kleinsten rausnehmen und neue einträge einfügen und das wiederum könnte mit einer sehr viel einfacheren datenstruktur erreichen und das sind die sogenannten hips wir schauen uns hier in der vorlesung eine bestimmte ausprägung von gips an nämlich die sogenannten binären hieß die lassen sich darstellen als binär
bäume um diese binär bäume wiederum kann man ganz einfach in einem feld speichern das heißt wir haben sehr einfache datenstruktur und sehr einfache algorithmen warum es das einfacher wir müssen unsere daten jetzt nicht mehr sortiert halten wie in zug baum sondern uns reicht eine schwächere teil ordnung die sogenannte heep eigenschaft die wir gleich besprechen werden aus den heaps kriegt man nicht nur die politik sondern auch ein neues sortier verfahren nämlich hips ort dass wir haben uns am ende der vorlesung noch ansehen bevor es jetzt losgeht noch kurz der hinweis der begriff wird in verschiedenen zusammenhängen
unterschiedlich verwendet uns geht es hier um eine hieb datenstruktur der begriff wird auch verwendet als bezeichnung für dynamisch verwalteten speicher insbesondere in c und c++ das bitte nicht verwechseln wenn jemand davon spricht dass daten auf dem hieb legen dann meint er wahrscheinlich etwas anderes als die hip datenstruktur die wir gleich besprechen werden das ist nun ein hit wir definieren die hip datenstruktur als einen binär bau für den gilt dass jeder knoten einen wert hat der grösser oder gleich ist dem wert seines eltern knotens ausnahme ist natürlich die wurzel die hat keinen eltern knoten auf die
art und weise definieren wir einen binären min deshalb weil der wert am eltern knoten kleiner ist als der wert der kinder das bedeutet der kleinste wert in diesem binär baum muss an der wurzel stehen wenn man die relation umdreht dann bekommt man entsprechend den maxi also hier würde ich fordern dass der wert am eltern knoten größer gleich der werte an den kindern ist und dementsprechend würde der größte eintrag an der wurzel stehen es gibt verschiedene hieb datenstrukturen wir sehen uns hier die nähere hips an dementsprechend sind unsere he's been er bäume es gibt aber auch
noch andere tipps insbesondere auch solche die ich nicht als einen binär baum darstellen kann diese heep eigenschaft definiert uns eine teil ordnung also die werte am eltern knoten sind kleine gleich der werte der kind knoten allerdings dürfen die beiden kinder in beliebiger reihenfolge im baum stehen das heißt das ist egal ob links oder rechts größer ist das ist ein unterschied zum binären super wir haben auch schon gesehen das war eine operation quasi geschenkt bekommen der zugriff auf den kleinsten eintrag den bekomme in konstanter zeit wir müssen einfach nur den wert an der wurzel des baums
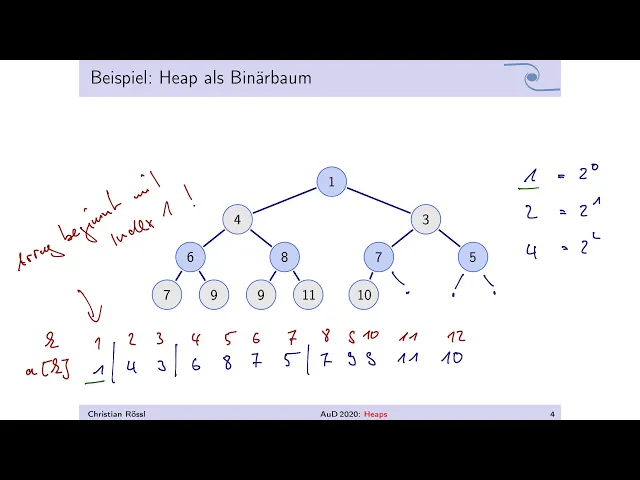
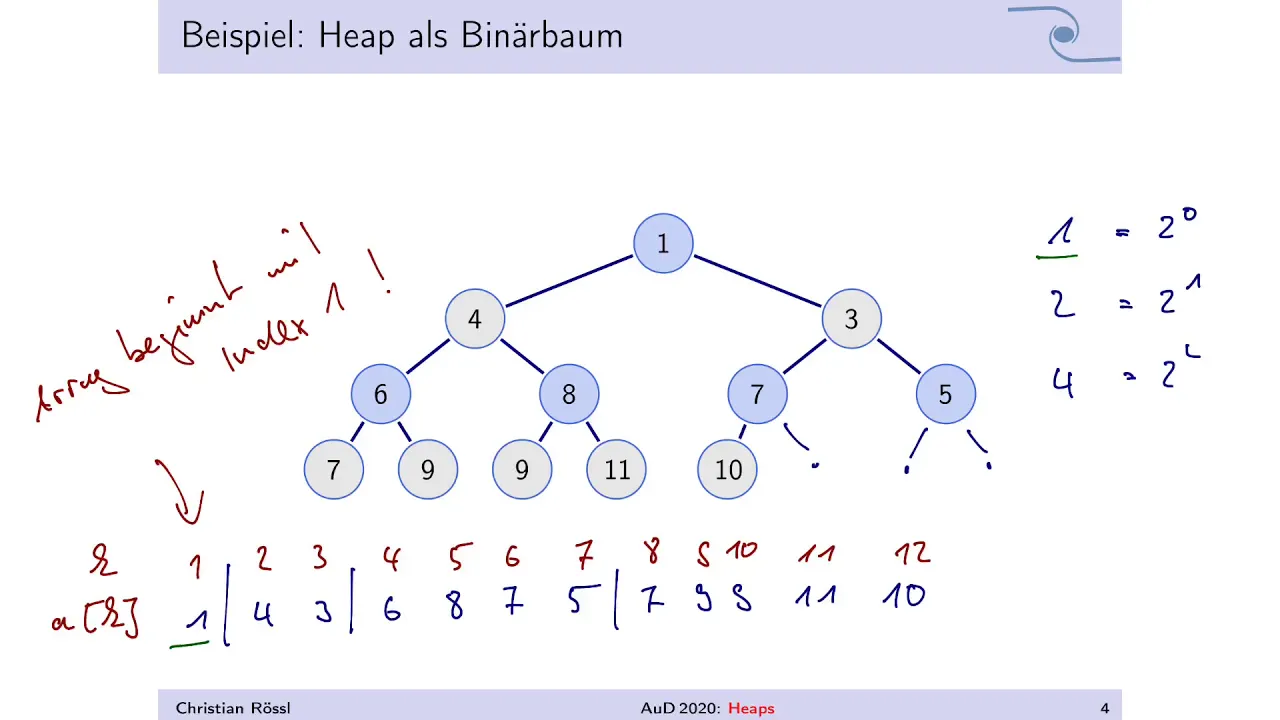
auslesen die hip eigenschaft alleine reicht uns aber noch nicht wir brauchen noch eine zusätzliche struktur eigenschaft wir können das grob mit der balance von zouk bäumen vergleichen allerdings ist es viel einfacher als dort diese struktur eigenschaft sieht wie folgt aus alle ebenen im binär baum bis auf die letzte die unterste sind vollständig gefüllt und die letzte ebene die muss zwar nicht vollständig gefüllt sein aber sie ist links bündig gefüllt wir schauen uns gleich an wie das aussieht hier ist eben ein beispiel von einem binär baum der einen hieb darstellt das heißt für jeden knoten gilt
dass der wert von diesem knoten kleiner ist als die werte an den kindern schauen uns das für die wurzel an die 1 ist kleiner als die vier und es auch kleiner als die drei schauen wir den linken teil baumann die vier ist kleiner als die sechs und ist auch kleiner als die acht geben noch mal nach links die sechs des klein als die sieben und es auch kleiner als die 9 die neuen kommt hier zweimal vor im baum für die such bäume haben wir ausgeschlossen das gleiche schlüssel mehrfach vorkommen können für die hips lasse ich
das zu das macht einfach keinen unterschied schauen wir uns die struktur von diesem baum an alle ebenen sind vollständig gefüllt bis auf die letzte ebene das heisst ich habe in der ersten oder der nullten ebene einen knoten also 20 in der zweiten ebene habe ich zwei knoten 21 dann habe ich vier knoten zwei quadrat und die letzte ebene die ist nicht vollständig gefüllt die habe ich keine acht knoten sondern nur 5 aber diese fünf minuten sind links bündig im baum das heißt die fehlenden knoten die würden hier auf der rechten seite stehen diese struktur eigenschaft
hat eine wichtige konsequenz ich kann diesen baum nehme ich jetzt sehr einfach speichern ich mache jetzt einen level oder durchlauf dieses beerbaums also zuerst die 1 dann die 4 die 3 die sechs die acht die 7 die 5 die 7 die neu die neu die elf und die ziehen die einst war auf der ersten ebene die vier und die drei auf der zweiten ebene 68 75 auf der nächsten ebene und dann kam 79 9 11 10 auf der ersten ebene ein knoten dann zwei knoten dann vier knoten und dann nur noch fünf statt acht weil
die letzte ebene nicht vollständig gefüllt war tatsächlich müssen wir diesen binär baum gar nicht so aufwendig speichern wie wir das bisher immer gemacht haben stattdessen legen wir den ganzen baum als level oder de boer so einfach in ein r das heißt hier den ersten den zweiten dritten vierten fünften sechsten siebten achten momenten den elften und zwölften eintrag also der unteren zeile in blau stehen die werte in den von den knoten in der oberen zeile haben wir den index dienen nicht k wenn unser herr heißt dann wäre das ein der wert der an der stelle kam
liegt vorsicht im unterschied zu java habe ich das mit dem index 1 begonnen also gehen hier in dieser vorlesung davon aus dass alle race nicht mit dem index 0 sondern mit dem index 1 beginnen es ist eine leichte übung das dann halt es nach java zu übersetzen wir sehen gleich dass man es ein bisschen leichter tun wenn man mit der eins beginnen also das beginnt mit index 1 weil wir wissen dass auf der ersten ebene ein knoten ist auf der nächsten ebene zwei knoten doppelt so viele wieder auf der nächsten ebene vier knoten also wieder
doppelt so viele auf der nächsten ebene wieder doppelt so viele acht wenn die ebene vollständig gefüllt wer hier sind es nur fünf weil der baum dann zu ende ist aber weil das so ist dass sich die anzahl der knoten von ebene zu ebene mit ausnahmen der letzten immer verdoppelt können wir in diesem baum die beziehung von eltern und kind ganz einfach durch indizes beschreiben wir brauchen keine datenstruktur wir brauchen keine referenzen wie wir das bisher für binäre bäume gemacht wenn ich für einen bestimmten knoten wissen möchte wer der eltern knoten ist über diesen knoten hier
die 8 steht hier im perry was muss ich dann machen ich muss einfach nur den index wo die 8 steht dass es die 5 durch zwei teilen fünf geteilt durch zwei ganzzahligen division gibt 2 und das ist der index des eltern knotens und das ist die 4 umgekehrt wenn wir vom knoten vier wissen wollen wer sind denn die beiden kinder dann schauen wir uns auch von knoten 4 wieder dass ein index an das ist die 2 und wir multiplizieren den einfach mit 2 dann bekommen wird das linke kind zweimal zwei gibt vier am index 4
steht der knoten 6 das ist das linke kind 2mal 2 plus 117 index 5 und wir haben die acht als rechtes kind wir haben das ganze nochmal zusammengefasst also wir stellen den baum in dem wir indizieren dieses harry beginnend mit 1 als anders als in java wenn man das so machen dann haben wir eine ganz einfache abbildung vom index eines knotens auf den index dass eltern knotens beziehungsweise auf die indizes der beiden kind knoten und die regel ist für einen gegebenen index k bekomme ich den index des eltern knotens indem ich eine ganzseitige division durch
zwei machen und umgekehrt ich bekomme den index des linken kindes in dem ich mit zwei multipliziere ich bekomme den index des rechten kindes in dem ich mit zwei multipliziere und noch eins drauf agiere dann das rechte kind steht im re 1 neben den linken kind schauen wir uns noch mal ein beispiel an nehmen wir diesen knoten 7 der steht hier in unserem die sieben kommt zwei mal vor wir haben hier die sieben die neben der acht im eric steht die sieben hier steht weiterhin neben der neuen so die sieben steht an index 6 wenn ich
wissen möchte was es der eltern quoten der 7 dann nehme ich die den index cex teil durch 2 das gibt mit dem index 3 und am index 3 steht tatsächlich auch der knoten mit dem wert 3 und das ist der eltern können umgekehrt wenn ich von der drei wissen möchte wer ist mein linkes kind dann würde ich mal zwei nehmen bin dann beim index 6 da steht die sieben wenn ich das rechte kind wissen möchte dann würde ich einfach zum index cex noch eins drauf addieren am index 7 da steht die 5 und ich habe
das rechte kind das funktioniert für alle knoten allerdings gibt es ausnahmen es ist klar dass die wurzel keinen eltern knoten hat dementsprechend wenn ich den index 1 durch zwei teilen würde dann bekam ich den index 0 der wäre hier ungültig indem er in wenn ich von 1 anfange zu indizieren und gleichzeitig der knoten 7 hier hat nur ein linkes kind kein rechtes kind der knoten 54 hat weder ein linkes noch ein rechtes kind wie sehen wir dass wir müssen uns zusätzlich noch die größe märkten bzw die anzahl einträge im re die zum heep gehören und
dann sehen wenn wir den index des 7 wir nehmen die sechs den wiederum mal zwei nehmen dann sind wir beim index 12 das ist der knoten mit dem wert 10 das linke kind wenn jetzt das rechte kind haben wollten hier steht nichts wird nur zwölf plus 1 rechnen und aber sehen dass wir aus unserem beziehungsweise aus dem bereich der gültigen einträge raus gelaufen sind gleiches wenn wir hier beim knoten fünf sind der knoten 5 steht hier am index 7 7 mal 2 wäre 14 und der index 14 gehört auch nicht zum bereich der gültigen indizes
also wir können von der wurzel nicht weiter nach oben und wir können keine knoten erreichen die es nicht gibt beides erkennen wird dadurch dass wir ungültige indizes einmal die null und eine zu große indizes bekommen wir können also sowohl nach oben als auch nach unten gehen eltern knoten und kinder bestimmen als auch erfragen ob es einen eltern knoten bzw 1 lech rechtes und ein linkes kind überhaupt gibt wir wollen diesen hit verwenden um eine reihe von operationen zu implementieren die erste ist ganz leicht wir wollen auf dem kleinsten eintrag zu greifen der kleinste eintrag ist
nach definition aber an der wurzel das heißt ich muss einfach nur auf den ersten eintrag in meinem bett zu greifen das geht ganz einfach in konstanter zeit ich muss im wesentlichen nur prüfen ob wenigstens ein eintrag im hip drin ist das ist eine vorbedingung ansonsten ja riesig den eintrag am index 1 aus wir wollen aber natürlich auch neue einträge in den hieb einfügen wir wollen einträge rausnehmen aber nicht beliebige sondern wir wollen immer den kleinsten eintrag rausnehmen also die wurzel aus dem binär baum entfernen wir wollen die wurzel vielleicht auch gegen den anderen eintrag gegen
den anderen wert austauschen und wir werden sehen dass wir all das verwenden können um ein neues sortier verfahren zu implementieren und das wird jetzt sein wichtig noch mal für alles was man im folgenden besprechen ist das ein hieb darstellt wir gehen davon aus dass in diesem herren einträge stehen das heißt n einträge gehören zum hit die einträge in die ziehe ich mit einem index in regel wird das k oder york sein und hier einmal anders als in java die konvention dass die indizes bei 1 beginnen das heißt die gültigen einträge in hip sind von 1
bis en jeweils einschließlich es ist nicht weiter schwer das ganze zu implementieren in java oder in programmiersprachen die wie üblich den index 0 für das erste element verwenden wir müssen dann lediglich die formeln anpassen um den eltern knoten beziehungsweise die beiden kind knoten zu bestimmen hier findet im quiz dazu was wir erhalten grad einfach und schauen uns jetzt an wie man in den hieb einfügt das funktioniert erst mal genauso wie beim binären sucht baum auch wir fügen einen blatt knoten an allerdings müssen wir hier nicht erst eine erfolglose suche machen sondern wir fangen den blatt
knoten einfach in unserem baum an der nächsten freien stelle an das heißt an der untersten ebene links bündig wenn die ebene vollständig gefüllt ist dann fangen wir eine neue ebene an das wiederum ist immer ganz einfach zu realisieren ich erhöhe einfach die anzahl der einträge im re um 1 und füge den knoten an der letzten stelle im area 1 damit habe ich erstmal die struktur eigenschaft dass sie respektiert allerdings habe ich in aller regel die haupteigenschaft verletzt denn der wert dieses neuen knotens den ich einfach ich nennen hier iks der kann er irgendwie sein und
es ist jetzt nicht gesagt dass dieser wert größer ist als alle werte die höher im baum stehen das heißt ich muss genau diese eigenschaft jetzt wieder herstellen und das mache ich mit einem ganz einfachen interaktiven am rhythmus ich beginne an dem knoten xd nich eingefügt haben und vertauscht den wert so lange mit dem wert des eltern knotens wie die hip eigenschaft nicht erfüllt ist also so lange wie der wert an eltern knoten größer ist als der wert den ich neu eingefügt habe die eigenschaft erfüllt die eigenschaft erfordert dass hier ein kleiner gleich stehen muss so
lange das nicht erfüllt ist tausche auf die art und weise wanderte eingefügte knoten so lange nach oben bis die haupteigenschaft wieder erfülltes und spätestens an der wurzel muss dieser prozess auch enten denn dann hätte ich mit iks den neuen kleinsten eintrag gibt eingefügt der maximale aufwand für diese operation ist von locken warum der binär baum ist perfekt balanciert alle ebenen sind vollständig bis auf die letzte das heißt für einen hieb mit den einträgen habe ich einen binär baum der höhe noch 2 oder 2 luca rhytmus von n schauen wir uns das einfügen jetzt am beispiel
an ich möchte in diesen heep einen neuen eintrag einfügen und zwar mit dem wert 2 was mache ich die struktur eigenschaft fordert dass dieser neue eintrag hier liegt das heißt ich mache mein oder man die einträge in dem die zum gibt gehören um 1 größer also das war dass die höhe um 1 und würde jetzt die zwei an der stelle einfach mal rein schreiben und ihr zimmer damit haben wir zwar die struktur eigenschaft erfüllt aber die eigenschaft ist nicht erfüllt denn die zwei ist kleiner als die 7 was müssen wir also machen wir müssen die
zwei und die sieben tauschen und danach wieder prüfen ob die hip eigenschaft erfülltes macht mir das danach sieht unser heep so aus ist die eigenschaft jetzt erfüllt nein ist immer noch nicht die zwei ist kleiner als die 3 aber ich möchte ja dass der eltern knoten den kleineren wert hat das heißt wir müssen jetzt auch die zwei und die drei noch mal tauschen macht man das auch noch jetzt sieht der baum so aus einmal die haupteigenschaft jetzt erfüllt schau mal von der 2 aus nach oben da ist die 1 der wert 1 ist kleiner als
2 jetzt ist alles in ordnung das heißt wir haben wir dann den gültigen hier hier sehen wir das ganze noch mal ein bisschen schöner ich habe die zwei eingefügt als neuen knoten auf der untersten ebene links bündig bzw immer einfach an neuen stelle an letzter stelle ich schaue die hip eigenschaft erfülltes nein die zwei ist kleiner als ihre eltern knoten die sieben also tausche ich die beiden es geht weiter ich prüfe ob die zwei in der neuen position kleiner ist entschuldigung größer ist als ihr eltern knoten wir sind nicht der held den boden nachdem wir
drei das heißt ich muss noch mal tauschen so ich prüfe noch mal ist der wert 2 kleiner als der wert am eltern knoten ja ist er tatsächlich der eltern knoten ist jetzt die wurzel hat den wert 1 jetzt bin ich fertig und ich habe einen gültigen hp bei eigenschaft hergestellt wenn man das ganze implementieren dann müssen wir natürlich nicht unbedingt paarweise tauschen sondern was man stattdessen machen ist ähnlich wie man es von in sessions ort kennen wir schaffen einfach die entsprechende lücke und tragen unseren neuen wert die zwei dann dort ein ich habe hier auf
der rechten seite den baum einfach mal abgezeichnet in grün sind die ursprünglichen werte die zwei habe ich eingefügt als rechtes kind von der 7 so und stadt dass ich jetzt paarweise die zwei und sieben tausch würde ich einfach den wert 7 1 weiter unten eintragen also da und die zwei ist und die 2 merke ich mir als den wert den ich neue einfüge jetzt schaue ich ob eins drüber hier am knoten der hier mit dem wert 3 ob der wert kleiner ist als die 2 nein ist er nicht ich muss noch mal tauschen und stadt
dass ich trage ich jetzt die 31 weiter und nein und ich prüfe wieder ab ausgehend von hier wenn ich die zwei hier ein schreibt die zwei jetzt kleiner ist als der eltern knoten das ist die einst an der wurzel ja ist jetzt ist alles in ordnung jetzt habe ich also den freien platz gefunden wo die zwei hin muss und da schreibe ich die 2 1 also statt da sich paarweise tauscht sich die knoten nach unten so lange bis ich die lücke habe wo ich schließlich meinen wert reinschreiben kann das war das eine implementierungs detail das
andere implementierungs detail ist ganz leicht wie komme ich denn jetzt jeweils nach oben und nach oben naja ich teil einfach immer nur den index des knotens durch 2 und mit den überlegungen können wir das einfügen in den hieb jetzt ganz einfach implementieren die funktion in satt fügt einen neuen werks im hip ein dazu vergrössern ich den hit das re um 1 trat am neuen ende dieses arrays also nachdem ich vergrößert habe den wert 1 struktur eigenschaft ist erfüllt und stellt jetzt die hip eigenschaft wieder her und das mache ich mit einer hilfsfunktion diene nicht ab
die eben jetzt diesen wert solange nach oben schiebt bisher an der richtigen stelle steht und das passiert genauso wie das gerade besprochen hat die funktion abgibt nimmt den index des eintrags der noch nicht stimmt oder der zu überprüfen ist das war hier der letzte index im harry wir merken uns was an dieser stelle steht und laufen jetzt so lange wie wir noch nicht an der wurzel sind also unser index muss echt größer als eins sein und so lange wie wir tatsächlich tauschen müssen also wie der eintrag dieser neu einfügen wollen immer noch kleiner ist als
der eintrag eine ebene höher als in der eltern position auf diese position kommen indem er den index einfach durch zwei ganz zeitig durch zwei teilen immer wenn man diese schleife einmal durchlaufen müssen also einmal tauschen einmal nach unten ziehen müssen schreiben wir an den index kam einfach den eintrag der in eltern knoten steht und haben damit eine lücke am index k geschaffen danach teilen wir den index kam durch zwei das heißt wir gehen zum eltern knoten und treibender spiel weiter wenn die schleife abbricht dann steht im index k der index für die freie stelle wo
unser antrag schließlich zu liegen kommen soll also was ich hiermit erneut swaps bezeichnet habe dass es genau die idee die wir gerade gesprochen kann dass man nicht paarweise tauscht so kann man sich gerne vorstellen sondern dass wir statt dessen die einfüge position die lücke schaffen und den wert an dort einfügen das im prinzip genauso wie der unterschied zwischen inzwischen sword und bubbles ort wir sparen einfach die hälfte der operation als nächstes wollen wir den kleinsten eintrag im hieb auch entfernen sprich aus der priorität weil man den nächsten eintrag rausnehmen oder an der fleischtheke kommt derjenige
mit der kleinsten nummer jetzt dran und schmeißt den zettel danach weg was bedeutet dass der kleinste eintrag steht an der wurzel das heißt wir müssen die wurzel löschen wir müssen natürlich auch wieder an unsere struktur eigenschaft denken deswegen sorgen wir dafür dass der baum das kompakt bleibt was wir da zu machen ist wir setzen die wurzel einfach durch den letzten eintrag im baum und der letzte damit meine ich den in der untersten ebene ganz rechts bzw im harry bedeutet das wenn man n einträge im hip hop wir ersetzen den eintrag am index 1 die wurzel
durch den eintrag am indexende die wurzel wolle löschen das heißt danach schrumpft der hieb um einen eintrag das heißt n wird um 1 erniedrigt jetzt haben wir auch wieder die struktur eigenschaft erfüllt aber die haupteigenschaft in der regel verletzt das heißt wir wollen jetzt die haupteigenschaft wiederherstellen das funktioniert genauso wie gerade eben beim einfügen allerdings diesmal nicht von unten nach oben sondern von oben nach unten ich habe jetzt einen wert an die wurzel verschoben der da wahrscheinlich nicht hingehört ich beginne also an der wurzel und prüfe ob der wert größer ist als die werte an
den kindern dazu schaue ich mir die werte der kinder an wähle das kleinere kind und schaue ob meine wurzeln jetzt größer ist als das kleinere kind wenn ja für tausch ich die bei den prozess integriert mit dem kind als neue wurzer so lange bis es nichts mehr zu vertauschen gibt das heißt der knoten den ich an die wurzel gesetzt habt wandert jetzt nach unten so lange bis die haupteigenschaft wieder erfülltes auch hier habe ich einen maximalen aufwand von oven locken da der baum perfekt balanciertes alle ebenen sind vollständig gefüllt bis auf die letzte für n
einträge habe ich sogar etwas zur basis 2 von in als höhe im baum schauen wir uns das hier an also ich möchte den kleinsten eintrag entfernen das ist die wurzel was ich dazu macht ist ich ersetze jetzt die wurzel durch den letzten eintrag im ring das ist die 7 also diese letzte guten unterste ebene ganz rechts die einzig rausgenommen und würde jetzt überprüfen ob die haupteigenschaft noch gilt tut sie nicht weil die wurzeln zwei kinder die vier und die 2 die zwei ist der kleinere wert das heißt ich schaue ob 7 tatsächlich kleiner ist als
zwei ist nicht also tausche ich die beiden hier habe ich die 2 hier habe ich jetzt die 7 ich mache das gleiche spielchen wieder der knoten hier hat zwei kinder die 3 und die 5 3 ist das kleinere kind ist die drei jetzt tatsächlich kleiner als die 79 es nicht also muss ich die beiden tauschen und nächste runde der knoten hier zwei kinder einen schuldigen hat ein kind die sieben jahren gelöscht also ein kind es noch übrig das ist die 10 ist die zehn größer als die sieben bzw die sieben kleinen als die zehn jahr
ist das heißt die eigenschaft ist erfüllt jedes mal wenn ich gerade kleine gesagt habe ist kleiner gleich auch richtig und ich habe gerade gesagt dieser knoten hat zwei kinder er hat tatsächlich nur eins denn wir haben wir hier die hurricanes um 1 erniedrigt am wie können wir das feststellen wir müssen einfach erst mal davon ausgehen dass wir zwei kinder haben und dann schauen ob beide indizes gültig sind dann so kann man feststellen einmal ob es überhaupt ein kind gibt und ob es eins oder zwei kinder gibt wenn es nur ein kind gibt dann ist es
natürlich jemand das linke weil die unterste ebene links bündig sein muss schauen wir uns auch das noch mal ein bisschen schöner an wir nehmen die 1 die wurzel raus wir ersetzen die einst durch den letzten eintragen haring also hier den knoten mit dem wert 7 und lassen die sieben jetzt nach unten wandern so lange bis die haupteigenschaft erfüllt ist wichtig es geht immer in richtung des kleineren der beiden kinder das ist hier die 2 die sieben ist größer als die zwei also müssen wir tauschen die sieben ist größer als die drei also müssen wir tauschen
die sieben ist nicht größer als die zehn also ist alles in ordnung wenn man dieses entfernen wieder als den algorithmus notieren wollen dann macht man das hier als eine funktion remove die sollen mir den wert an der wurzel zurück liefern das heißt ich merke mir erstmal was steht denn an der wurzel das werde ich am ende zurück geben dann setze ich den letzten eintrag im harry als neue wurzel und verringere die anzahl der einträge im hip um 1 und danach rufe ich eine funktion auf die jetzt die eigentliche arbeit macht down heep die die hip
eigenschaft von oben nach unten gehend wiederherstellt und zwar jetzt beginnend am index 1 und so sieht da und hieb aus ist das gleiche spiel wie gerade eben wir wollen auch wieder nicht paarweise tauschen sondern dinge hochziehen und dann die entsprechende lücke füllen der algorithmus ist ein kleines bisschen komplizierter als ab weil wir bei abp immer nur in richtung das eigenen eltern bodens laufen während wir hier nach unten in richtung der potenziell beiden kinder laufen müssen und das passiert hier in dieser schleife also gelaufen nach unten und zwar solange wir noch nicht auf der letzten ebene
angekommen sind sonst können wir nicht mehr weiter nach unten das testen wir indem wir schauen ob der aktuelle index k kleiner gleich in halbes wir erinnern uns für diese schleifen bedingungen hier nochmal für die höhe und anzahl der einträge im vollständigen bin eher für die höhe habe ich zwei hoch h -1 einträge das heißt wenn ich wissen möchte wie viele einträge habe ich bis auf die letzte ebene dann sind das zwei hochheim -1 und nochmal - 1 das heißt das ist die schleifen bedingung die prüfen muss um sicher zu gehen dass ich nicht über die
letzte ebene rauslaufen in jedem schleifen durchgang schaue ich mir jetzt das linke und das rechte kind an linkes und rechtes kind bekomme ich indem ich den index kam mal zwei nehmen das linke klinke kind muss existieren dass wir hier in der schleife unbedingt schon ab geprüft ob das rechte kind auch existiert muss ich überprüfen dazu schaue ich ob mein index vom kind echt kleiner ist als ein wenn ja darf ich auch noch um 1 erhöhen bekommen dann das rechte kind das mache ich hier j steht für den index des linken sld plus eins steht für
den index des rechten kind ich hab hier geprüft dass es das rechte kind tatsächlich auch gibt also darf diese bedingung ab prüfen wenn das linke kind größer ist als das rechte kind nämlich das rechte kind ansonsten das linke kind also in dem fall rechtes kind nehmen würde bedeuten dass ich den index tatsächlich um 1 erhöht hier schaue ich gibson recht das kind hier vergleiche ich die beiden werte und hier habe ich mich für das rechte kind entschieden und deswegen den index um 1 erhöht jetzt überprüfe ich ob mein wert an der momentanen wurzel tatsächlich kleine
gleich dem wert des kindes ist dann ist alles in ordnung dann ist die eigenschaft erfüllt dann breche ich hier einfach die schleife ab ich habe dir also einmal die schleifen bedingungen da die dafür sorgt dass ich überhaupt nach unten gehen darf und ich habe hier noch die bedingungen die die schleife dann abbricht wenn die hip eigenschaft erfüllt ist wenn diese eigenschaft nicht erfüllt ist dann ziehe ich den wert vom kind nach oben an die stelle kam und danach setzte ich den index kam auf den index des entsprechenden kindes und das ganze spiel geht in der
nächsten generation von vorne los auf die art und weise habe ich auch wieder nicht paarweise getauscht sondern nach oben gezogen so lang bis sich an der stelle kam schließlich die lücke ergibt wo ich meinen eintrag ex einfügen kann hier ist noch eine andere operation die wir jetzt ja quasi geschenkt bekommen und zwar könnte ich auch den ersten eintrag im hip ersetzen wollte also ich nehme den kleinsten eintrag aus und möchte aber gleichzeitig einen neuen eintrag einfügen dann muss ich die wurzel nicht erst durch den letzten eintrag ersetzen also erst löschen dann den neuen eintrag einfügen
sondern ich ersetze die wurzel gleich durch den neuen eintrag und würde dann das gleiche spiel mit down hipp machen es ist nicht wirklich eine wichtige operation kam aber ab und an brauchen und es in der form effizienter wie wenn ich erst löschen und dann wieder einfügen ich muss nur daun lief verwenden und nicht noch mal ab ob für das einfügen wenn wir den binären heep aufbauen können indem wir nach und nach einträge in den hieb einfügen dann können wir natürlich danach die einträge aus dem hieb entnehmen und dabei nämlich jedes mal den kleinsten eintrag oder
den kleinsten noch verbleibenden eintrag aus wenn ich das mache indem ich erst einträge einfüge danach diese einträge wieder aus dem haus löschen und dir ausgelöschten einträge danach in den harry schreibe dann habe ich unser tier algorithmus und dieser so thier algorithmus heißt hip hop im prinzip ganz einfache idee ich erstelle den hieb in dem ich immer wieder einfügen danach ließ sich alles wieder raus und hab sortiert sowie ist gerade beschrieben hat würde ich in ein anderes terrain sortieren oder rausholen dass wir autos place ich kann das ganze aber auch in place machen wir erinnern uns
im place bedeutet dass ich keinen zusätzlichen speicher brauch ich verwende nur dieses eine harry in place kann ich das machen indem ich wenn ich aus dem haus raus nehmen dann bleibt dem harry hinten freier platz übrig das heißt das was ich raus dem schreibe ich gleich an diesen freien platz weil ich hab das hier im kot einmal gemacht das bedeutet allerdings auch dass ich damit wenn ich einen mini cup also ich nehme immer das kleinste elemente aus und setzte danach ans ende des rs da wo ich gerade platz geschaffen habe durch das buch das ich
dass er damit in umgekehrter reihenfolge sortiert habe also wenn ich den mini verwende immer das kleinste rausnehmen und ans ende stellen würde das bedeuten dass ich meine daten umgekehrt sortiert habe wenn ich tatsächlich aufsteigend sortieren möchte dann muss ich den maxi verwenden und entsprechend beim einfügen und entnehmen aus dem hieb die ordnungs relation vertauscht die idee bleibt erstmal recht einfach überlegen uns kurz welchen aufwand resort hat einfügen und löschen an jeweils den aufwand von o von lok m das hat man schon überlegt weil der baum immer perfekt balanciert ist und damit die höhe lok zur
basis 2 von ändert jede schleife hier läuft einmal weil ich en einträge einfüge danach in einträge wieder rausnehmen das heißt ich habe insgesamt einen aufwand von u von in login dabei bin ich jeweils vom schlechtesten fall ausgegangen im schlechtesten fall aber auch im mittel habe ich für heaps ort aufwand von entlocken dass man sich auch noch überlegen kann ist das hips ort nicht stabil ist denn wenn ich zwei gleiche einträge in den hieb einfüge ist nicht gesagt dass ist er in genau dieser reihenfolge auch wieder aus dem heraus bekommen das heißt damit mehr stabilität beim
sortieren verletzt der hiebsatz algorithmus wir hier beschrieben ist arbeitet top down das heißt ich erstelle erst den kompletten binär baum mit in satt und nimmt dann nach und nach wieder alle elemente aus dem heraus es gibt noch eine andere möglichkeit tatsächlich eine bessere möglichkeit hiebsatz implementieren zwar wenn es eine top down variante gibt dann gibt es in aller regel auch eine bottom up variante die wollen uns auch noch ansehen bottom up bedeutet ich erzeuge den hieb von unten nach oben ich nehme das ganze eher oder den ganzen baum erst mal so wir hilfs und arbeite
mich ebenen weise durch den binär baum von unten nach oben dabei nehme ich an dass alle teil bäume unterhalb einer bestimmten ebene bereits chips sind und die idee ist jetzt dass ich jeweils eine ebene dazu nehmen indem ich immer zwei chips auf den ebenen darunter miteinander verschmelzen und dieses verschmelzen kann ich wiederum mit hilfe der funktion dauern heep übernehmen gewann gleich sehen dass man diesen bottom up diese bottom up konstruktion sehr einfach implementieren kann schauen wir uns erst an wie es funktioniert und dann sehen wir dass wir ja viele fall unterscheidungen dann die mir vielleicht
erst denkt die nötig sein könnten tatsächlich gar nicht machen muss es wird eine sehr einfache schleife unten auf ruft immer wieder von daun hieb der die eigentliche arbeit macht hier ist die idee zur bottom up konstruktion wenn man uns die unterste ebene im baum anschauen dann stehen da einzelne knoten 7614 und wir interpretieren die jetzt als teil bäume als heaps jeder einzelne knoten ist für sich ein menü auf dieser ebene gibt es erst mal nichts zu tun aber es wird gleich gelten jedes mal wenn wir auf einer ebene sind und zu sechsten gehen setzen wir
voraus dass auf der ebene auf der wir anfangen alle teil bäume hip sind für die unterste ebene gilt das trivialer weise für die nächste ebene von unten nach oben gilt das noch nicht hier muss ich jetzt jeweils zwei teams bestehend aus einzelnen knoten 7614 und hier nur die sieben miteinander verschmelzen und dieses verschmelzen übernehmen die knoten in der ebene höhe die diese beiden teil bäume miteinander verbinden diese verbindung ist im prinzip genau das gleiche wie ich ersetze die wurzel ich habe jetzt da eine wurzel die noch nicht passt das heißt ich muss jetzt dafür sorgen
dass diese knoten die die beiden teile bäume miteinander verbinden gegebenenfalls so lang nach unten wandern bis für die gesamte neue verschmolzen teil bäume die hip eigenschaft wieder gilt in diesem beispiel bedeutet das dass die neu ihren platz mit der sechs tauscht denn die neue ist größer als das kleinere der beiden kinder das ist die 6 die acht tauscht ihren platz mit der 1 und die zehnt auf dem platz jetzt sind alle teil bäume aus den unteren beiden ebenen minis wir verschmelzen jetzt wieder jeweils zwei dieser teil bäume in dem wir eine ebene höher auf der
zweiten ebene jetzt neue wurzel knoten die elf und die drei einziehen und wir spielen das gleiche spielen dieses verschmelzen von den beiden hieß durch einen gemeinsamen wurzel knoten bedeutet ich muss für diesen wurzeln knoten der in aller regel nicht passt daun heep anwenden ich musste nach unten wandern lassen in richtung des kleineren kindes so lang wie der wert zu großes also die eigenschaft nicht erfüllt ist in dem fall tauscht die elf ihren platzmitte 1 und würde danach noch mal den platz mit der vier tauschen während hier auf der rechten seite nichts mehr passiert denn die
drei ist kleiner als die fünf und die fünf es das kleinere der beiden kinder hat die elf tauscht mit der eins und tauscht noch mal mit der vier denn die vier ist das kleinere der beiden kinder so jetzt sind beide teil bäume unseres beerbaums hips und wir verschmelzen noch mal mit der gemeinsamen wurzeln das ist die 9 und spielen das spiel wieder die neuen ist größer als die 1 die 1 ist das kleinere der beiden kinder also muss man tauschen die neu ist größer als die vier g4s das kleinere der beiden kinder also wird getauscht
die neu ist größer als die 88 dass das kleinere der beiden kinder also müssen wir noch mal tauschen und das war's gehen wir noch mal kurz zurück wir haben also ein re genommen haben dieses als hieb interpretiert das ist natürlich erstmal kein heep allerdings wir nutzen die struktur eigenschaft aus das heißt wir können die ebenen trennen wir haben bei der letzten ebene begonnen und haben gesagt dass in einzelne knoten das sind für sich und jetzt immer interaktiv von ebene zu ebene gegangen und haben jeweils heaps miteinander verschmolzen indem wir auf der neuen ebene knoten als
wird so interpretiert haben und dann dauern hier aufgerufen haben einmal auf die ebene noch mal auf der nächsten ebene und schließlich nochmal auf der letzten ebene wir wollen uns jetzt noch überlegen was uns das ganze kostet wir machen das anhand von dem beispiel wir wollen einen hieb bottom up konstruieren für ein mit 31 einträgen und wir betrachten den schlechtesten fall 31 einträge bedeutet wir haben den baum der so ausschaut sich über fünf ebenen erstreckt ein knoten auf der ersten ebene dann 248 und schließlich 16 auf der letzte nebel wenn wir aus diesem baum jetzt von
31 einträgen bottom up einen hieb konstruieren wollen dann betrachten wir einmal 16 einzelne hips mit jeweils einem eintrag dass es das sind die knoten auf der untersten ebene dann acht teams mit jeweils drei einträgen das sind die hips mit den knoten auf der vorletzten ebene als wurzel haase jeweils diese hier am 8 stück ich weiß jetzt nicht alle ein dann haben wir auf der nächsten ebene 4 heep schmitt 7 einträge und schließlich auf der nächsten ebene zwei teams mit 15 einträge und am ende einen hieb das ist unser ganze baum mit insgesamt 31 einträgen im
schlechtesten fall bedeutet das dass wir so weit wie möglich vertauschen müssen das heißt auf der untersten ebene gar nicht denn jeder knoten für sich ist ein hieb da gibt es nichts zu vertauschen eine ebene höher müssen wir acht mal tauschen aber diese bäume in höhe von 1 das ist der schlechteste fall also aber da insgesamt kosten von 8 wieder eine ebene höher haben wir 4 heep schmitt 7 knoten das heißt nach höhe von 2 über die mir tauschen müssen also muss man 4 4 hieß maximal zwei mal tauschen gibt wieder kosten von 8 wieder eine
ebene drüber da haben wir noch zwei teams müssen maximal dreimal vertauschen und schließlich am ende haben wir einen hieb wir müssen maximal viermal vertauschen also die ziffer hier gibt uns immer die maximale höhe an beziehungsweise die maximale anzahl vertuschungen auf der untersten hedegaard auf der vorletzten ebene höchstens einmal um 1 nach unten eine ebene trüber höchstens zweimal und so weiter und so fort und der faktor vorher gibt uns jeweils an wie viel dieser heaps wir haben 16 liter im baum acht teil bäume gesehen von der vorletzten ebene bzw vier knoten auf der vorvorletzten ebene einen
wurzel knoten und zwei knoten eine ebene unterhalb der bosse so wenn wir jetzt rechnen dann haben wir hier 0 + 8 + 4 mal 2 gibt auch 8 + 6 + 4 gibt insgesamt 26 vertuschungen im schlechtesten fall und das thema 26 es kleiner als die 31 und 31 sind die anzahl der einträge im baum wenn man das ganze vor allgemeinen dann können wir das informel packen und sehen dass die kosten tatsächlich nur linear sind im schlechtesten fall hier am beispiel sie immer schön er sie können auf keinen fall größer als linear sein für dieses
beispiel in gleich 31 weil wir hier wird kleiner als herausgekommen und das gilt eben auch wenn ich diese rechnung die hier macht einmal allgemein beschreiben was steht hier im prinzip genau das gleiche hier die anzahl heaps auf der entsprechenden stufe und hier die maximale anzahl vertuschungen durch david die äquivalenz hier ist nicht ganz einfach zu zeigen man brauchte trick ähnlich wie für die anzahl der einträge im vollständigen binär baum für eine gegebene höhe ich mach das einem anderen video vielleicht noch an der stelle glaub das einfach dass hierfür anzahl einträgen ist gleich zwei hoch m1
also ms hier die höhe im baum zwei hoch - 1 heraus kommt - m raus kommt also etwas was insgesamt kleiner ist als 2 -1 und damit auch kleiner ist als n damit habe er den aufwand abgeschätzt auf der aufwand kann nicht höher sein als ein wenn wir uns im gegenzug top-down überlegen da ist es klar wir müssen mal einfügen für jedes einfügen müssen wir im schlechtesten fall über die ganze höhe das hips wandern also in dem fall nach oben wandern mit api und wir kommen darauf dass wir da im schlechtesten fall ein aufwand von
koffern in lockt nh tatsächlich ist es allerdings so dass der aufwand im schlechtesten fall ist im mittel müssen wir tatsächlich nicht so oft vertauschen sondern im mittel sind wir hier auch bei linearen aufwand wie gesagt das hier schauen wir uns in dem anderen video nochmal an die rechnung hier schenken wir uns an der stelle jetzt noch der algorithmus zur heaps ort mit der bottom up gib konstruktion es sind zwei schritte einmal die konstruktion von qeep und einmal das entnehmen der einträge aus dem hieb der erste schritt denn schafft man in linearer zeit den zweiten schritt
einmal remove aufrufen remove hat den aufwand von koffern locken der zweite schritt ist dementsprechend von en bloc m und damit ist natürlich heaps ort auch wovon entlocken egal ob top down oder bottom up bei top down ist allerdings der erste schritt billiger also das konstruieren eines jeeps bottom up ist billiger als das hier als das kunst als die konstruktion top down ist nicht nur billiger ist es auch sehr einfach denn der algorithmus für die bottom up konstruktion der steckt hier in dieser einem zeile ich fange an bei der vorletzten ebene den index bekomme ich indem
ich die anzahl der einträge einfach ganz zeitig durch zwei teile ich laufe so lang wie ich noch nicht ganz oben bin und verschmelzen jeweils die beiden darunter liegenden teil bäume mit down gibt ich habe gesagt bevor ihr so lange nicht ganz oben bin bis ich ganz oben bin das letzte mal verschmelzt sich an der wurzel also deswegen steht hier größer gleich so und das schöne an dem algorithmus ist ich muss eigentlich bis auf die abfrage dieser grenze gar nichts machen ich laufe einfach in meinem baum immer weiter in dem fall von rechts nach links überlegen
wir uns auch das noch mal kurz am beispiel ich fange hier in der vorletzten ebene beim letzten eintrag der noch ein kind hat an das ist hier die sieben und macht downhill dann höchste erniedrige ich den index um 1 ich gehe also von der sieben zu acht und macht downhill ich gehe von der 18 68 down heb ich gehe von der 623 also von hier nach da und macht damit von der drei zur 4 macht downhill von der 421 macht downhill alles was ich hier gemacht hat ist ich habe mich in diesem jahr von links
von rechts nach links entschuldigung bewegt und immer wieder den hit aufgerufen und das wiederum ist alles was hier in dieser zeile steht also wir müssen überhaupt nicht in ebenen denken oder dieses wechselnde ebenen irgendwie im algorithmus abbilden das funktioniert einfach von ganz alleine ich muss einfach nur bei dem index jeweils um 1 1 niedriger wenn wir die eigenschaften von hiphop noch mal zusammenfassen dann benötigt hieß ort einloggen operationen sowohl im mittel als auch im schlechtesten fall gips ort arbeitet in place aber vorsicht für den mini bekomme ich eine absteigend sortierte folge für den maxi bekomme
ich die aufsteigend sortierte folge hieß ort ist nicht stabil weil ich gleiche werte in dem hit nicht unbedingt in der richtigen reihenfolge wieder aus dem heraus bekommen vielleicht noch eine nebenbemerkung dieser algorithmus zur bottom up konstruktion von dem hieb der ist nicht nur für heaps ort nützlich sondern wann immer ich einen hieb aufbauen möchte aus bekannten einträgen die ich einem speichern kann dann würde ich das bottom up und nicht top down also nicht durch wiederholtes in satt machen und schafft das eben in den jahre zeit mit hilfe von unseren heep können wir jetzt den abstrakten
datentyp priority kyung definieren den wärme ihnen kapiteln zu graphen bzw algorithmen auf graphen wieder aufgreifen ihr verallgemeinern in gewissen sind die kuh oder den stack statt last in first out für den stack oder first in first out für die kuh geben jetzt die pyrit die prioritäten die reihenfolge vor in der einträge die datenstruktur verlassen also die priorität gibt mir eine ordnung vor java kann ich das mit hilfe von compair aber natürlich wieder parametrisieren welche operationen habe ich auf der kritik ich möchte eine lehre priorität yuan liegen können ich möchte aus einer gewissen anzahl von einträgen
die ich in einem feld gespeichert habe eine priorität konstruieren können das eigene mache ich indem ich ein leeres feld an deck das andere mache ich indem ich bottom up bekommst du hier ich möchte entscheiden können ob die priority cool er ist so einfach wie groß ist gerade für meinen hin ich möchte das erste element aus der projekte crew ansehen können also das minimum in meiner menge bestimmen ich schaue einfach auf den ersten eintrag im feld wir möchten neuen eintrag in die periode einfügen ich mache das mit insa den hieb möchte den kleinsten eintrag aus der
kritik heraus nehmen ich mache das mit remove auf den hieb und ich möchte ja bush und pop oder pop und push nacheinander ausführen ich dachte dass mit dieser operation replays hier findet eine implementierung von der priorität wie zb in java collections ebenso in der c + + standard bibliothek vorsicht die politik hier kann leider nicht ganz so viel wie die hier sondern die spd-politikerin der bürstner stadtbibliothek die verwendet tatsächlich einen binären hier aber auch nicht mehr das interessante hier ist das sich an die funktionen zur manipulation des heaps tatsächlich auch noch ran kommen also bottom
up gib erzeugen etwas in den hieb einsortieren etwas aus dem web entfernen und hips ort anwenden und selbstverständlich implementieren wir die projekte crew auch noch mal selber und haben dazu eine schnittstelle für die abstrakt im kapitel zu graphen werden wir das ganze dann auch in aktion sehen und verwenden wenn wir noch einmal zusammenfassen was kommt mit der priority kyu auf basis von dem piep machen wir können minimum oder maximum in konstanter zeit bestimmen wir können einfügen und entfernen in logarithmische zeit wir können den hieb aufbauen aus menge von einträgen bzw wir können zwei heaps zusammenführen
ihm mit einer gemeinsamen wird zu in ufernähe und wir können hiess ort implementieren ich habe ganz am anfang gesagt wenn meine priorität haben wollen dann könnten auch einfach den balancierten zug nehmen wenn wir das machen dann zimmer naja asymptomatisch ändert sich am aufwand tatsächlich nichts außer hier beim bottom up aufbau von der keeper allerdings ändert sich einiges wenn ich mir die konstante anschauen denn im balancierten such baum habe ich einfach viel mehr zu tun beim eigenen fügen und beim löschen ich muss balancieren hierbei binären heep kann nicht alles auf dem re machen alle daten stehen
nebeneinander oder kontinuierlich in emmerich kann einfach darauf zugreifen ich kann schnell darauf zugreifen ich brauche keine referenzen sondern stattdessen muss ich einfach nur ein bisschen index arithmetik machen um eltern oder kind knoten zu bestimmen das heißt alle algorithmen sind einfach viel einfacher und schneller zu implementieren wichtig symptomatisch ändert sich wie gesagt bis auf die zeile nichts deswegen auch noch mal der hinweis die betrachtung der asiatischen komplexität ist immer wichtig aber sie sollte nie das einzige kriterium sein warum wir eine und nicht eine andere datenstruktur wählen die besorgung schönes beispiel dafür dass ich im zweifel der
einfacheren datenstruktur den vorzug geben würde nicht nur weil sie vielleicht effizienter ist also um den faktor schneller sondern einfach nur weil sie einfacher ist und ich bei der implementierung von hieb weniger fehler machen kann als zum beispiel bei der implementierung von rot-schwarz baum zu guter letzt haben wir hier auch nochmal die zusammenfassung wichtig ist ihr könnt alles nachlesen in der literatur im buch von gunter sachs oder auch kurt staska in sedgwick genauso wie im kommen ihr werdet je nachdem wo er nach nächst darauf stoßen dass es noch andere tipps gibt die nicht unbedingt als ein
binär baum dargestellt werden die auch zum teil noch andere eigenschaften haben symptomatisch für die eine oder andere operation noch besser sind also auch hier die bezeichnung hier ist erstmal recht unscharf wenn man die datenstruktur bezeichnet deswegen wollen wir hier von dem binären heep sprechen und auch was ich ganz am anfang gesagt habe der begriff kann auch noch was ganz anderes nämlich eine dynamische speicherverwaltung beschreiben also lange rede kurzer sinn wir haben uns binäre heaps angeschaut haben dadurch hips ort neu sortiert algorithmus und eine effiziente implementierung von den abstrakten datentyp priority kuh bekommen es geht gegebenenfalls
noch mal schneller wenn man sich andere hip datenstrukturen ansieht