[Musique] seulement à l'école il ya venait dans cette deuxième partie du cours sur l' architecture ddsp ccx hausse et 6000 connu aussi sous le nom de 6000 donc nous avons vu dans la première partie les principes de l'architecturé you une vélocité de chez texas instruments nous avons également vu en détail l'architecturé interne d'un dsp à virgule flottante le 6 67 13 donc on a envie qu'ils disposent de plusieurs périphériques et également de d'une minute architecture mémoire et art chic c'est à dire un niveau donc il y a le niveau un ample et elle pas en
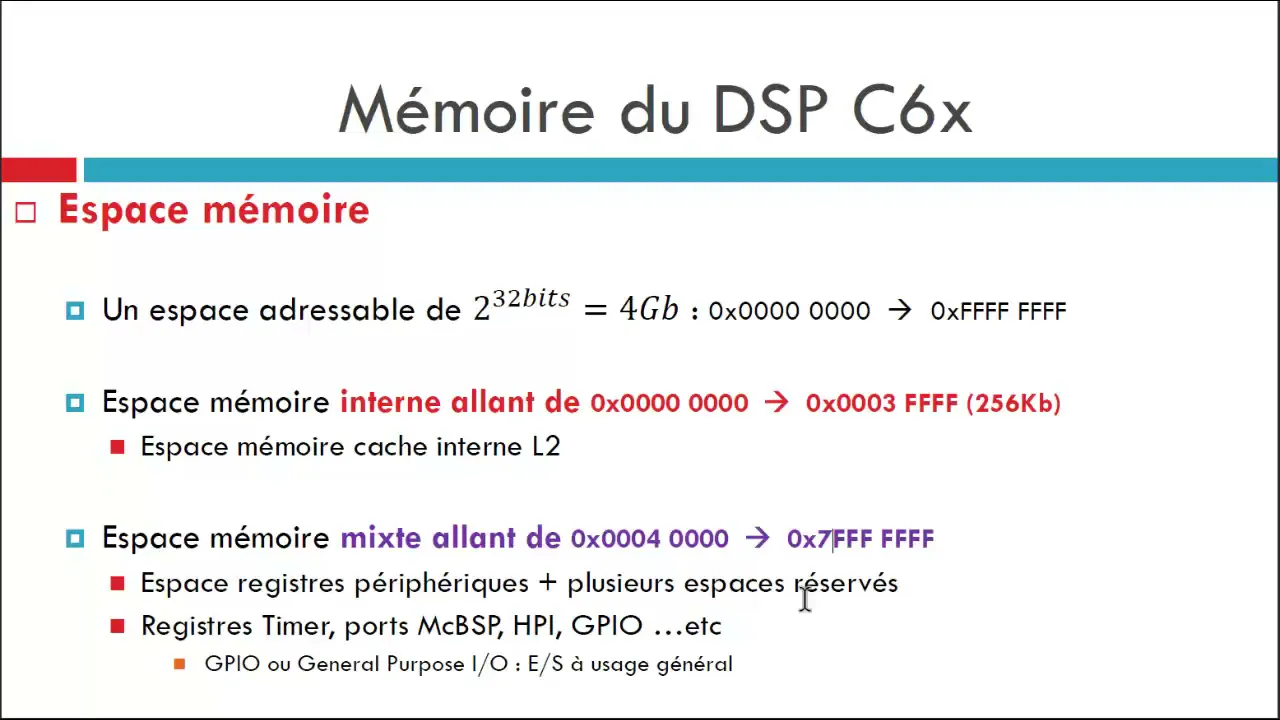
anglais la valoine le niveau 2 l2 et pour la mémoire externe qui est le niveau 3 ou 1 3 donc nous allons voir en détail cette architecture mais moi quand nous allons voir de quoi elle est composée son espace et sa taille et ses différents blocs donc cette mémoire donc elle a pardon pardon donc cette mémoire de niveau 1 donc c'est une mémoire cache donc elle utilise seulement cache donc par des voies n'est pas actif donc pour l'activer donc il faut passer par des registres de contrôle du cash donc si des registres de contrôle à
configurer au préalable pour activer le mode cash sur ces deux sections mémoire donc que nous avons la première partie de l un pays qui est mémoire de niveau un programme de mémoire cache d'une taille de 4 ko et la deuxième c'est une mémoire cache de niveau 1 qui est destiné pour le cash données d'une taille de 4 ko également pour qu'ils ont les même taille mais ils ont ils n'ont pas la même structure de gestion cache donc une aile et là ma page direct et l'autre est là elle utilise une mémoire cache associative à devoir
nous allons voir ce que c'est dans le chapitre suivant dans le chapitre et numéro trois pour l'instant se contente de cela pour le bas entre entrer dans tous les détails pour la mémoire cache de niveau 2 ou l2 donc elle est partagée entre programmes et données tant qu'elle peut être utilisée par pour les instructions donc pour les futurs des instructions et pour la l'écriture des données elle a une bataille total de 256 ko donc 64 cents exclusivement réservée pour la mémoire cache cette mémoire cache elle est elle même divisée en quatre blocs de 16 ko
alors que pour le reste soit 192 ko donc un grand bi li 6 ko de mémoire c'est une mémoire ram donc standard donc quand que vous pouvez utiliser pour la vo programme et vos données donc pour l'espace mémoire donc tout cela donc il on lui ajoute donc nous avons comme on l'a déjà vu ici donc nous avons les quatre kilos x 2 du cash et les 256 kg du niveau du niveau 2 donc le niveau 1 on a oui kg 256 au niveau 2 et au niveau 3 qui est la mémoire externe nous avons un
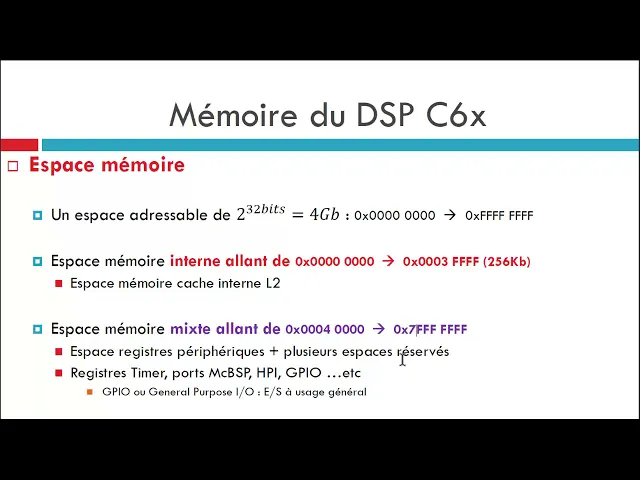
giga et pour le reste donc il est réservé pour le fonctionnement du dsp donc pour les registres maps et en mémoire les registres des périphériques les registres de contrôle donc tout cela on va le voir sous forme de cartographie mémoire donc vu que cet espace mémoire et les adressable en 32 bits nous avons déjà vu que le bus de les bus de de données tant qu'ils ont des bises l'adresse d'une taille de 32 bits donc au total on peut adresser 4 gigas de d'encre à 6,2 en hexadécimal donc on passe de 0 jusqu'à cette adresse
là donc ce qui est logique donc pour la mémoire interne donc ça sa plage donc sur sa plage elle va de la première adresse donc zéro jusqu'à cette adresse soit un total de 256 ko vous voyez que les mémoire cache de niveau 1 ne sont pas moins pions mémoire car ils sont utilisés directement par le processeur maintenant parlons de la mémoire mixte qui est-il mémoire de niveau l2 donc dans cette mémoire mx2 niveau l2 comme nous l'avons dit précédemment cette mémoire de niveau l2 peut être utilisé pour les données programme pour les instructions programme ou
pour les données programme donc lé mama p2 de 4,2 cette adresse donc lieu ici qu'on voit qu'on voit ici jusqu'à cette adresse là alors pour le reste donc ainsi les essais réservés pour les espaces registre périphériques et si timer port syrie pour parler les entrées sorties à usage général et c'est donc tout ce qui reste quand périphériques et registre son mari en mémoire nous allons voir cela donc sur sur le mappage dumas on va voir cette cartographie qui est irritée data shit de texas instruments donc nous avons au début vous voyez que cet intérêt cela
je prends le style ou voilà cette adresse là un coup début jusqu à cette adresse c'est les 192 ko de la mémoire de niveau 2 et ses 192 ko de la mémoire de niveau 2 sont des donc c'est une mémoire ram donc les noms et mémoire cache donc c'est ce bloc là il est utilisé en tant que mémoire pour le 64 restant des 256 donc c'est réservé pour le cash [Musique] vous voyez car c'est une mémoire cache mais vous pouvez l'utiliser en tant que mémoire et sera donc elle n'est pas exclusivement utilisé en tant que
mémoire cache peut être utilisé comme mémoire cache mais aussi en tant que mémoire et sera menée et comme on l'a dit déjà précédemment il on l'a répété plusieurs fois que le mode cash il n'y pas actif par défaut donc vous devez l'activer il ya des registres de contrôle cash qui peuvent gérer cela nous passons par la suite on voit que il ya une partie réservée la réserver pour fonctionnement interne du processeur dsp aussi les registres de gestion de la mémoire externe ils sont ma paye dans cette plage là ils occupent 256 ko en mémoire les
registres de gestion de la mémoire interne donc de niveau l2 si la contrôler les registres cache du que du contrôle cache l2 donc ils ont ils occupent eux aussi 128 ko cela a été là je réserve et là c'est le port les registres du port série ça c'est le port parallèle numéro zéro pour par les numéros un timer 0 et le taï marins aussi les la sélection des interruptions donc si 512 octets nous avons aussi à configurer les registres de configuration du du processeur par exemple c'est little indian s il était lyndiane au big indian
donc nous trouvons aussi les registres de diamant et le registre a été re les registres pour le contrôle des entrées sorties à usage général l'egypte et que ce sont tous des registres à mama paix en mémoire réservée pour les périphéries ça va de soi pour le reste donc pas la peine de le répéter ici pour les les ports série idc le reste des ports série les registres de la boucle de rien de verrouillage de phases pll et registre de l'humiliation diamant donc pour les données des ports série externe ce qui est important ici c'est la
partie réservée pour la mémoire externe donc là vous voyez que il y a en tout 250 méga octet x 4 donc ce qui donne un giga octets de mémoire externe possible mais on ne peut pas utiliser tous cet espace là en même temps donc vous voyez qu'il est divisé en quatre parties appelées bloc c e 0 ce1 ce2 et ce1 3 donc qu'il faut très bien se souvenir de cette partie là surtout la cette adresse là ce que c'est utile pour la gestion de votre mémoire externe donc la mauricienne commence à partir de l'adresse qu'on
voit ici et la mémoire interne commence à partir de l'adresse 0 en croit la ski ski et concernant le la cartographie de la mémoire du dsp 6 67 13 concernant les unités fonctionnelles donc chaque unité comme on l'a dit précédemment à une fonction à remplir c'est pour ça que comme les appellent les unités fonctionnelles donc les unités des deux chemins de donner 1 et 2 commençons par les unités l appelez vous je vous ai dit de vous que l c'est pour logique donc cédé ils permettent de faire des opérations arithmétiques est logique donc c'est déjà
élu au mot 2,6 ils permettent de faire des comparaisons contrainte de 48 également 10 arithmétique afrique sont rendus 48 ils permettent aussi de réaliser des opérations logiques en 32 bits en mode virgule flottante ils permettent de réaliser l'arithmétique à virgule flottante bien sûr aimé aussi la conversion d'un entier forme en simple précision ou un entier au format double précision ou la conversion dans nombre en double précision en simple précision tout cela est possible grâce à la présence d'une unité spéciale qui s'appelle fp u qui floating points unity à virgule flottante qui permet de réaliser cela
en mode virgule flottante alors que si on prend un disque fixe par exemple le 6 62 11 donc il n'est pas possible de réaliser ces conversions où cette arithmétique avec flottante à cause de l'absence de cette unité la concernant les unités est-ce donc les unités shipped sc pour chip donc les unités a dit carlos ces unités ce qu'ils permettent de réaliser des décalages sur 32 euros par an 32 48 en mode fixe envergure flottante ils permettent de calculer la valeur réciproque la valeur absolue ou la racine carrée ce qui est pas mal ils permettent également
de réaliser les branchements et les générations de constantes donc vous voyez que si vous souhaitez charge et enregistre avec une valeur constante ou réaliser un jam donc un branchement d'adressent donc un sode adresse vous devez utiliser l'unité est un os 2 rappelez-vous très bien de cela également si vous souhaitez faire un transfert entre des registres de contrôle donc lire et écrire dans un registre de contrôle il faut utiliser seulement limité s2 donc les autres élites l'unité est sain ne permet pas de réaliser des mouvements sur les juste deux contrôles et vous pouvez voir cela sur
cot cot composants encore simulation par exemple sur le tp vous vous rappelez vous le nous avons fait le l'interruption récettes d'encre en utilisant un branchement b donc un branchement utilisons limitiez fonctionnel s2 donc vous voyez que on doit utiliser une unité fonctionnelle et sans os 2 pour réaliser des branchements donc voilà ici également on a en virgule flottante on a la possibilité de faire des conversions on simple près d'eux simple précision vers la double précision ce qui avantage avec six unités là c'est que elle permet de réaliser également des opérations arithmétiques 32 bits en virgule
flottante vous avez la possibilité de réaliser des comparaisons addition soustraction au format spd paie et selon le standard et 3e 754 pour limiter m donc comme son l'indiqué donc là c'est direct vous avez des opérations de multiplication 1,6 et démultiplication 1,6 en 16 bits en 32 bits donc en utilisant le format cul et en virgule flottante vous pouvez réaliser en plus de cela donc démultiplication en formant sp et d'épée donc toujours selon le sondeur et 3 754 pour l'unité des c'est une unité mémoire donc elle permet de réaliser des accès mémoire donc la génération d'adressent
donc pour accéder à la mémoire donc on doit générer des adresses sur 32 bits cette génération d'adressés est plus effectuer de manière linéaire ou de manière circulaire donc un adressage lignières donc indirects l'ignorent ou un adressage indirects circulent elle permet également de réaliser des le dé lecture d'écriture de données mémoire avec un os est constant de 5 beats limite ils d'eux peut aller jusqu'à 15 bits donc je veux te dire par cette donc c'est pour une adresse donc on peut accéder à une adresse on ajoute aussi cette offset son modifier l'adresse origine cela permet aussi
de réaliser des opérations arithmétiques 32 bits donc vous voyez que l'unité est l'unité dé et l'unité elles peuvent tout réaliser des opérations arithmétiques 32 bits donc là si vous avez trois opérations arithmétiques à réaliser en même temps donc vous pouvez utiliser les trois unités en même temps on donne la priorité à l'unité elle ensuite limitées s est dernièrement limited et parce que des ailes est réservé pour les générations lecture et écriture mémoire donc il faut la laisser toujours la dernière pour les opérations arithmétiques en virgule flottante donc c'est c'est direct vous voyez ici que si
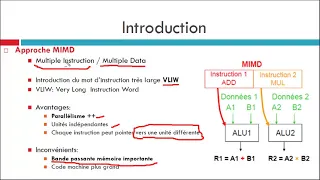
le chargement au stockage plutôt si la lecture et l'écriture de données avec un os est constant de maximum 5 beats voilà concernant les unités fonctionnelles maintenant parlons de cette spécificité aux particularités qu'on trouve sur la l'approchent ville et où donc où la proche parent mot d'instruction très large donc nous avons dit précédemment que le mot d'instruction elle est très large donc il est composé de 256 bits donc ce mot là il perd il peut contenir oui instructions de 32 bits c'est ce qu'on a dit haut débit en cui instructions de 32 bits soit au total
256 bits si on réunit toutes ces instructions là on peut les réunir ce qu'on appelle un pacte dans un papier appelés paquets effet ou en anglais fait paquet fait banquette donc ce parent mais ce paquet permet de réaliser le fait de huy instructions de 32 bits donc ça c'est un mot de 256 bits donc entre les mises et hameaux 2 256 bits quand vous vous le voyez ici dans cette illustration donc vous voyez vous avez instruction 1 2 3 etc jusqu'à l'instruction huit en tout nous avons 256 8 soit oui instructions de 32 bits et
ses instructions là donc on va leur assigner bien sûr chaque instruction ont valu à signer une unité quand vous voyez ici donc unit donc une unité fonctionnelle et les unités convient de présenter précédemment donc limitée est ce un os de d1 ou d2 l1 ou l2 au m1 et m2 sauf que il y a une limite d'utilisation de ces unités là en parallèle aux en séquentiel donc on va voir comment les utiliser de façon optimale sans tomber dans l'erreur donc si ensuite exécuté si oui instruction ils sont au total 8 6 si on veut les
utiliser en parallèle on doit les réunir en paquets appelés paquets d'exécution ep donc fpc des paquets fait ch et dans ce pack est fait on trouve des paquets d'exécution donc en tout un paquet fp peut avoir au maximum oui paquet ep en cui instruction qui s'exécute en parallèle où un seul paquet ep au minimum donc là on va utiliser toutes les instructions les 8es de l'instruction on va les utiliser en série sauf qu'il ya une règle à respecter c'est que chaque instruction dans un paquet ep doit utiliser une unité fonctionnelle différentes ce qui est logique
parce que si on veut exécuter plusieurs instructions en même temps donc en parallèle donc si une unité est assigné à un paquet ep donc on peut pas l'utiliser en même temps dans une autre instruction qui appartient au même paquet sinon ça n'aura aucun sens logique limitée elle est occupée quand je reviens à cette illustration pour bien expliquer cette partie là vous voyez là par exemple nous avons eu notre paquet ep je vais le diviser en plusieurs paquets ep donc c'est de la c3 donc là vous voyez que j'ai gelé divisé en la c1 c2 et
la c3 pardon donc nous avons la croix paquet ep donc notre paquet fait ch il est composé de trois paquets ep donc on comprend là que ce paquet fp contient des instructions qui vont s'exécuter en parallèle qui sens quelles sont ses instructions en commençant par le pack les numéros un dans ce paquet le l'instruction et 1 et l'instruction u2 vont être exécutés en parallèle donc en même temps donc si je veux que ces instructions s'exécute en parallèle je peux pas leur assigner par exemple l'instruction qui utilisent limitée s1 donc limite l'instruction numéro deux doit utiliser
s2 ou autres unités différentes unités fonctionnelles différentes mais elle ne peut pas utiliser la même unité fonctionnelle ce qui est logique parce que si exécutons même pendant qu'elle est l'unité fonctionnelle est ça l est déjà occupée par l'instruction est un donc l'instruction u2 ne peut pas se superposer à l'instruction et ans et doit utiliser une instruction unités pardon inutile fonctionnel différentes envoyons un exemple là par exemple bon c'est le même que je viens d'expliquer mais là c'est plus clair donc vous voyez que ce paquet afp il contient trois paquets d'exécution donc nous avons un paquet
fuck qui existe qui contient trois paquets d'exécution ep donc le pas qui est le paquet 2e paquet 3 et le tout nous donne un papier fait ch donc pas qu'est un pas qui est deux paquets 3 il le tout nous donne un paquet fait et dans ce package dont deux dans chaque paquet d'exécution de ce paquet fait ch nous avons le premier paquet ep il contient deux instructions de lecture mémoire ldc lahoud half donc deux donc c'est une lecture sur 16 bits en mémoire et vous voyez que c'est comme c'est une lecture ans qu on
va utiliser quelle unité réfléchissez un peu donc s'y limiter des donc l'unité fonctionnelle des et comme nous avons deux unités donc ldh la première ont valu un signe est l'unité dé 1 est limité deuxième on vole les parts dans l'instruction deuxième ne va lui enseigner des deux si on aurait fait d un des ens et on aurait tant aimé dans une erreur qui serait donc votre programme sera impossible à assembler du fait qu ils utilisent donc vous aurez une erreur dans votre programme donc qu'il faut corriger et là vous voyez que en assembleur donc donc
ça c'est l'assembleur ddsp ccx vous voyez ici que nous avons ajouté ces deux bars les deux bars ici indique que c'est un papier d'exécution donc c'est un paquet qui va être exécutée en parallèle donc ça c'est le paquet en rouge c'est notre paquet ep numéro un ça c'est le ep 1 qu'on voit ici donc le 1 ici le deuxième donc c'est la même chose vous voyez qu'il a une instruction at multiplient multiplient donc là on a une opération d'addition et deux opérations de multiplication concernant leur l'opération d'addition il n'y a pas de problème donc on
peut lui enseigner l en tant qu ils sont libres un s2 ou d1 ou d2 alors que pour multiplied en cuisine ils vont étudier il y à un risque évident qu'ils utilisent quel est il use les mêmes unités fonctionnelles donc dans ce cas là on doit faire attention à ce qu'ils n'utilisent pas il qu'ils utilisent deux unités fonctionnelles différentes et on voit que ce deuxième paquet d'exécution là donc on va lui mettre ce contenu las pour le limiter et vous voyez les deux bars toujours fonctionnent à des instructions qui s'exécute en parallèle donc ça se
veut dire que hat va s'exécuter en parallèle avec multiplier multiplier donc à d'avec multiples et multiplie va s'exécuter en parallèle avec le l'autre instruction multiplient et si le même cas pour le reste ici donc le dernier paquet ep qui contient une instruction chiffre ait donc c'est un décalage vers la droite ensuite une soustraction et ensuite un branchement ou un soda dresse donc voilà le principe tu es paquet d'exécution et des papes qui fâchent sur l' architecture dsb 6 alors comment on fait le processeur pour différencier tout cela donc il y a un un beat qui
s'appelle bébittes pp pour ses pc pour parallèle dans qui indique parallèle il permet de trouver le nombre de puits sur le sur un fps donc si ce beat il est à 1 et si le but le but de poids le plus faible donc le bit numéro zéro l'inscription suivante appartient au même pays si ce but il est à zéro donc l'inscription suivante elle appartient un âne paquet d'exécution différents donc voyons cela par cette illustration là donc si vous commandez votre cote l'a donc vous par exemple vous avez écrit votre cote vous l'avez assemblée dont cris
ce code là va être transformé donc on bits donc ses beats là en fonction de chaque instruction et ils y habitent ce pays si le bit 0 qui est réservé exclusivement à cet usage là pour indiquer si ce cette instruction appartient aux mains paquet au un paquet d'exécution différents qu'on me le voit ici prenons un exemple là nous avons l'instruction à ancien l'instruction l'instruction b voici l instruction b voyez ici que ils appartiennent au même paquet que ce paquet s'arrête là pourquoi il s'arrête là parce que là vous voyez qu'il n'ya pas les bars donc
il n'ya pas de paris xi s'est vite donc il n'ya pas de bar vous voyez que à la fin du papier nous avons trouvé que le bio et les galas le bit numéro zéro il égale à zéro alors que la illégal aa pour indiquer que l'instruction suivante elle appartient au même paquet mais la c zéro donc le paquet il s'arrête ici donc là nous avons notre premier paquet ep etc et le même cap o pour le reste alors concernant les les paquets fait et pâques et d'exécution maintenant parlons de l' architecture paille pipeline donc dans
l'ain strict dans l'architecturé 'pipeline' c'est une architecture ardeur qui va pousser le dsp donc le processeur dsp a ses limites donc en profitant au maximum de ses ressources donc cela permet d'augmenter le parallélisme au maximum ce qui nous permet de d'optimiser au maximum nos algorithmes donc il y à l'optimisation rappelons qu' il existe une architecture pipeline et une optimisation pas plaint encore commençons par l' architecture high line donc dans une architecture périple est donc ce qu'on va faire c'est que vous avez l'habitude de passe que par exemple ce que vous avez vu dans le microprocesseur
80 86 vous avez eu que il a il y a les laitages fait les tâches dispatch et laitages de plutôt lisse par les laitages futch les pages décodage et laitages exécution donc cela c'est ça le cycle d'exécution de chaque instruction dans le processeur donc c'est en existe une exécution dit séquentiel donc nous aurons besoin d'un démâtage flash 10 1 e 1 donc là si on souhaite exécuter trois instructions en cinq ans donc nous aurons besoin de combien de 3 x 3 donc chaque instruction et nécessite 3 cycle d'horloge pour être exécuté donc comme nous avons
trois instructions donc en tout nous aurons besoin d'eux neuf cycle d'horloge d'exécution vous voyez que nous avons 9,6 alors que si on utilise le principe du 'pipeline' donc le principe du buy plan c'est que c'est que lors de le décodage donc lorsqu'on atteint le décodage de la première instruction on y réalise le fait de la deuxième instruction et lorsqu'on des cordes la deuxième instruction on exécute la première et on commence le fait de la troisième instruction en parallèle donc là vous voyez que la nôtre et agile et notre pipeline il y dit complet donc là
il est complet et vous voyez que lors du troisième cycle d'horloge donc le troisième cycle d'horloge nous avons une instruction qui est en train d'être exécuté la deuxième elle est en train d'être décoder et la troisième elle est en train d'être préparé donc dans les tâches fait ch donc on tour nous aurons besoin de seulement 5 cycle d'horloge au lieu de 9,6 ce qui est un gain considérable de 4 cycle d'horloge ce qui est davantage de l' architecture 'pipeline' sauf que elle diffère d'un prêt aux processeurs un autre donc pour le pipeline du dsp 6,6
donc il comprend il comprend donc les trois principaux étage donc le fait ch le décodage et l'exécution mais chaque étage il est divisé en plusieurs phases dans ton coup de en plusieurs phases partant pour nous allons voir en détail sur pelé prochaine diapo avant d'entamer cela donc rappela que ledit esprit ccx possède une architecture 'pipeline' optimisé ou chaque étage 'pipeline' est décomposée en plusieurs sur les étages ofas ce qui permet donc d'augmenter du le parallélisme au maximum par arriver pipelife voyons cela donc en détail donc commençons par les tâches fait ch donc les tâches fetch
du dsp 6,6 il comprend quatre phases principales la première phase elle est dite phase pg pour vous souvenir de cela ce donc programme generates au programme adresses génériques donc comme son nom l'indiqué elle permet la génération de l'adresse du paquet fait le fpi qui va être exécuté donc il va générer son adresse pour aller le chercher en mémoire comme on le vend ici sanctionné dans cette phase là ensuite vient la partie ps donc la phase ps ou par programme sainte au programme à de récentes donc on envoie l'adresse du paquet est fait vers la mémoire
donc c'est cette étape-là ensuite la mémoire va chercher donc le paquet souhaitait donc le paquet afp cela donc prend du temps donc ça dépend du type de mémoire si c'est une mémoire de niveau l1 ou l2 donc une mémoire interne pour le disputant que ça prend seulement un seul cycle et suscite une mémoire externe donc ça dépend du type de mémoire donc ça prend end cycle c'est variable donc ça c'est la phase d'attentes de la fin de la lecture mémoire et une fois que le paquet la mémoire est l'élu et le paquet retrouver là c'est
la phase b r donc programme recife au programme fait ch paquet de lessive donc c'est la réception du paquet est fait au niveau du processeur de l'unité centrale très bien maintenant passons à l'autre étage donc là c'est les tâches fait ch le deuxième étage c'est le laitage décodage sept étages il est divisé en deux sous bloc aux phases donc si cette phase la première elle s'appelle des pays pour dispatch donc c'est comble son nom l'indiqué elle permet de dispatcher les instructions de chaque paquet ep je précise ep et non fp donc ils commencent par les
paquets ep parce que c'est des paquets qui vont s'exécuter en parallèle une fois qu'il a fini avec un paquet ep il passe au paquet suivante comme on l'a vu précédemment donc pour chaque paquet ep il fait le dispatch on va voir un exemple et ensuite ils effectuent le décodage donc le décodage des instructions donc ça c'est la préparation des hommes des registres source et destination donc d europe d opérante des opéras des instructions à exécuter donc avant la phase d'exécution donc voyez un exemple ici vous voyez ici on a un paquet fp composé de deux
paquets ep donc voilà notre paquet fp composé de deux paquets ep premier paquet c'est le ep 1 et le deuxième paquet e p2 donc le quand vous voyez le ep 1 il est déjà parti donc il est sorti de la phase des pays la partie dispatch donc il est ses instructions là ils sont vides l'anc lisant était déjà dispatcher vers leurs unités respectives donc là nous avons sept cette instruction l'or multiplient alf multiples life mais si tim explications 16 bits et l'autre à 6 et une multiplication 16 bits ils sont dans la phase décodage dans
qu'ils ont été dispatchés à leurs unités respectives vous voyez que comme site le même paquet ep on peut pas utiliser la même unité fonctionnelle pour la même instruction donc on utilise des mains pour la première instruction et m2 pour la deuxième instruction de multiplication mais pour le deuxième paquet les instructions sont en attente d'être dispatchés mais vous voyez ces flèches là donc c'est pour indiquer où ils vont être dispatchés donc la vouvoie yade la première addition va être dispensé vous vers l'unité elles ont hâte deuxième vers l'unité l2 le est-il w veut dire store world
donc c'est une écriture mémoire 32 bits donc il va être dispatchés vers le deun donc celui-là c'est le pardon saglier cw la deuxième vers des deux ce qui est logique on ne peut pas les assigner à d'autres unités fonctionnelles et là c'est une addition d'une constante donc c'est pour le s2 ce que cette année les unité est si c'est elle qui permettent de gérer les constantes donc voilà la dernière restriction nos notes veut dire nos opérations donc pas d'opération donc là un pas d'opération donc elle va être dispatchés aucune unité mais elle occupe quand même
un slot dont le pack est le pays numéro deux c'est un soin de prendre mille pardons donc voilà c'est concernant cette ce étage sept étages de décodage qui est composé d'une étape appelant le deux étapes de dispatch étape 2 des quads à chaud passons maintenant à l'étagé d'exécution qu'il étages le plus important dans cette cela s'efface des geeks ces phases d'exécution il est composé de plusieurs phases qui sont variables selon le type de 10 et spi dans un dsp avec flottante on trouve des phases maximum et vous voyez que ça c'est le nombre de phases
maximum il est de 10 il est maximum cela veut dire que que ce nombre il est variable donc ça peut aller jusqu'à 10 ans maximum comme ça peut prendre seulement une seule phase nous allons voir en détail sus la en virgule fixe et moi donc c'est parce que c'est moins complexe donc ça utilise moins 2 et pardon pour la survie ça glisse un peu donc et si et cesser ces phases là comment ils sont calculés s'ils sont calculées à partir d'un délai plus en tant qu ainsi le cycle d'exécution le premier cycle d'exécution et on
lui rajoute un délai il y à des instructions qui provoque un délai et ceux des lilas c'est lui qui permet d'augmenter le nombre de phases d'exécution en virgule flottante il peut aller jusqu'à 10 et 11,6 il peut aller jusqu'à six le temps d'occupation de l'unité fonctionne par une instruction il est appelé il est appelé latence donc attend cela elle peut être provoquée par exemple si une instruction de multiplication en virgule flottante elle peut occuper l'unité fonctionnelle m 1 par exemple pendant deux trois cycles alors que une multiplication 1,6 elle occupe une unité fonctionnelle 1 pendant
seulement deux cycles donc c'est c'est moi complexe qu en virgule flottante voir cela dans ce tableau n'a donc vous voyez ici en gris ou donc ccd instructions toutes ces instructions la cd instruction comme hymne aux dsp 6,6 et en bleu nuit là c'est des instructions un come in audi esprits à virgule flottante et particulièrement des aspects qu'on a qu'on étudie la cec 67,13 donc par exemple commençons par cette instruction la non elle ne provoque aucun délai d'exécution et sa latence est les deux un cycle d'horloge ce qui est logique donc ainsi qu'un seul cycle d'horloge
donc elle occupe le processeur pendant un cycle d'horloge donc le nombre de phases là il est 2 1 il y à des instructions à un cycle que c'est une instruction monocycle ils n'ont aucun des lieux également une latence pareil et occupe une surface donc en gros si toutes les instructions du dsp 6,6 lorsqu'ils sont utilisés en mode virgule fixe il occupe le ils ont ils occupent le 'pipeline' du dsp pendant une seule phase d'exécution seulement alors que pour le reste donc c'est variable donc les restes d instruction c les instructions et les plus compliquées en
général c'est une multiplication la lecture ne ment et le solde adresse et cela est justifié par le besoin de vidange du du 'pipeline' donc on doit vider le pipeline pour les soirs d'adressent on va revenir à cela d'autres parlant de la multiplication une multiplication à virgule fixa c'est une multiplication 1,6 elle a un délai de un cycle et latence de un cycle dont conduit au total nous avons deux phases d'exécution donc la première phase d'exécution ensuite elle libère limité par exemple si on a une multiplication par exemple n'en multiplie donc elle à être exécutée par
l'unité m1 par exemple il faut qu'elle ait quelqu'un c'est lé cycle d'horloge et passez donc cette unité est main elle est libre pour accueillir une autre instruction sauf que le résultat on voit pas le récupérer directement donc on doit attendre un délai de un cycle donc plus un cycle ici pour retrouver le résultat du calcul de la multiplication à don pour l'écriture donc le résultat ici donc en tout nous aurons besoin d'un dense et d'un siècle d'exécution et ainsi que deux délais donc en dessous nous avons deux phases d'exécution pour le chat jeumont c'est une
autre histoire là nous avons un délai de quatre cycles et latence d'un seul cycle alors pourquoi nous avons ce délai la ce délai est provoquée par la lecture mais moi donc la lecture mémoire prend du temps donc ça consomme 4 6 ans minimum avec une latence de un seul cycle cela veut dire que y voit que on a exécuté cette instruction là malgré qu'on n'a pas encore récupéré les résultats donc là est le résultat de lecture mais moi on peut réutiliser la même unité d en haut des deux car la latence ici lé 2 2
un seul cycle en contournant 5 604 +15 cycle peter cinq phases d'exécution pour le branchement où le solde adresse donc le jump donc là nous avons un délai de cinq cycles plus une latence de un seul cycle les branchements rappelez-vous nous avons dit que ils peuvent être exécutés seulement par l'unité fonctionnelle au s2 donc si on souhaite faire dissuade adresse donc des branchements on doit utiliser le drs 2 donc limité à un all in i ts 2 si elle exécute une instruction b la embranchements donc pendant le premier cycle la limiter elle est occupée et
et voici que le passé donc lors du deuxième cycle l'unité elle est libre d'utilisation d'encore peut l'utiliser par un autre instruction b ou autre sauf que le branchement donc le soda dresse il ne va pas s'exécuter donc on va pas faire un saut d'adressent jusqu'à l'écoulement de cinq cycles supplémentaire donc en tout il faut six phases d'exécution donc si c'est qu'il faut attendre six cycles pour voir un branchement s'exécuter là c'est c'est le commun des instructions ccx de la famille 6000 si on lui rajoute pour le côté des instructions à l'automne donc si on souhaite
par exemple prenons cette multiplication là en rouge là c'est une multiplication des pédants qu'en double précision elle est possible seulement sur les dsp à virgule flottante elle provoque une latence de quatre cycles et un délai de neuf cycle cela veut dire que l occupent l'unité fonctionnelle m pendant quatre cycles donc on ne peut pas utiliser cette unité m pendant quatre cycles elle est réservée pour l'instruction la première section qui l'a prise et on doit attendre nef délais donc neuf cycle de délai pour voir un résultat arriver donc en dessous nous aura besoin de dix phases
d'exécution donc le 9 plus le 1 donc ça donne dc dc culture ou d'exécution et attention ici donc on compte la latence dans qu un seul cycle parce que là c'est la latence donc c'est pas une addition des deux des 2des des deux cycles ici là on effectue l'addition parce que la latence elle est de 1 mais lorsqu'elle est différente de 1 donc là on doit prendre en compte un seul cycle d'exécution a ajouté pour le cycle de délai rappelez-vous ici l'avant précisé que le nombre de phases il est égal au nombre de cycles des
délais plus en donc soit ça donne ici le neuf plus ça donc ça donne 10 on compte pas les diktats c'est que qu'on voit ici sur cette colonne pardon donc on fini maintenant pour par un exemple du 'pipeline' avec ce qu'on vient de voir donc avec toutes ces phases là on va essayer de voir ce que ça donne voyez là que nous avons un exemple dans paquet fp qui contient un seul paquet d'exécution donc un seul paquet vous voyez ici que la phase pg ps puis wpr ça c'est les tâches fait ch ensuite les tâches
décodage il est composé de dix pages et des codes ensuite vient le laitage d'exécution des tâches d'exécution donc comme si la citerne cet indice perd 1,6 donc vers fixes donc nous avons six au maximum six phases d'exécution maximum qui sont provoquées dans le para embranchements et là vous voyez que le 'pipeline' il est réalisé en parallèle donc là lorsque la première instruction elle est dans l'étape de d'envoi de la drees vert pour la lecture en mémoire la deuxième instruction elle est en train de générer son adresse est là lorsque la première instruction est en train
d'attendre la lecture mémoire la deuxième elle envoie son adresse verve la mémoire et la troisième elle commence à générer son adresse etc jusqu'à avoir ce qu'on appelle l'effet prime aux cycles numéro 7 là on ixic numéro 7 nous avons cette instruction qui sont en train d'être exécuté en parallèle la première elle réalise l'exécution la deuxième de décodage la troisième elle est à l'étape de dispatch la quatrième elle est en train de recevoir le résultat de lecture mois là la 4l pendant deux trois quatre cinquièmes elle est en train de d'attendre le résultat de lecture mémoire
la sixième est leur voix elle est en train d'envoyer le l'adresse mémoire ali avant mémoire et la 7e elle est en train de générer l'adresse de la dernière dernières instructions donc ça c'est ce qu'on appelle l'effet people vous voyez ici que le pipeline il a un avantage très précieux dans le parallélisme très souhaitable dans les opérations de traitement numérique du signal donc dans les processeurs des esprits donc voila tout pour cette séance je vous donne rendez vous la prochaine fois pour explorer la partie registre périphériques et interruptions ddsp cx d'ici là je vous dis en
soirée c'est l'américain