wir wollen uns als nächstes datenstrukturen für graphen an senkt und dazu überlegen uns erst mal welche operationen wie auf graphen den benötigen und genau wie aufbäumen wollen wir natürlich knoten einfügen und löschen können darum bei einem baum uns die position aussuchen konnten wo man den knoten einfügen in blood knoten einfügen beim beerbaum links oder rechts aber in graphen allgemeineren operationen nämlich das einfügen von kanten und wenn man so eine kante eine verbindung zwischen bei zwei knoten aufstellen dann wollen wir die natürlich auch wieder entfernen können wir wollen als auch kanten löschen können wir wollen knoten
und kann jeweils einfügen und löschen und somit den grafen manipulieren können wir wollen natürlich auch alle knoten alle kannten aufzählen können einmal in der beliebigen reihenfolge das sollte jede datenstruktur von sich aus hier geben und dann wenn man den nächsten kapitel der vorlesung sehen dass es natürlich ähnlich wie für die bäume von uns verschiedene durchläufe angeschaut haben auch für graphen systematischen aufzählungen der knoten beziehungsweise kanten gibt und wir werden sehen dass auch die anderen die wir dann verwenden werden ähnlich sind zu den algorithmen die wir uns auf bäumen schon überlegt haben wir möchten außerdem entscheiden
können ob zwei knoten durch eine kante verbunden sind und wir wollen vor allem knoten alle kannten aufzählen können die von diesem knoten ausgehen oder die in diesen knoten einführen die unterscheidung ist wieder wichtig bei gerichteten graphen für ungerichtete graphen ist beides das gleiche jede kante die raus geht geht auch rein wenn man sich diese operationen noch bei anschaut einmal das aufzählen aller knoten das was das mache ich global für den ganzen grafen das entscheiden ob zwei knoten durch eine kante verbunden sind oder auch das aufzählen aller eingehenden und ausgehenden kanten für einen knoten das sind
operationen die laufen lokal lokal bedeutet ich stelle mich an einen knoten und betrachten den kleinen ausschnitt das graphen also die kanten die aus diesen knoten rausgehen es gibt für graphen sehr viele verschiedene datenstrukturen die alle sinnvoll sind beziehungsweise für jede klasse von datenstrukturen gibt es im detail wieder viele verschiedene varianten von implementierungen und ich muss mir hier recht gut überlegen welche variante welche daten struktur welche implementierung es denn sein soll und ich muss das ganze in der regel auf meine anwendung anpassen ich muss mir also überlegen welche diese operationen brauche ich denn tatsächlich bzw welche
für ich oft aus ist mein k4 statisch also etwas was ich einmal auf bauunternehmer verändert sondern einfach noch durchlaufen beispiel ist der atlas die landkarte der straßen jetzt verändert sich zwar aber nicht besonders schnell also hier werde ich selten was einfügen oder löschen aber eben sehr oft straßenzüge nachvollziehen oder ist mein graf hier dynamisch hier kommt weg also habe ich ständig operationen wie einfügen und löschen die den grafen an sich verändern sind zwei ganz unterschiedliche anforderungen an eine datenstruktur wir werden sind folgenden kanten und knoten listen anschauen sehr einfache datenstrukturen wo man tatsächlich nicht mal
eine datenstruktur implementieren so einfach verwenden werden uns die lizenz matrizen anschauen von den patienten matrizen zwar die lizenz listen gehen und dann nochmal den kurzen ausflug wieder zurück zur lizenz matrizen zu einer speziellen klasse von adia zenz matrizen sogenannten dünn besetzten hat jahrzehnts matrizen machen für alle gilt im wesentlichen wollen wir eigentlich nur diese menge von knoten menge von kanten im rechner darstellen aber ebenso dass wir all unsere operationen die wir gerade besprochen haben auch effizient durchführen können von in der regel sind das eben suchabfragen entscheide ob es eine kante zwischen zwei knoten gibt bzw
gib mir alle kannten die von einem knoten ausgehen wichtig ist mir hier noch der hinweis alles was wir hier betrachten sind ich hab sehr umschrieben mit mehr oder weniger konkreten beispielen das heißt manchmal bin ich recht konkret wie bald erkannten und bei der knoten liste wo ich einen vorschlag für eine implementierung macht manchmal bin ich eher vage warum weil alle diese datenstrukturen tatsächlich wieder sekundär datenstrukturen verwenden wo ich mir überlegen kann das könnte ich jetzt mit einer verketteten beste mit einem re mit mesh tabelle mit einem baum implementieren und je nachdem welche wahrlich für die
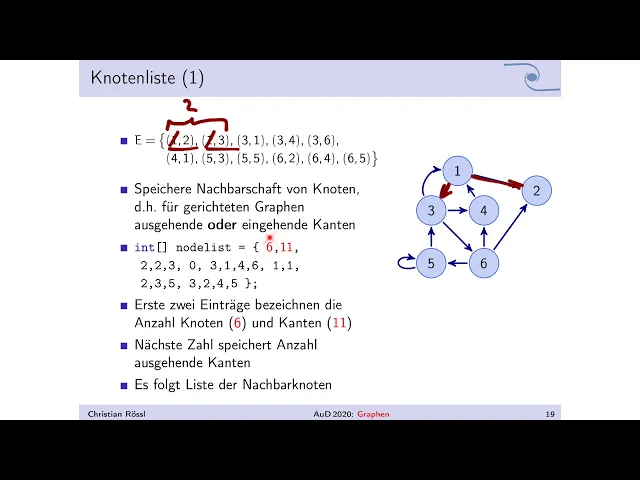
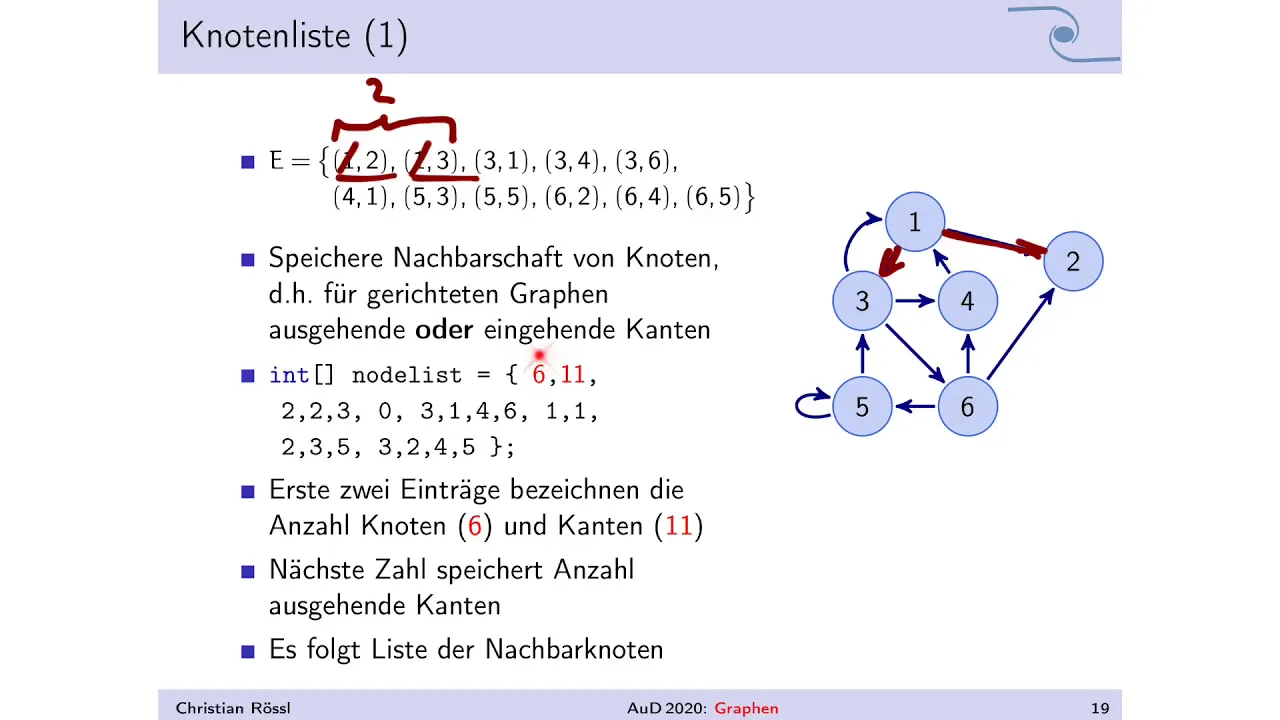
sekundär datenstruktur dann treffe hat meine graf datenstruktur auch ganz andere eigenschaften wir fangen an mit der kanten liste ist sehr einfach die datenstruktur wir speichern einfach die liste aller kanten ich nehme hier als beispiel einen gerichteten trafen das heißt gespeichert einfach eine menge von paaren menge bedeutet die reihenfolge ist egal wenn ich diese menge speichere dann ist's einerlei welche reihenfolge ich wähle aber ich kann natürlich das ganze in einem harry speichern wenn ich meine knoten durch ganze zahlen darstellen also einfach durchnummerieren dann kann ich diese kanten müsste einfach in einem jahr von inter zu speichern
wo ist die knoten löste geblieben die knoten liste bekomme ich implizit indem ich einfach durch diese paare lauf und mir schau welche knoten indizes kommenden vor alle die vorkommen beschreiben mir meine knoten löste oder noch einfacher gesagt meine knoten sind durchnummeriert von 1 bis in und dieses n die anzahl der knoten die gebe ich in meiner datenstruktur in meiner kanten büste an nachdem diese zahl auch wieder vom typ im test kann ich das hier praktischerweise im gleichen rahmen ich gebe also einmal die anzahl der knoten an danach gebe ich auch noch die anzahl der kanten
an die angabe ist hier in gewisser weise redundant denn in java kann ich ja für jedes die länge des harrys auch abfragen vorsicht ausgeht in java c oder c++ geht es zum beispiel nicht oder zumindest nicht so einfach wenn ich bei einem feld bei dem harry bleibt wenn ich die länge abfragen kann dann kann ich natürlich ganz einfach rück rechnen weil ich weiß sind paare es gehören immer zwei zusammen ich speicher diese zahl hier einfach noch also die ersten beiden zahlen in diesem jahr sind die anzahl der knoten und die anzahl der kanten und alles
was danach kommt das sind paare in der kanten liste 12 13 jetzt 21 39 55 und 58 und 62 62 und so weiter also die ganz einfach die datenstruktur oder eigentlich gar keine datenstruktur sondern einfach nur eine reihe von zahlen richtig interpretiert codiert mir das diesen gerichteten grafen so arg viel kann ich mit der kanten müsste jetzt allerdings nicht machen was ich mit der kanten liste machen kann ist alle kannten aufzählen oder wenn ich mir für jeden knoten irgendwo noch die position in der ebene gemerkt hab oder meine position in der ebene verschafft habt dann
könnte ich so was wie diese zeichnung hier anfertigen in dem ich meine kanten liste einmal durchlauf jeweils den entsprechenden knoten zeichnen immer dann wenn der knoten das erste mal in einem paar vorkommt und jedes mal wenn ich so ein paar lese den entsprechenden pfeil zeigt viel mehr geht nicht bzw viel mehr geht nicht effizient denn ich muss diese kanten liste immer von vorne nach hinten durch laufen ja insbesondere solche abfragen wie welche kanten gehen dann aus den knoten drei hier aus das ist die zu eins die zu 4 die kann ich hier nicht so einfach
beantworten kurz nachdenken das geht tatsächlich mit einem kleinen trick und dann sind wir schon bei der variante von der kanten müsste ja relativ einfach wenn man sagen wir speichern tatsächlich fällt von paaren ab und wir ordnen diese paare mexiko grafisch ich habe das hier so gemacht mexiko grafisch bedeutet nach dem ersten eintrag bei gleichem ersten eintrag nach dem zweiten eintrag dann könnten wir hier zum beispiel suchen wir könnten eine binäre suche machen auf dem feld und den bereich aller paare suchen die in der ersten komponenten 3 hat das kann ich nicht mit mir bin ihren
suche machen und dann sehe ich sofort okay von der drei komme ich mit bekannte zu 1 und zu viel also auch solche dinge sind möglich dann darf es vielleicht ganz so einfach machen wie hier soll nämlich dass paare einen harry einsortieren und wir sehen es ist immer noch eine einfache datenstruktur aber schon eine variante mit der sortierung kann ich in dem fall was gewinnen wir schauen uns eine andere möglichkeit an wie wir von dem knoten die ausgehenden kanten einfach aufzählen können und damit kommen wir zur knoten liste in der knoten liste speichere ich jetzt die
nachbarschaft von knoten wir gehen mal von den gerichten grafenaus in dem fall muss ich mich entscheiden ob ich ausgehende oder eingehende kanten speichern möchte also ich muss mich für eine der richtungen entscheiden im prinzip bedeutet das nichts anderes als dass wir unsere kanten liste nehmen und ihr zehn mal zwei karten die aus dem knoten eins raus gehen die eine geht zu zwei andere geht zur 3 dann müssen uns diesen knoten 1 ja gar nimmer explizit merken sondern es reicht wenn wir uns die zwei und die drei werken zusätzlich noch mit dem hinweis dass es leben
insgesamt zwei kanten gibt die aus dem ersten knoten rausgehen das ist schon die grundidee für diese knoten liste gespeichert das wieder ganz einfach indem er in die erste zahl ist die anzahl knoten die zweite anzahl ist die anzahl kanten und was jetzt kommt hat nicht mehr so viel struktur wie die krankenliste wo immer zwei zahlen zusammen gehören sondern jetzt habe ich immer eine zahl diese zwei hier gesagt mir wie viele ausgehende kannten hatten der entsprechende knoten danach kommen die entsprechenden indizes der knoten die zwei und die drei hier und dann mache ich das ganze für
den nächsten knoten hier wäre der nächste knoten der knoten zwei aus dem knoten 2 kommt aber keine kante raus und deswegen haben wir hier länge von null da passiert nichts weiter danach haben wir den knoten 3 braucht man sich explizit speichern sondern ja wir durchnummeriert erste knoten zweiter knoten nach dem zweiten kommt der dritte und aus dem knoten nur drei habe ich eine kante zum knoten 1 und eine kante zum knoten 4 und noch eine kante zum knoten 6 2 146 sind insgesamt drei stück das heißt bis 3 die rdx mir wieder die anzahl und
so weiter und so fort also ich habe immer eine zahl die mir sagt wie viele ausgehenden kanten kommenden jetzt dann die indizes der ziel knoten und dann geht es weiter mit der info für den nächsten knoten und wichtig es kann eben sein das ist ein knoten gibt hier die zwei der keine ausgehenden kanten hat dann steht da 0 es kann den knoten geben so wie hier die die vier der hat genau einen ausgehenden zu 1 und die fünf die hat zwei ausgehende zu 3 und eben wieder zu fünf jahren die schleife mehr sehen zu schleife
hier nicht ganz so schön an wie im anderen beispiel wo man tatsächlich 55 hintereinander hatten mussten wir mit zellen 1234 das ist die info für den fünften noten dass die für den sechsten knoten auch nicht schwer man muss ein bisschen genauer hinschauen der vorteil ist wir wollen dahin kommen dass wir tatsächlich für jeden knoten die ausgehenden kno erkannten hierfür den knoten nummer drei einfach aufzählen können so ganz einfach war es aber leider noch nicht hier oben haben wir nochmal unsere knoten liste wie gerade eben ganz einfach ist es nicht weil wir müssen ja wenn die
erste zwar hier immer eine anzahl an gibt dann wissen wir dass hier erst die info für den kersten knoten dann kommen zwei zahlen und danach kommt die nächste zahl die mir den nächsten knoten beschreibt hier passte hier habe ich null also kann ich gleich 1 weitergehen die habe ich nicht drei also gehe ich drei +14 weiter habe ich eine eins also gehe ich 12 war die hab ich ne 22 bis 23 weiter ich muss von knoten zu knoten springen in dieser tabelle und dafür muss ich von vorne anfangen und bis hinten springen um zum beispiel
alle ausgehenden kanten für den letzten knoten den im index 6 anzugeben also knoten uhr 1 2346 wanders mit einer ganz einfachen und simplen idee kümmern das deutlich besser machen wir verwenden einfach zwei tabellen und wir bleiben bei ganz einfachen integer er ist der erste das erste feld speichert die nachbarschaft für alle knoten das heißt dass es diese information die hier jeweils kam nachdem wir die anzahl der ausgehenden kanten kotiert wir lassen also das was ich hier tue ist umrandet hat einfach weg übrig bleibt diese liste hier 23 146 1 3524 5 wir behalten nur das
was ich hier rot unterstrichen kann irgendwie müssen wir jetzt natürlich die information noch rekonstruieren wie viele zahlen hier jeweils zusammen gehören ich habe das hier mit leerzeichen angedeutet so kann dies zwar sehen aber in america nicht das natürlich nicht unterscheiden dass wir jeweils getrennt wird ich brauche also diese information die ich hier ausgelöscht habe wieder und die speichere ich in dem fall in einem zweiten harry dieses zweite beinhaltet für jeden knoten den index im nachbarschafts perry für jeden knoten bedeutet wir fangen in java mit null an zu zählen ich nummerieren meine knoten hier beginnend von
der einst also der nullten eintrag im raum steht für den erste knoten also gleich herz der knoten der nächste eintrag für den zweiten dritten vierten fünften sechsten diese letzte zahl sehen wir gleich was die soll ich nehmen noch eine zahl mehr mit wichtig jede zahl in diesem jahr gibt mir jetzt einen index in das andere jede zahl steht für einen knoten bis auf die letzte die kopf noch mit dazu so was bedeutet index in dieses das bedeutet für den knoten nummer eins fängt die nachbarschaft information hier an am index 0 für den knoten nummer zwei
fängt die nachbarschaft information hier an am index 2 für den knoten nummer drei fängt die nachbarschaft information am gleichen index an warum der knoten nummer zwei hat er keine ausgehenden kannten so für den knoten nummer vier steht hier nur 55 bedeutet wenn ich zählen 0 1 2 3 4 5 ich zeig dir auf noten nummer sechs entschuldigung knoten über 40 knoten nummer vier hier ist immer für den knoten nummer fünf bin ich beim index 6 für den knoten nummer sechs bin ich hier beim index 8 und dann noch die 24 die 5 nicht aufzählen muss
so was soll jetzt diese letzte zahl die 11 die elf steht einfach für das ende der tabelle das heißt der die info zum letzten knoten steht hier am index 8 also wenn ich drüber schreibt 01 jetzt aber in ybbs 2 3 4 5 6 7 8 9 10 und 11 wir jetzt quasi der nächste eintrag würde es einen siebten knoten geben dann würde der an der position elf beginnen also diese elf sagt mir quasi bruder harry zu ende ist zeigt mir auf die hypothetische nächste position diese elf hat damit noch eine andere aussage dekodiert mir
nämlich damit die anzahl kannten also ich habe in dieser letzten zahl die hand zwei kanten gezählt so jetzt weiß ich für jeden knoten wo es anfängt also für den ersten knoten fange ich beim index 0 an zu zählen ich weiß aber nicht wie weit daher das ist ganz leicht ich sehe so weit bis vor den nächsten index also von den 0 2 1 und ab der 2 gehört er schon zum nächsten knoten und so weiter und so fort das heißt je zwei aufeinander folgende zahlen geben wir jetzt den bereich von ausgehenden kanten für einen bestimmten
knoten an um den knoten zu adressieren muss ich einfach nur einen index zugriff in diesem eray machen um zu sehen wo zu ende ist gehe ich einfach ein zweiter und schaue mir den index an die differenz zwischen den beiden indizes gibt mir die anzeigt kannten die vom jeweiligen knoten ausgeht 20 22 - 20 52 gibt 365 gibt 1806 211 - 83 und jetzt immer auch noch mal warum wir uns die mühe machten diesen letzten eintrag mit zu speichern auf die art und weise müssen wir keine fall unterscheidung machen wenn das re zu ende ist und
schauen was passiert denn jetzt am letzten knoten mehr einfach hier diesen wert noch eingefügt das heißt wir dürfen auch nach dem letzten knoten in diesem jahr noch 1 weitergehen und differenzen bilden bzw uns anschaut wo ist es denn tatsächlich zu ende wenn man zusammenfassen dann speichert diese zweite tabelle die nachbarschaft von den knoten in dem sie indizes in die erste tabelle die nachbarschafts tabelle angeht längen angaben muss ich nicht explizit speichern ich nehme einfach differenzen von einträgen in der knoten tabelle damit ich keine fall unterscheidung am ende brauche habe ich die anzahl kann ihr explizit
nochmal codiert als letzten eintrag der zug einem knoten korrespondiert ich kann damit eben auch die nachbarschaft der knoten direkt zugreifen indem ich die entsprechenden positionen in den rs abfrage hier stehen noch mal genau das was wir gerade gesprochen kann also ich kann die nachbarschaft abfragen ich kann anzahl der knoten insgesamt abfragen das ist die anzahl im knoten harry -1 gerade - diese letzte position und die elf steht ich kann für einen bestimmten knoten die anzahl ausgehende entschuldigt kann die anzahl kanten erfragen und kann für einen bestimmten knoten die anzahl der ausgehenden kanten erfragen indem ich
differenzen zwischen jeweils zwei aufeinanderfolgenden einträgen hier nehmen und wenn ich nicht nur die hand zwar wissen will sondern die entsprechenden einträge dann mache ich mich einen verkauf in dieses und zell die kanten auf für den dem fall wird es der zweite knoten da gibt es keine ausgehende kannte sehe ich ich habe dinge nur die anzahl 0 und müsste auch nichts weiter ausgeben für den nächsten hätte ich dann die einst die 46 wenn wir uns knoten und kanten listen noch mal betrachten und uns überlegen wo kann ich sehr gut einsetzen oder welche operationen unterstützen sie ihr
nicht dann wird schnell klar dass ich diese kanten und knoten ist nicht verwenden kann für graphen die ich immer wieder verändern möchte wo ich immer wieder kanten einfüge oder lösche diese operationen sind hier teuer ich kann aber grafen wo das nicht passiert oft sehr gut damit darstellt bestehendes straßen jetzt zum beispiel ändert sich wenig hier kann ich die kanten oder eine knoten liste als datenstruktur verwenden insbesondere wenn ich diese straßennetz vielleicht einfach nur in teilen darstellen möchte zeichnen möchte ganz klassische anwendung verkannten und knoten listen sind dateiformate und grafen abzuspeichern hier reicht mir das völlig
und wenn der graf einmal in der datei abgespeichert ist ja um ihn zu ändern lese ich erstmal die datei wieder ein in eine andere datenstruktur die ich im hauptspeicher halten kann dann ende ich ihn in irgendeiner anderen datenstrukturen dann kann ich ihn wieder abspeichern als kanten oder knoten müsste kanten listen erlauben das einfache aufzählen von kanten damit kann ich zb landkarte oder die straßenkarte zeichnen voraussetzung hier ist dass ich die positionen der knoten irgendwo gespeichert habe allerdings ist für die kanten liste nicht einfach die nachbarschaft von knoten aufzuzählen es sei denn ich mache diesen trick
mit der mexiko grafischen ordnung das heißt ich habe tatsächlich paare die mehr kanten bezeichnen in einem essay das kann ich in dem harry machen und dann sortieren binäre suche machen das kann ich natürlich auch und schon sind wir wieder eine variante im such bau machen auch hier kann ich einfügen und da kann ich auch sogar wieder einfach löschen und dann bereich suchen machen um für jeden knoten zu sagen welche sind denn die ausgehend kann die knoten indizes werden ihr mehrfach gespeichert das heißt wenn man es überlegen ob das gut ist für dateiformat vielleicht nicht unbedingt
ich spreche hier dinge redundant mehrfach die ich vielleicht geschickter speichern könnte boten müssten dagegen erlaubt mir eine einfache und effiziente aufzählung der nachbarschaft von knoten insbesondere wenn ich diesen trick mit den zwei tabellen verwende das ist tatsächlich auch eine gängige datenstruktur um sogenannte dünn besetzte matrizen wir werden das in form von adia zenz matrizen noch kennenlernen zu implementieren und ja da hat man zu einer anderen möglichkeit oder anderen interpretation für die datenstruktur die grafen darstellen kann auch gleich eine sinnvolle und vor allem sehr einfache implementierung ich brauche einfach nur etwas noch nicht geht ist zu
entscheiden ob eine bestimmte kante zwischen zwei knoten existiert hier brauche ich eine suche allerdings reicht meine suche in der nachbarschaft je nachdem wie mein graf aussieht ob von einem knoten ihr wenige kannten ausgehen oder ob es mehr passieren kann dass von einem knoten vielleicht kannten zu allen anderen knoten gehen ist das weniger oder mehr aufwändig oft kann man das in der praxis sinnvoll einschränken also für bestimmte grafen oder für viele graphen ist es einfach so dass diese nachbarschaft relativ kleines oder vielleicht sogar durch eine konstante abgeschätzt werden kann dann kann man auch diese suche effizient
ausführen wenn ich die andere richtung auch haben möchte das heißt ich habe mich entschieden ausgehenden kanten zu speichern möchte die eingehenden kann aber auch abfragen dann ja würde ich sozusagen diese datenstruktur transponieren am einfachsten ist es ich halte die datenstruktur einfach zweimal also zwei tabellen eine für die eingehenden eine für den ausgehenden kannten es ist natürlich redundant wenn ich das eine habe kann ich das andere auch berechnen allerdings muss ich dafür alle könnten einmal auf zählen das will ich für so eine lokale abfrage gibt mir alle eingehenden kanten zu den bestimmten knoten natürlich nicht als
nächstes schauen wir uns so genannten a lizenz matrizen als und auf englisch bedeutet benachbart manchmal auch auf deutsch hat ja cent jason szenes nachbarschaft kommt natürlich aus dem lateinischen ich verwende das wort hat ja cent im deutschen gehen nicht versagen entspreche übertrafen meistens liege ich dann doch ihr beim englischen oder beim englischen der begriff patient matrizen der ist allerdings sehr gängig die idee ist ganz einfach ich kreiere hier kannten als einträge in einer matrix und diese matrix ist wenn man so will ein zweidimensionales fällt mit zeilen und spalten und ich habe genauso viele zeilen und
so viele spalten wie ich knoten hat das heißt wenn ich insgesamt fünf knoten habe dann habe ich hier fünf spalten und die zeilen zeichne ich jetzt nicht mehr an generiere ich durch 12345 123 uns weiter und die idee es jetzt wann immer es eine kante vom knoten zu knoten j geht gibt dann markiere ich mir in der gegend seile und in der jacken spalte den eintrag und die konvention ist die a lizenz matrix hat null stehen dort wo es keine kanten gibt und ansonsten die zahl um gleich null in der regel nur eins dort wo
man kannte also wenn man die kante von 2 nach drei haben dann schreiben hier eine einzeln und stellen uns vor dass in allen anderen einträgen patricks bullen stehen und so weiter ich habe die matrix hier ja über einem feld definiert oder über eine menge iks das können die zahlen 0 und 1 sein das können auch natürliche zahlen seien es ist oft attraktiv hier größere zahlen mengen zuzulassen weil auch die art und weise können wir mit der adac matrix ganz einfach auch gewichtete grafen definieren wir schreiben dann in den entsprechenden matrix eintrag das kannten gewicht rein
fertig das einzige wo man aufpassen müssen es darf dann natürlich keine kanten mit dem gewicht 0 leben oder ich brauch ne andere konventionen wie ich die tatsache dass ich dass es keine kante gibt darstellen wie gedacht normalerweise wenn ich von a lizenz matrizen spreche dann gehe ich immer davon aus dass diese matrix 01 einträge hat null dort wo es keine kante von ihnen nach j gibt und 1 dort wo es eine kante gibt hier hat man beispiel für den grafen den wir schon kennen nehmen wieder das beispiel im gerichteten grafen würde genauso mit dem ungewichteten
grafen gehen wie ist das ganze zu interpretieren wir haben hier die zeilen die spalten j wir uns jetzt hier beliebige kannte mal rausnehmen vom knoten 3 also zeile 123 zum knoten 1 spalte 1 da man hier tatsächlich nicht eins drin stehen und das ist tatsächlich diese kannte hier vom knoten 3 2 1 1 2 3 4 5 6 1 2 3 4 5 6 und wir schauen uns jetzt beispiel mal dieses paar an dass sechs sein also in der zeile sechs der eintrag in der spalte zwei das ist der hier das entspricht entspricht der kante
vom knoten sex zur knoten zum knoten zwei so wenn wir wissen wollen ob es vom knoten 2 eine kante zum knoten vier gibt das ist offensichtlich nicht der fall aber dann wird man nachschauen in der zweiten zeile zweite zeile die vierte spalte da steht eine null also gibt es diese kannte nicht so ich kann jetzt zwei dinge hier sehr einfach machen kann offensichtlich ganz einfach abfragen ob sie bestimmte kante gibt oder nicht ich muss einfach nur schauen ob der matrix eintrag anderer stelle ihr tun gleich null ist oder nicht ich kann gleichzeitig sehr einfach die
kanten aufzählen die von einem knoten weg gehen wenn wir das hier mal machen für den knoten 1 hier habe ich nicht kannte zum knoten 3 und eine kante zum knoten 2 was mache ich hier ich schaue mir einfach die erste zeile an die gehört zu knoten 1 in der zeile stehen die ausgehenden kanten mit einzel- und ich hab ausgehende kanten zur 23 so wenn ich wissen möchte welche kanten laufenden in den knoten nehmen den knoten vier hier rein sowie die zeilen die ausgehenden kann kodieren sagen mir die spalten jetzt was aus dem knoten raus läuft
wenn man das für den knoten vier machen dann haben wir hier [Musik] tschuldigung ich habe es genau falschen gesagt ausgehend war natürlich die zeile dass gerade hier jetzt wollen wir eingehend wenn man das für den knoten vier machen dann haben wir eine kante von knoten sex und eine kante von knoten drei die reingehen und das entsprechend diese beiden einträge hier in der spalte einmal in der 23 einmal in der 26 wir können das natürlich genauso machen für einen gerichteten grafen ich hab hier die adia zenz matrix einmal aufgeschrieben ohne dass ich die nullen explizit mit
eingetragen habe ich habe hier nur die einzeln eingetragen das ist eine ungerichtete grafen das heißt wir haben hier eine menge von zwei mengen das bedeutet wir müssen jeweils beide paare also von 1 nach zwei und von zwei wieder nach 1 1 für ineffizienz mattrick speichern den angerichteten grafen sowie den gerichten grafen wo wir beide paare einfügen das führt uns gleich zum nächsten wenn wir so eine matrix haben für einen um gerichteten grafen oder wenn wir so eine grad matrix haben für einen symmetrischen gerichteten grafen symmetrischer gerichte der graf bedeutet für jede kante von ihn nach
j gibt es auch die kante von j marie dann bedeutet das auch diese matrix ist symmetrisch entlang ihrer diagonal oder anders es bedeutet dass die matrix gleich ihrer transportierten es transponieren bedeutet ich vertauschte zeilen und spalten für den ungewichteten grafen habe ich ihn natürlich immer eine symmetrische mattrick stehen also hat jahrzehnts matratzen sind symmetrisch für ungerichtete oder für symmetrische gerichtete grafen diese unterscheidung symmetrisch nicht symmetrisch machten sinn für gerichtete grafen wenn ich weiß dass meine effizienz matrix symmetrisch ist dann könnte ich mir überlegen dass ich tatsächlich nur das eine untere oder obere dreieck speichere das
andere gar nicht erst speichere auf die art und weise spare ich die hälfte der einträge in der matrix wenn ich keine schleifen erlaube wie im ungerichtete grafen muss ich auch die diagonale nicht speichern speichern und ich weiß da stehen auf der diagonalen spar noch mal allerdings muss ich natürlich aufpassen wenn ich auf nachbarschaften jetzt zugreifen möchte dann muss ich mir das andere dreieck beim zugriff zumindest denken das macht die operationen kleines bisschen komplizierter vielleicht auch ein kleines bisschen weniger effizient das muss aber nicht sein weil speicher allein anfassen kostet uns auch schon was also es
kann sich lohnen hier nur ein dreieck zu speichern zuletzt haben wir noch ein beispiel für einen gewichteten grafen wir haben einfach die kanten gewichte das ist das beispiel das war ganz am anfang hatten jetzt in die matrix eingetragen also hiermit die kante von 1 nach zwei jahren gewicht von 2 dementsprechend steht hier in der zeile ein spalte 22 ja meine kannte die man leicht wiederfinden mit einem gewicht von 7 von der 321 als seide drei spalte 1 da steht eine sie das heißt die zahlen oder die einträge der matrix code ihren einfach die gewichte damit
haben wir schon eine darstellung unser gewicht funktion das einzige wo man aufpassen muss wenn wir vereinbaren dass 0 bedeutet es gibt keine kante dann ist nun natürlich als gewicht unzulässig ich gehe noch mal zurück zu dieser folie wenn wir uns überlegen was kostet denn jetzt zum beispiel eine lokale nachbarschaft uns anzusehen dann müssen wir hier einfach nur durch eine zeile oder durch eine spalte laufen dass es auf der einen seite sehr einfach zu implementieren auf der anderen seite dürften nicht vergessen das aufzählen alle einträge in einer zeile oder alle einträge in der spalte ist von
anzahl knoten denn miley matrix hat der dimension an zwei knoten in zeilen und den spalten richtung darüber wollen wir uns jetzt noch mal gedanken machen was kostet uns denn mit hat jahrzehnts matrizen zu arbeiten dazu bezeichnet immer die anzahl knoten mit einfügen und löschen von kanten das ist super einfach in lizenz matrizen denn das schaffe ich in konstanter zeit ich muss einfach nur den matrix eintrag ändern also eine eins rein schreiben oder eine 10 überschreiten einfügen oder löschen von der kante entscheiden ob bekannte existiert geht ebenfalls ein hoch von 1 nicht mal einfach nur den
entsprechenden matrix eintrag auslesen das aufzählen der nachbarschaft ein eines knotens das geht zwar leicht ich brauch die zeile oder die spalte in der matrix allerdings ich muss die komplett aus lesen um die 0 quasi überspringen oder ignorieren zu können ich musste trotzdem lesen weil ich weiß wo ich das dann in 0 steht das heißt ich habe aufwand ja ist linear in der anzahl knoten das ist nicht so gut noch schlimmer wird es wenn wir neue knoten einfügen das einfügen von der kante ist ganz leicht das einfügen von einem knoten dass es deutlich schwerer weil das
würde ja bedeuten dass unsere matrix ist und jetzt kommt ein neuer knoten noch dazu wir brauchen noch eine zusätzliche spalte und der zusätzliche zeile in der regel muss man an der stelle jetzt auch in unserem perry umkopieren also wenn wir unsere matrix in einem raid rotierten dann müssen wir komplett neues harry anlegen und neu schreiben und am kosten von in quadrath wenn man speichel geschickt vorreservieren dann gehts tick besser dann kriegt man das aufrufen und in runter arbeitens immer noch treu gleiches wenn man den knoten löschen wenn ich einfach nur die einträge in der zeile
und spalte auf null setzen darf und mit dann überlege ich merke mir irgendwo dass diese zeit diese spalte nicht mehr mitspielt dann schaffe ich das nur von n inklusive dieses auf null setzen wenn ich tatsächlich eine zeile und die entsprechende spalte aus eine matrix raus löschen muss dann muss ich die matrix wieder komplett neu aufstellen dann habe ich wieder kosten von in quadrath auch hier gilt man kann das geschickter speichern ich kann die matrix in einem eray speichern ich kann das auch als ein harry von harrys harry von teilen oder her ich von spalten speichern
dann schaffe ich es wieder in den jahre zeit dann geht das ganze schneller dann sind wir aber auch gleich im wesentlichen schon bei der allianz liste die wir als nächstes kennenlernen der speicherbedarf für die adia zenz matrix so wie wir es hier machen ist wovon in quadrath also anzahl knoten ins quadrat weil wir ja auch die für die nicht existierenden kanten einen eintrag in der matrix speichern müssen wichtig alle operationen auch weil ihr zins matrizen die wir uns hier angeschaut haben sind unabhängig von der anzeige kannten das wiederum ist der sehr praktische eigenschaft deswegen konnte
ich die anzahl knoten ja einfach mit einem ja mit m abkürzen wir kommen nicht durcheinander es gibt keinen anderen buchstaben wo die anzahl kanten interessiert uns hier tatsächlich nicht als nächstes jahr bei uns hat jahrzehnts listen an gerade war dabei hat jahrzehnts übertritten jetzt magazins listen und können wir uns von zwei seiten aus anschauen auf der einen seite ist es ganz ähnlich zu den knoten listen wo ich eine nachbarschaft von dem knoten speichern möchte aber jetzt möchte ich dynamische änderungen ermöglichen oder zumindest erleichtern das heißt die speicher dass nicht alles in einem raid sondern ich
teile das wieder auf auch eine ganze reihe von harings wir werden das gleich sehen oder ich kann es noch anders überlegen über die a lizenz matrix ich mache im prinzip genau das gleiche wie der in der adia zenz patricks allerdings überspringe ich alle 0 einträge die speichere ich einfach nicht ich kann auch allianz matrizen relativ einfach implementieren ich brauche einfach nur eine liste von knoten und jeder eintrag in dieser liste ist wiederum eine liste nämlich eine liste mit dem nachbar knoten die ich von diesem knoten über eine kante erreicht zum beispiel über eine ausgehende kannte
erreicht jetzt habe ich hier absichtlich jeweils liste geschrieben ich bin jetzt völlig frei zu entscheiden wie ich diese listen implementieren das kann ein feld sein das kann die verkettete liste sein das könnte aber auch sowas wie ne sch tabelle sein also auch hier ich habe die möglichkeit diese sekundäre datenstruktur zu wählen und je nachdem wie ich diese wahl treffen beeinflusst das verhalten beeinflusst das verhalten meiner hat jahrzehnts liste die ich implementieren möchten schauen wir uns gerade wieder ein beispiel an dass der gleiche graf den wir jetzt schon oft gesehen haben adia zenz liste bedeutet ich
habe einmal eine liste von knoten also das hier ist meine erste liste es ist ja nicht besonders sinnvoll eine verkettete liste von knoten zu nehmen also dass wir das was wir tatsächlich schön mit einem re speichern könnte und an jeder dieser in jedem eintrag dieses airways habe ich jetzt wieder eine listen datenstruktur die mir die knoten speichert die ich von diesem knoten über ihr ausgehende kannte erreicht also hier zum beispiel vom knoten drei komme ich zur 14 und zur 6 auch hier habe ich wieder die wahl ich kann hier der verkettete liste nehmen das wäre
für die nachbarschaft vielleicht tatsächlich sinnvoll ich kann auch hier überlegen ob ich nicht herein oder sowas wie unseren weg toni ich kann die knoten in sortierte reihenfolge halten ich kann sie auch einfach nur abspeichern es ist in dem fall egal weil es gibt keine reihenfolge in der ich die nachbar knoten kanonisch aufzählen könnte außer dass ich sag ich sortiere vielleicht nach noten aber ist unklar was das nach dem knoten wert nach dem knoten index ist unklar was das bedeuten soll allerdings wenn ich sortiere so wie ich es hier gemacht habe dann könnte ich eine binäre
suche anwenden bei nachbarn shops aufzählen nützt mir das erst mal nix aber zum beispiel bei der frage ob eine kante von drei nach vier existiert also ob es diese kante gibt dann würde ich jetzt hier am index dreinschauen und hier in dieser liste die vier suchen wenn ich hier sortiert habe und das ganze indem er ihr habt kann ich das mit einer sequenziellen suche machen ohne dass das allerdings nur wenn ich damit rechnen muss dass diese listen in dem grafen den ich darstellen wird relativ lang werden umgekehrt oder anderes beispiel wenn ich wissen möchte ob
eine kante vom knoten 13 knoten 5 gibt die gibt es nicht und gehe ich auch wieder hier in mainfeld schau an war steht in der liste am eintrag 3 schau mir an 1465 ist nicht dabei also gibt es keine kante von der 35 ich habe gesagt man könnte sich auch so was wie cash tabellen vorstellen warum kann das sinnvoll sein wenn ich immer wieder knoten einfügen und löschen möchte dann ist es durchaus sinnvoll diese knoten durch zu nummerieren aber diese nummerierung ja einfach nur immer weiter zu zählen das heißt wenn ich einen knoten einmal lösche
dann füge ich diesen knoten auch nie mehr ein sondern jeder knoten nicht einfügen muss irgendwie einen neuen namen eine neue nummer haben das heißt diese liste könnte dann gegebenenfalls auch sehr sehr lang werden haben und ich muss zwischendurch immer wieder einträge rauswerfen die ich nicht mehr drin haben will das kann ich in esch tabelle sehr einfach machen und dann wird ja dann muss ich mir gar nicht vorstellen dass ich alles aneinander hängen und vielleicht freie positionen weglasse sondern ich lösch einfach aus der hash tabelle oder auch so was wie einen abstrakten datentyp bzw abstrakte datentypen
map und diese abbildung wer hier eine abbildung von index des quell knotens aus dem die kante raus geht auf die knoten die ich durch hinausgehende kannte erreiche so das bedeutet natürlich auch wenn ich hier so was wie eine stabile cash map verwenden kann da kann ich natürlich auch überlegen ob es nicht sinnvoll sein kann ja so was in den such baum zu verwenden je nachdem was ich mache meine operationen wieder unterschiedlichen aufwand unterschiedliche eigenschaften wenn wir uns das ganze für die einfache form von adia zenz matrizen mal überlegen dann haben wir hier den speicher betrag
von in dem fall an zwei knoten plus an zwei kanten oder wovon an zwei knoten + anzahl kanten bei der adac matrix hat nur noch von anzahl knoten ins quadrat der konkrete aufwand für eine bestimmte operation ist abhängig von der entsprechenden darstellung der liste oder der sekundär datenstruktur das einfügen von kanten ist einfach ich muss an listen anhängen vorsichtig darf nicht vergessen ich muss immer wenn ich ihn kannte eigentlich sollte ich erstmal testen ob es diese kannte nicht vielleicht schon gibt was ich definitiv nicht haben will ist das ich nie kannte doppelt in der datenstruktur
das entspricht einer suche in der nachbarschaft oder einer suche in diesen kurzen listen vorsicht auch hier ist nicht gesagt dass die listen kurz bleiben müssen wenn ich grafen abo ich damit rechnen muss dass es kannten von einem knoten zu fast allen anderen knoten gibt dann können diese listen auch sie erlangt werden das löschen von knoten bedeutet ich muss ja aus diesem heraus dieser liste wasser aus flaschen jetzt habe ich vorhin so getan als wäre die lösung hier erst mal einfach nur eine stabile oder hören was anderes zu verwenden wo ich einfach knoten einfügen oder löschen
kann das geht leider nicht ganz so einfach schauen wir uns an warum das nicht so einfach geht haben nehmen wir mal an wir wollen diesen knoten fünf hier raus löschen dann reicht das nicht denn nur hier aus dieser liste heraus zu löschen und diese liste hier noch mit raus zu nehmen sondern der knoten 5 wird ja vielleicht noch von anderen knoten aus erreicht ich muss also tatsächlich alle anderen listen hier auch noch durchlaufen und schauen ob ich irgendwo ne 5 hab hier finde ich die 5 tatsächlich die muss auch noch aus ich kann würde ich
nicht sagen dass ich von der 6 aus zu einem knoten kommt den es nicht mehr gibt weilchen gelöscht habe ich muss diesen verweis auch noch löschen also das löschen von knoten ist auf den ersten blick einfach auf den zweiten blick erfordert aber tatsächlich noch mal eine suche und ja das entspricht in der patienten hat matrix dem speicher dient dem streichen von der zeile und einer spalte dementsprechend habe mir tatsächlich in ähnlichen aufwand ich muss danach noch mal alles suchen was in der entsprechenden spalte stehen könnte es ist nicht ganz einfach den aufwand für die verschiedenen
datenstrukturen die uns angeschaut haben sind voll abzuschätzen weil es tatsächlich oft auf die konkrete implementierung ankommt insbesondere dann wenn ich irgendwelche sekundär datenstrukturen wo ich zwischen der verketteten liste wurde annemarie wählen kann miteinander kombinieren muss deswegen diese tabelle hier möchte gar nicht groß durchgehend eher mit vorsicht genießen ich habe hier aufwand für eine typische wahl typische implementierung angegeben so wie man oft auch den büchern liest es kann sein dass mit einer kleinen änderung fast die gleiche datenstruktur sich tatsächlich anders verhält was mir wichtig ist ist zu sehen dass sich unterschiedliche datenstrukturen tatsächlich ganz unterschiedlich für
verschiedene operationen verhalten können es lohnt sich also in jedem fall sich vorher zu überlegen welche operationen muss ich dann auf meinem grafen oft ausführen und welche datenstruktur wähle ich denn dafür am besten zum schluss noch ein paar anmerkungen wenn ich knoten einfüge oder löschen dann kann ich mir vorstellen dass ich gegebenenfalls knoten um nummerieren möchte nehme die adia zenz liste hier knoten 123 und so weiter und hier habe ich dann meine listen sondern jetzt fange ich an dir was aus zu löschen ich möchte aber dass die liste der knoten immer noch ohne eine lücke bleibt
das heißt ich ziehe die drei jetzt hier hoch warum weil die indizes verwende ja jeder jeder knoten ist ein index in dieses das bedeutet aber das ist alles was hier unten kommt muss ich um nummerieren das schlimme ist ich muss nicht nur hier in diesem herum nummerieren im sinn von er das was vorher der knoten 33 war es jetzt steht jetzt an der stelle zwei sondern ich muss diese um nummerierung in meinen listen überall nachvollziehen wo ich ja die indizes hier referenziert vermeidet das nach möglichkeit also selbst wenn die a-lizenz liste mit hilfe von einem
re implementiert ist dann sollten die knoten nicht einfach harry in die zu sein sondern wir geben jedem knoten eindeutigen namen und in diesem harry und es dann keiner mehr sondern eine abbildung auf von diesen namen auf indizes auf die art und weise spar ich mir diese um nummerierung in den listen die hier noch dranhängen die ist tatsächlich toll am eigenen daten struktur die man hier wunderbar für sowas verwenden können ist die hash tabelle oder eine hash map wo ich ja den namen des knoten ich hab sie umschrieben mit adidas knoten abbilde auf den tatsächlich ein
tabellen index war also who steht dir denn hier wenn ich sowas noch dazwischen schalten dann kann ich mir so eine nummerierung ganz einfach spaß bei allianz matratzen ist das egal wenn hier zeilen oder spalten lösche und das auf naive art und weise macht dann habe ich sowieso quadratischen aufwand ansonsten wenn ich ein bisschen geschickter macht ist es mir auch egal weil ich habe die kanten einfach nur durch nullen und einsen gekennzeichnet er steht es wird nie explizit so wie hier in der knoten löste in irgendwelchen listen noch ein knoten index referenziert ich muss also nichts
mehr nach besser nichts mehr verändern schließlich in der regel wollen wir mit dem grafen noch mehr speichern als einfach nur knoten und kannten wir wollen doch zusätzliche attribute prognose und prognosen und provokanten speichern können das sind für die kanten ganz klassisch kann gewichte das könnten aber auch noch irgendwelche anderen attribute sein die ja irgendwas über den ablauf eines algorithmus aussagen wir werden knoten einfärben zum beispiel also wollen wir jedem knoten vielleicht farb- attribut geben und so weiter und so fort jede datenstruktur die wir uns überlegen und für die wir so einen algorithmus dann verwenden möchten
muss natürlich so erweiterbar sein dass wir diese attribute auch noch unterbringen können oder jede allgemeine graf datenstruktur muss so was leisten können