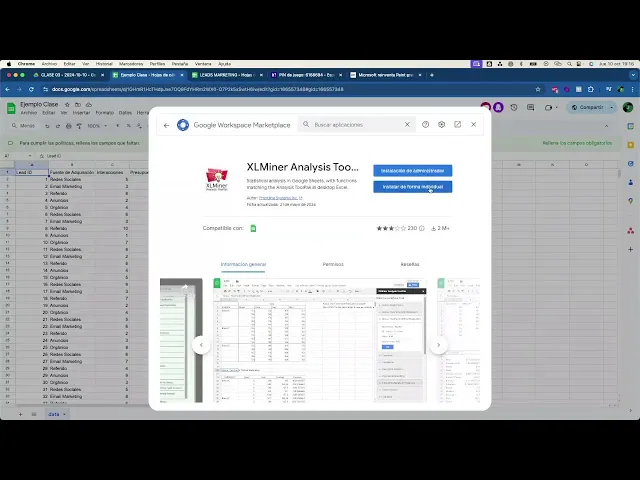
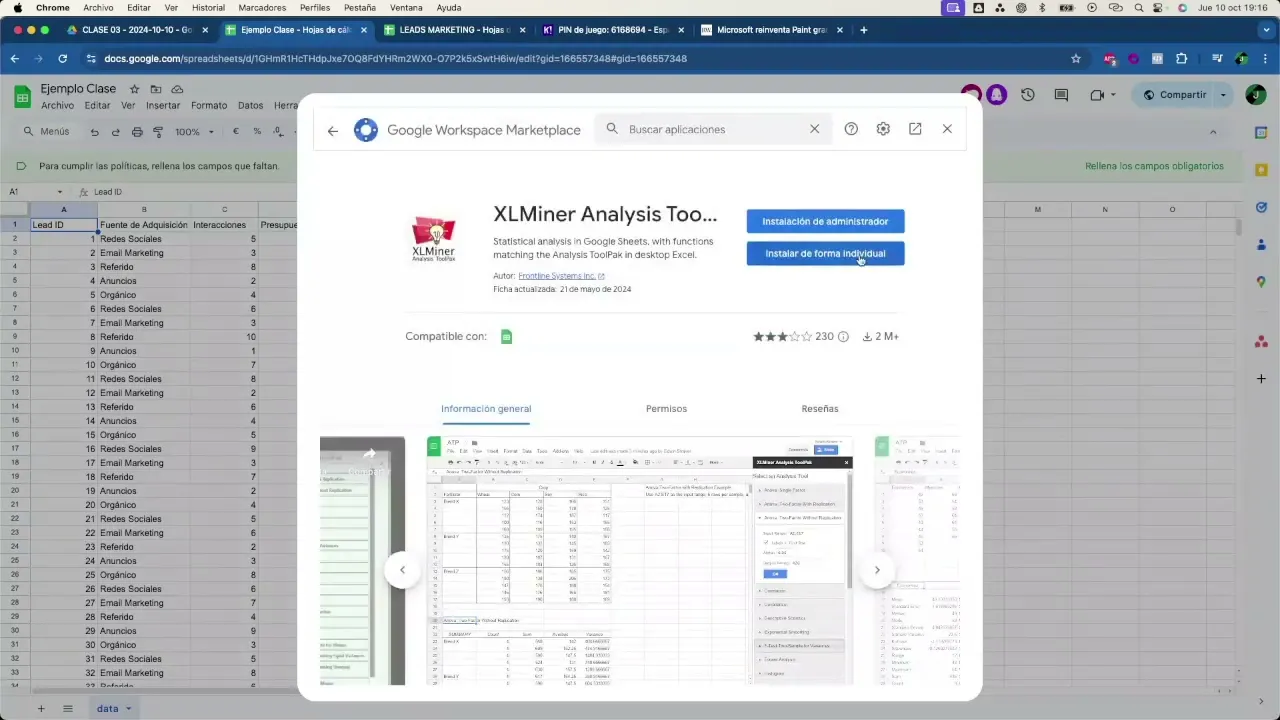
conversión de un l entonces lo que vamos a hacer durante la sesión de hoy eh lo vamos a hacer todo base a enfocar la clase con Google seats es donde vamos a realizar todo este ejercicio y vamos a crear sistema que permita predecir la probabilidad de conversión de un liink Entonces vamos a segir vamos a optimizar distintas estrategias vamos a a jugar con los datos las distintas columnas que tenemos y Vais a ir viendo como en función de las distintas variables que aplicamos pues obtienen unos resultados u otros entonces hoy veremos un análisis haremos un análisis predictivo básico sin ningún tipo de Inteligencia artificial donde obtenemos eh datos que analizaremos veremos si son datos buenos datos malos el Por qué han salido esos resultados Y también analizaremos cómo los podemos mejorar y ya en la sesión de la semana que viene Vamos a continuar este mismo ejercicio pero aplicando Inteligencia artificial y lo que decía va a durar distintas sesiones porque vamos a implementar distintos modelos de inteligencia en las próximas clases pues lo primero de todo vale aquí lo que os he dicho probabilidad de conversión de un lad y lo que os estaba contando vamos a ver pues introducción un poco al concepto de de yaa predictiva configuración del entorno que vamos a hacerlo todo en wsit creación de un modelo predictivo vamos a visualizar analizar los resultados y luego una conclusión y también os diré un poco lo que vamos a ver en la próxima clase por si alguno quiere investigar como ya tenéis el ejercicio y sabéis que se va a basar en esos datos por si alguno quiere avanzar Investigar por su cuenta de cada a la sesión de la semana que viene Entonces el objetivo de esta clase va a ser el modelo para identificar los leads usar complementos que ya vienen en Google seats vamos a instalar un complemento en concreto y visualizar datos lo primero de de todo vamos a repasar algunos conceptos que el que quería repasar con vosotros Hoy es el el un modelo predictivo Pues un modelo predictivo al final lo que hace es utilizar datos históricos que para anticipar o predecir lo que podría suceder en un futuro es decir yo tengo toda una Data de datos que he ido recogiendo y con eso me puedo predecir lo que va a suceder en este caso en concreto en la sesión de hoy vamos a utilizar un modelo de regresión para identificar qué lits potenciales eh clientes tien más probabilidades de convertirse no en en en clientes entonces imaginaos que tenéis una tienda online no y queréis saber por ejemplo qué visitantes tienen más probabilidad de comprar algo eh pues tenemos un registro histórico de cómo se han comportado esos visitantes en la web como información por número de visitas tiempo que han estado navegando por nuestra página web interacciones que han hecho con los distintos productos que tengo en la tienda si han convertido no han convertido pues bueno si a todos esos datos le aplicamos un modelo de regresión el modelo pues analiza todas las esas variables no visitas tiempo en la página interacciones conversiones Y aprende Y aprende Cuáles de ellas influyen más por ejemplo en en la compra entonces eh de esa manera podremos saber que en los datos eh actuales cada vez que entra un nuevo visitante podremos más o menos predecir eh la probabilidad de si nos va a comprar o no nos va a comprar e vamos a empezar con el kah vale si alguno queda por entrar no os preocupéis que tenéis el enlace lo he pasado antes por por el chat y la primera pregunta está relacionada con lo que acabo de explicar opción cumple el propósito de un modelo predictivo en marketing organizar reuniones de equipo eliminar datos no válidos hacer gráficos prci el comportamiento futuro de los leads es la respuesta correcta justo lo que habamos de explicar no modelo predictivo se basa en datos históricos para predecir un resultado que puede ocurrir en el futuro perfecto Pues nada esta clase va a ser muy práctica poco Vais a ver de presentación vamos a irnos directamente a Google sits lo primero que voy a hacer es con vosotros compartir es esta carpeta vale Ahí es donde voy a ir colgando toda la información de la clase de hoy para que podáis eh seguirla en esta carpeta que os comparto también voy a meter la información que os dije de las sesiones anteriores de los scripts de App Script de cómo integrar chpt que vimos en Google docs en Google slides en Google seeds todas esas funciones y distintas y otras funciones que no hemos visto pues las os las dejaré por ahí también para que podáis probar Bueno aquí tenéis una guía para que podáis seguirlo y y lo que vamos a hacer lo primero de todo es abrirnos una hoja de cálculo y lo primero es configurar nuestro dataset necesitamos datos lo primero de todo para hacer algo necesitamos los datos yo ya tengo un dataset que me he inventado preparado que también lo tenéis en esa carpeta lo vamos a importar Y a ver si lo tengo por aquí vale que es este el data. csv lo queremos insertar aquí y está separado por comas vale importamos los datos Y como veis aquí Bueno es un csv que incorpora distintas columnas con datos que hemos simulado Pues que incluye distintas Pues un identificador de de lit único de un a 100 lits Tenemos aquí tenemos la fuente de adquisición que es de dónde proviene pues ya sea de redes sociales de email marketing referido de anuncios de de orgánico que vienen de Google de email marketing pues distintas opciones de adquisición de tráfico interacciones es decir número de interacciones que ha tenido ese lad con la empresa presupuesto invertido que es la cantidad de dinero invertida en adquirir ese lip días desde el primer contacto el número de días transcurridos desde que se contactó por primera vez voy a poner aquí conversión que indica si el lad se convirtió en cliente o no y Tenemos también aquí una conversión numérica vale bueno que al final es no es un cero si es un uno esto la columna Tenemos aquí para que para las operaciones necesitamos que sean números y fuente numérica que es convertir la fuente de adquisición en valores numéricos lo mismo vale para hoy para hacer el modelo predictivo vamos a utilizar una un complemento que ya podemos instalar si nos vamos a extensiones complementos gestionar complementos y buscamos aquí este XL miner analysis tool pack que es este que yo ya lo tengo instalado Bueno si no lo tuviese instalado lo instalado un segundo para que veáis que se instala rápido simplemente puls aquí le dais instalar continuar como nois que Conectar a vuestra cuenta de Google le dais acceso y ya lo tendríais una vez ya está instalado ya lo podéis utilizar entonces antes de entrar en detalle con seguir con el ejercicio os voy a contar lo que acabamos de instalar Es un complemento de análisis estadístico y de datos avanzado para Google seats es similar no sé si os suena hay una herramienta de análisis de datos que se encuentra o se utiliza en Microsoft Excel Pues bueno Esto es simplemente para realizar análisis estadísticos y y y crear y poder crear modelos predictivos entonces lo que nos proporciona esto son funciones que no están disponibles en las opciones básicas que tenemos aquí en en en Google se antes de nada quería eh Como vamos a utilizar aquí mucho o bueno la terminología variable alguno sabría explicarme qué es una variable dependiente y Qué es una variable independiente alguno os anima a explicarlo Bueno pues la variable independiente es la que manipulamos Ah Bueno mira ahí Miguel Miguel Raúl adelante he visto que has levantado la mano sí Cómo se llama el extension porque estaba tratando de si lo abres des desde el mismo link permite hacer la extensi Entonces lo estaba copiando a mi Google Drve y estaba haciendo Entonces no no recuerdo el nombre de la extensión si me lo puede repetir sí se llama así xlm XL miner analysis toolpack lo han puesto por el chat vale pues lo que está explicando la variable independiente es la que manipulamos nosotros es la que controla se controla en un experimento entonces la que vamos modificando eh para observar su efecto en la variable dependiente es decir que es la causante del cambio que se pretende estudiar Entonces por ejemplo un experimento sobre Cómo afecta la cantidad de horas de estudio al rendimiento académico pues la variable independiente sería la cantidad de horas de estudio que es lo que vamos modificando y todo el rato en ese experimento para comprobar Cómo afecta eh o afecta el rendimiento académico y la variable dependiente es la que se la que se mide o se observa en el experimento la independiente de la que cambia y la dependiente de la que observe entonces un ejemplo así también sencillo pues eh En este caso en el que hemos dicho el de las horas para ver el rendimiento académico pues la dependiente sería el rendimiento académico ent en modo resumen independiente causa o el factor que se manipula y dependiente efecto resultado que miden una respuesta a la variable independiente vale continuamos eh lo que estábamos diciendo en este en este complemento que hemos utilizado el de XL miner Pues bueno sirve para generar eh modelos de predictivos Pues a eh permite realizar regresiones lineales no lineales para identificar relaciones entre variables y predecir valores futuros también evalúa cómo de fuerte es la relación entre dos o más variables permite calcular Perdón medidas como la media mediana desviación estándar varianza de de datos permite evaluar También si hay diferencias Bueno un montón de predicciones análisis eh de distintos modelos que que incorpora al sistema y que podemos utilizar hoy vamos a ver simplemente un modelo predictivo básico entonces Bueno ya lo hemos instalado y ahora vamos a utilizarlo cuando lo instalamos lo se nos pondrá aquí abajo podéis ver que lo tenemos aquí simplemente le damos a Start y se nos Abre aquí a la derecha como podéis ver pues todas las herramientas que podemos utilizar hoy vamos a utilizar en concreto a ver si la veo aquí que es una regresión lineal Aquí está vale un modelo de regresión lineal también para que entendáis un poco el concepto Es una herramienta matemática que nos ayuda a predecir un número basándonos en otros números imaginados un ejemplo así sencillo que queremos saber cuánto pesa una persona Según su altura Pues si tenemos todos los datos de las personas con sus pesos y alturas podemos trazar una línea que muestra cómo cambia el peso a medida que cambia la altura os he puesto aquí un ejemplo antes para entender un poco no Entonces esta línea al final es nuestra predicción y y es lo que nos permite más o menos predecir pues que que eh eh cuánto pesará una persona no en función de de sus datos Vale entonces vamos ahora a volver a nuestro ejemplo que lo que queríamos era eh calcular la probabilidad de de convertir un lid y vamos a configurar aquí en nuestra regresión lineal varios parámetros en el input aquí y Range lo que queremos pasarle ahora mismo le vamos a pasar es la todos los valores de la columna conversión numérica que es esta la columna G se lo vamos a pasar esta Va a ser vale nuestra variable dependiente es nuestra eh es la variable que vamos a observar acordados que la independiente es la que modificamos esta es la pendiente es la que vamos a observar para nuestro estudio entonces bueno seleccionamos la la columna simplemente pulsamos aquí automáticamente Ya se nos pone lo podemos poner también a mano si quisiera eh después para el input de X en este caso vamos a poner de hecho un segundo vamos a poner exactamente los datos que van de la línea 1 a la 101 vale vamos a marcarlos ahí y en el input X Range es el rango de entrada x vamos a seleccionar nuestras variables independientes vamos a seleccionar para este caso por ejemplo las interacciones el presupuesto invertido y días desde el primer contacto entonces seleccionamos de aquí aquí vale que sería de la c1 a la e101 lo que hemos seleccionado y quiero añadirle también la Fuente numérica que sería de la h1 a la h101 vale perfecto vamos a marcar la casilla Eh labels vale esta casilla lo que hace es que estamos diciendo que nuestra primera fila eh contiene etiquetas que son los nombres de las variables vale Si no marcá demos esta variable nos detectaría la primera fila como que estamos utilizando números si for una parte del del proceso de este del experimento y probablemente fallaría o sacaría errores entonces marcamos esta para indicar que la primera fila corresponde a los nombres de las variables eh dejamos eh el valor por defecto aquí en el 95 no vamos a tocar nada vamos a decirle el output Range quiero que me lo ponga en la columna J en la en la fila un aquí vale la columna J posición 1 y de aquí de momento tampoco vamos a a marcar nada le damos analizar ok A ver no sé si está tardando no lo Está sacando pero no sé si es mi internet o no pero no no me lo está sacando Ahora yo lo estoy haciendo contigo José y no me sale nada tampoco vale a si no tengo yo el ejemplo que había hecho yo antes de clase que lo tengo ahí todo puesto tiene que ver algo yo creo no se ha instalado bien o o no sé bueno en el out Range puede ser que le tengas que poner donde acaba también o y coma en lugar de coma aquí punto y coma podría ser eh vamos a probar H 101 hemos dicho h1 eh al h101 o si no vamos a hacerlo vamos a seleccionarlo así hemos dicho este a este no habíamos dicho la de no está cogiendo el rango mira ahora me ha hecho caso debe ser algo de agarr y pones la columna esa que quieres seleccionar al final y la pones al lado de la otra para que puedas seleccionar el rango de una sola pasada mueve la columna al lado de que quieres seleccionar la que tien al final despl para que la coloques al lado del otro Rango eso y selecci el rango podemos hacerlo así vale de la1 hemos dicho Ahora es F 101 vale aquí habíamos dicho que nos la pusiese en la j1 resultado Ah vale que se me olvidado cambiar esta h h1 a h101 hemos dicho que esta iba a ser nuestra conversión numérica vale Vale ahora sí que obtenemos los datos vale Perfecto aquí pues nos saca un montón de datos con los que con que funciona vale el error debería estar aquí efectivamente creo que lo habéis dicho alguno el punto y coma coma no sé por qué pero no estaba cogiendo bien bien el rango aquí y y tengo que verlo la verad no no sé cómo porque está fallando eh perdon un segundo quiero sacar otra cosa Esto lo tengo [Música] aquí Bueno antes de nada Vamos a repasar de analizar los resultados que ha salido eh Vamos a repasar estos conceptos que aparecen aquí para que entendamos un poco lo que significa cada cosa entonces dentro de aquí de regression statistics eh el el multiple vale r r Eh pensad Esto como una medida de fuerza que indica Cómo de bien las variables independientes se relacionan con la variable dependiente si el valor es está este valor si está muy cerca de uno significa que hay una fuerte relación y si y si está por debajo Pues todo lo contrario el siguiente el lr Square pues este eh valor nos dice el porcentaje del comportamiento de de la variable dependiente entonces con este dato lo que podemos hacer eh vale Este es r Square lo escriben así pero como lo soléis ver es eh r al cuadrado es como se suele escribir solo que como Ah ahí lo ponen ahí tal cual Eh entonces este nos permite predecir con las variables independientes eh Perdón nos permite eh el comportamiento lo que está diciendo el comportamiento de la variable dependiente se puede predecir con las variables independientes Entonces si el Square eh es alto el porcentaje es alto por ejemplo en este caso si eh en las ventas e no perdonad que es que est analizando un segundo los datos Porque no me [Música] cuadra alguno [Música] No porque no es que hecho yo perdonad es que he hecho un ejemplo yo porque preparando la clase esta esta tarde yo he hecho un ejemplo y os quería enseñar un caso concreto con unos datos de Por qué aparecía eh que os comparto aquí que yo me he hecho este mismo ejemplo toda est esta tarde y esta analizando y tal Y quería unos datos concretos para que me dieseis la respuesta bueno Entonces estos datos han salido mejores de los que os quería Mostrar que quería sacaros unos datos peores Pero bueno entonces lo que está diciendo eh este dato lo que nos hace Es que este valor nos dice Qué porcentaje del comportamiento de variable pendiente ventas se puede no en este caso nuestras ventas se puede predecir con las variables independientes si si está alto significa que las ventas se puede explicar por el presupuesto y y las interacciones eh este pues es similar al que acabamos de explicar pero eh lo ajusta teniendo en cuenta cuántas variables independientes Pues hay en el sistema Entonces esto es bastante Útil para saber si realmente necesitamos agregar más variables para mejorar eh nuestra o no y más conceptos que vamos a explicar eh tenía apuntado yo aquí para ver hoy este significance F pues muestra si el modelo en su totalidad tiene sentido estadísticamente si este valor es muy bajo Normalmente se suele decir menor de 0,05 significa que el modelo eh es útil y que las variables independient realmente tienen un efecto sobre la variable dependiente es como un un semáforo no que nos da luz verde que dice sí Este modelo sirve es valioso o Este modelo no sirve con lo con las variables que se está planteando y luego Tenemos aquí todos los coeficients eh el valor es [Música] 0. 05 0.
05 Sí justo es decir si si está por debajo eh es que es válido nuestro modelo y aquí los coeficientes pues vemos esto Estas son las variables no que hemos nosotros indicado al modelo para que interactuas y y tuviese en cuenta a la hora de predecir y los coeficientes nos muestra el efecto de cada variable independiente sobre la variable dependiente Entonces si el coeficiente para interacciones eh es alto y positivo no que como en este caso veis que tenemos algunos negativos y otros positivos entonces eh si si es alto y positivo significa que Cuanto más interacciones haya más probable es que se logre una venta vale vamos a a continuar con analizando esto que os vamos a poner a ver lo tengo aquí perdonad tengo unot de ventanas abiertas vale me interesa comparar por ejemplo este es el que hemos hecho ahora con vosotros eh que hemos pasado todas estas variables alguno sabría decirme os voy a poner otro ejemplo que he hecho yo con los mismos datos pero con menos cosas digo con menos variables independientes le he pasado si veis aquí le hemos pasado la Fuente numérica alguno sabría decirme si este modelo que hemos hecho nos sirve es válido o no es válido en función de lo que acabo de explicar Hola puedo puedo decir o hacer una reflexión Sí es que mira yo no soy mis compañeros pero yo la pantalla cuando la ponéis en compartido la veo muy pequeña veo a todo el mundo y yo creo que es que no se ve yo no veo ni ni los gráficos ni nada lo veo muy pequeño no había alguna ación de configuración ponerlo pantalla completo porque es que yo no lo veo bien los números y todo yo no sé como los compañeros y le das click encima de la pantalla Grand lo hago lo hago se me va y se me va la pantalla para abajo vale lo veis ahora mejor más grande ahora un poco mejor s si no pero hay a la derecha abajo un cuadradito tienes Sí pero yo le doy yo lo hago dec una tablet ahora ahora ahora mejor ahora mejor gracias eso Gracias gracias Nada ti vale perfecto Pues vale este Este es otro modelo que he sacado yo sobre el mismo los mismos datos vale pero que hecho y la tarde y le he pasado menos variables estos son los resultados que ha sacado alguno sabría decirme si este vale o no vale Yo por qué no vale o sí vale porque el significance está muy por encima de 0. 05 efectivamente lo que nos está diciendo si analizamos todo esto en función de lo que hemos hecho eh de lo que he explicado tal el significance y tal lo que nos está diciendo básicamente es que tiene muy pocas variables como para fiarnos de los resultados que está sacando entonces eh eh la única solución aquí pues es pasarle muchas más variables a este modelo le habíamos pasado Solamente la Fuente numérica Pues con solamente la Fuente numérica no puede predecir si eh va eh va a convertir una venta o no y bueno lo puede predecir pero eh aquí de hecho aquí hemos visto la probabilidad de conversión que ahora veremos cómo lo analizamos Y tal Pero no es fiable los datos le tendríamos que pasar mucha más información pues tema de interacciones presupuesto invertido días de contacto y tal si analizamos el que acabamos de hacer ahora en la clase un segundo que os lo pongo más grande pues veremos que cambian los valores tenemos muchas variables con las que jugar y ahora vamos a calcular también como hemos calculado yo antes en el mío vamos a calcular la probabilidad de conversión y vamos a ver cómo cambian esos datos pregunta sí Y si en vez de más variables multiplicaras por por 1000 o por un millón el número de en vez de 100 filas subiera 10. 000 o 100.
000 se incrementar o sea pasaría a Ser válida Cuantos más datos tengas siempre es mejor a la hora de analizar es decir Cuanto más Data más preciso vas a ser pero sí que es verdad que nuestro en el sistema que he hecho yo hoy esta tarde eh la Fuente numérica me dice muy poco no me aporta nada en este modelo es decir que es un dato realmente insignificante eh probablemente sería un pelín más preciso pero no no no me va a decir nada la verdad vale es decir que es es muy fácil es es probar luego podéis probar vosotros si a estos datos en vez de meterle 100 filas eh os creáis 100 filas más inventadas eh veréis Cómo cambia eh todos estos datos muy fácil de probar aquí una vez lo tienes hecho ya ves vas viendo cómo cambia pero depende No si si le ponemos por ejemplo eh año mes eh y cosas así O sea más más variables Entonces mejor el modelo eso bueno cada variable cada variable tiene un comportamiento distinto es también un poco lo que vamos a analizar hoy hemos empezado con una tabla de datos muy sencilla que es esto eh la idea de las sesiones por eso os he dicho que esto va a durar distintas sesiones vamos a meter datos eh más eh más datos a lo largo de la sesiones por ejemplo uno que has comentado eh Me parece muy interesante eh También jugar con la venta lo mismo que conviertan más en agosto que conviertan en febrero conviertan en mayo eh podemos jugar con datos incluso de años no Pues a lo mejor en este 2023 eh en 2023 convirtieron más y que en 2024 te permite analizar un montón cuantas más variables y más datos distintos tengas mejor de Cara a mejorar la precisión y calcular mejor por ejemplo en este caso en concreto que es Nuestro objetivo que es calcular la probabilidad de de un potencial cliente no que se convierta en cliente Cuanto más datos siempre es mejor pero con respecto a lo que habéis ha dicho Daniel ahora de si yo le meto un millón de datos más a esta tabla con lo que he analizado me va a mejorar O va a calcular algo siempre mejora pero un millón de datos Este modelo hubiese sido también probablemente inválido no nos hubiese servido de nada O sea que Jos es más efectivo la variable que la cantidad de datos entiendo no siempre es un Equilibrio es decir esto eh la clave es Buscar un equilibrio las sesiones anteriores cuando os decía cómo se no repasamos Cómo se desarrolla una Inteligencia artificial que al final no deja de ser un entrenamiento de datos yo siempre repetía lo mismo lo más importante el número uno es tener datos sin datos no no hay nada que entrenar y el segundo paso más importante era saber filtrar los datos saber qué datos son buenos para nosotros eh Porque yo puedo meter aquí datos de todo tipo pero es que a lo mejor el 80% de los datos no me sirve nada A lo mejor Aquí hay alguna columna que no me aporta nada que me la podría eliminar perfectamente entonces saber con qué datos estamos jugando y que el conjunto de datos que preparamos que preparemos sea el mejor posible y después el tener datos Cuantos más datos tengas siempre mejor pero el tener datos no es sinónimo de que nuestro sistema vaya a funcionar o o no luego durante el entrenamiento ya sea una Inteligencia artificial o de este modelo muy básico que estamos viendo ahora intervienen muchísimas otras variables Entonces todos tod estas variables son con las que jugamos no el otro día la última sesión que estuvisteis conmigo os enseñé Cómo crear un modelo de Machine learning eh básico entonces veíamos como cambiamos variables no íbamos cambiando variables por los EPOC que son las vueltas que da a un entrenamiento completo de todos los datos pues y o el número de datos que entrenamos pues íbamos viendo cómo eh íbamos cambiando esas variables y el sistema era capaz de ser más preciso o e ser más preciso pero tardaba más eh si bajaba Pues a lo mejor era más rápido pero la probabilidad no era tan la precisión no era tan buena pero bueno al final la clave siempre es encontrar el equilibrio de las de los datos que tenemos las variables con las que jugamos y y tal y la única manera de esto es no queda otra que prueba de error y ir Ajustando ir analizando los resultados tener muy claro Cuál es el objetivo qué es lo que queremos obtener y ir Ajustando e ir aprendiendo entonces Bueno ahora lo que estamos viendo yo lo que quería ver que vieseis en la clase de ahora es bueno Cómo enseñaros esta herramienta que no es inteligencia vale lo complemento este la extensión esta que Estamos instalando no utiliza nada Inteligencia artificial son simplemente modelos matemáticos no existe Inteligencia artificial aquí pero bueno quería saber eh que vieseis como lo hace se hace de una manera más matemática más eh manual porque en la próxima sesión vamos a calcular esta misma probabilidad pero ya con modelos de Inteligencia artificial entonces compararemos ambas versiones la versión de la clase de hoy queé resultados nos ha sacado y la versión que vamos a ver en la clase siguiente que va a ser con Inteligencia artificial también para que quiero que veáis Eh pues no el típico debate no me fío de la inteligencia o no me fío de la igencia Pues habrá cosas positivas y cosas negativas al final eh lo ideal pues repito es ese equilibrio que yo pueda convivir con este sistema que estoy montando y a la vez le meta inteligencia y que convivan ambos sistemas y encontrarlo la mejor solución posible Miguel veo que has levantado la mano sí José para mí para mí este este ejercicio fue revelador en en un ejercicio que estaba haciendo aquí cogí datos del del lector biométrico y traté de con un algoritmo eh eh predecir Qué cantidad de personas venía a la oficina y entonces un uno de de de los chicos que trabaja conmigo que tiene una maestría en en el modelo no me daba bien o sea no no me predecía bien no me hacía bien las predicciones Me dijo Mira tu tu problema es que tienes muy pocas variables entonces agarró la fecha por ejemplo y le la puso en en días mes año le metió si era fin de semana o no si era día de semana el si era el primer eh el primer cuatrimestre del año segundo cuatrimestre del año tercer cuat trimestres de año es decir le metió muchísima variable y y mejoró muchísimo muchísimo la la predicción del modelo entonces para mí lo con lo que me quedo es en esta clase que mientras más varibles pues mejor Justo a ver no siempre Cuanto más variable es mejor es decir es encontrar las variables adecuadas para lo para el resultado que tú esperas Es lo que he dicho puedo tener 200.