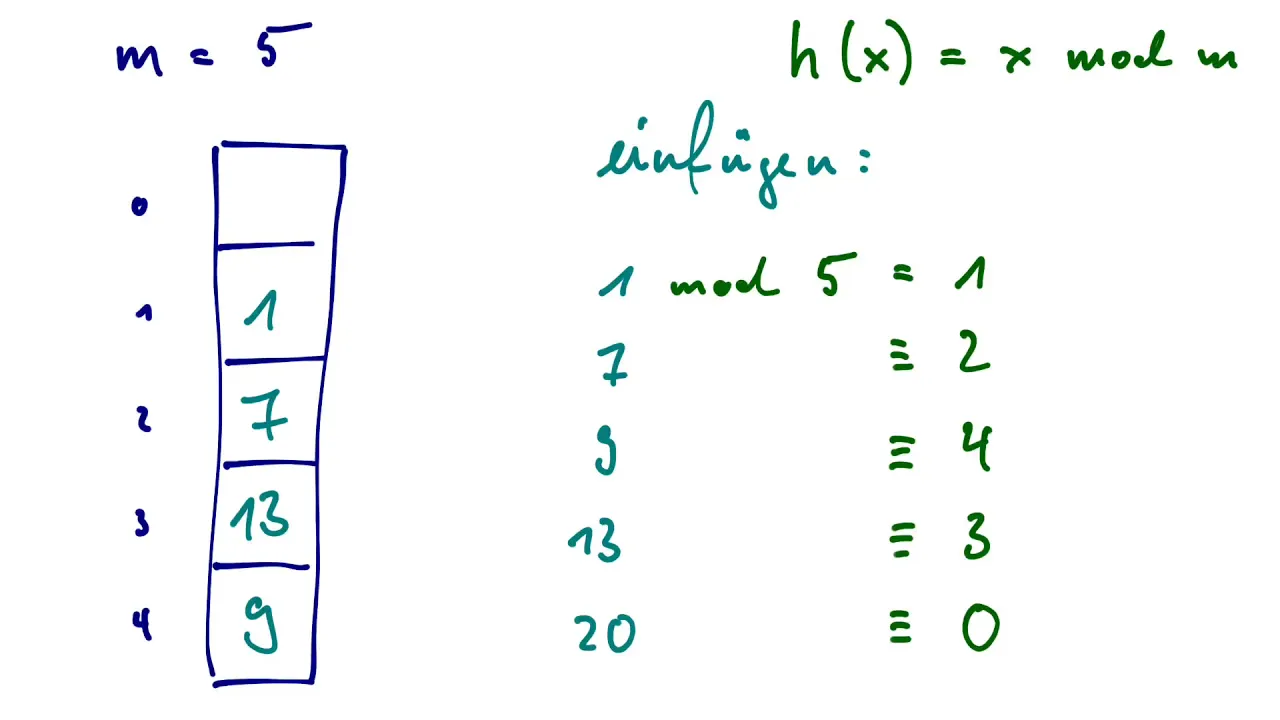wir haben das letzte video mit diesem beispiel beendet und wir wollen uns jetzt als nächstes ansehen wie wir es funktionen tatsächlich konstruieren können wir werden dabei nie das große ganze unsere datenstruktur aus den augen verlieren wenn man das verfahren verwenden um ihn daten zu suchen dann verwendet man es sehr sehr einfache datenstruktur das große vorteil alles was wir brauchen ist eine tabelle ein feldhase in java harry von objekten eines bestimmten typen und in dem speichern wir unsere daten und uns wird's gleich darum gehen eine funktion zu konstruieren die mir für jedes datum den index das
wo ich das im feld erwarten kann wo ich suchen kann bestimmt das wird unsere funktion sein noch kurz zur namensgebung die hash tabelle heißt im deutschen manchmal auch streit tabelle er ließ den begriff sehr selten ich würde immer beim englischen bleiben gleichzeitig gefällt mit der deutsche begriff von der interpretation hier eigentlich ganz gut zurecht auf englisch heißt etwas zu hacken das ist das was die hash funktion in gewisser art und weise mit dem schlüssel wert macht um den index zu bestimmen das ziel ist dass wir die einträge möglichst gut über die gesamte tabelle streuen oder
verstreut wir haben das ein beispiel mit den namen gesehen sodass eben alle tabellenplätze möglichst gleich wahrscheinlich erreicht werden dieser welt einträge die heißen manchmal auch bucket insbesondere für eine art der kollision behandlung das leveraging den begriff liest man auch häufig ich habe hier schon erwähnt hier wird noch mal darauf hinweisen wenn man dann so weit sind jetzt wird es uns erstmal darum gehen für jedes objekt mit hilfe der hash funktion den index oder die adresse zu berechnen an der wir dieses objekt suchen würden dabei können wir im allgemeinen davon ausgehen dass ein objekt ein paar
aus einem schlüssel und einen wert ist der schlüssel ist der teil den wir für die adressierung brauchen der schluss löst das was in die hash funktion reingeht so dass wir als ausgabe einen index bekommen wie muss eine hash funktion jetzt aussehen es gibt einige eigenschaften diese auf jeden fall erfüllen muss oder möglichst erfüllen soll die eigenschaft die die hash funktion erfüllen muss es sie muss konsistent sein mit der gleichheit redaktion das bedeutet wenn zwei beliebige schlüsse gleich sind dann müssen auch die indizes die ich durch die hash funktion die nicht hier habe rechne gleich sein
gleiche schlüssel bedeutet gleiche indizes bzw gleiche hash werte werden wir immer sagen die umkehrung die gilt im allgemeinen nicht weil wir damit rechnen müssen dass es sehr viel mehr schlüssel als gültige indizes gilt damit muss es auch schlüssel verschiedene schlüssel geben die auf den gleichen index abgebildet werden was erwarten wir noch von der hash funktion damit das ganze sich lohnt muss die hash funktion effizient berechenbar sein ich habe geschrieben in jedem fall in ufern 1 in konstanter zeit das bezieht sich darauf dass die berechnung der hash funktion oder die kosten dafür unabhängig sein sollen von
der anzahl einträge im feld wenn ich was anderes zähle für eine zeichenkette zum beispiel jeden buchstaben jedes zeichen für die berechnung mit einbezieht dann bin ich natürlich linear in der anzahl zeichen in der zeichenkette aber bezüglich der anzahl einträge in der tabelle bin ich immer noch konstant das ist wichtig wenn ich nicht wenn ich es nicht schafft die hash funktion effizient zu berechnen dann lohnt sich das ganze nicht außerdem soll die hash funktion die schlüssel möglichst gleichmäßig über die tabelle verteilen möglichst gleichmäßig verstreuen das bedeutet insbesondere auch dass wir wenn wir mehr schlüssel als tabellen
einträge hand tatsächlich auch die ganze tabelle ausnutzen wollen und das nicht irgendwo tabellen einträge gibt die nie getroffen werden also die hash funktion soll schon mal wenigstens subjektiv sein soll nicht sein dass bestimmte einträge überhaupt nicht verwendet werden gleichmäßig streuen bedeutet dass wir möglichst wenige kollisionen erwarten wollen das bedeutet dass wir die situation zwei unterschiedliche schlüssel bilden auf den gleichen index in der tabelle ab das wird die nach möglichkeit wenig häufig erleben oder dass wir erwarten dürfen dass das nicht passiert erwarten dürfen bedeutet wir können wie gesagt wenn wir alles richtig machen tatsächlich wahrscheinlichkeiten dafür
angeben dass so eine kollision auftritt beziehungsweise nicht auftritt noch eine kurze bemerkung die hash funktion soldaten möglichst gut streuen das sieht dann manchmal alles ein bisschen zufällig aus oder tatsächlich sieht so aus als ist alles was zufällig aussieht gut wichtig dabei ist das mag zwar zufällig aussehen aber die herzfunktion hat natürlich ein deterministisch essverhalten es ist ja kein zufall tatsächlich im spiel auch wenn es um ein möglichst breit verstreuen geht wie könnte es ohne hash funktion jetzt aussehen wir machen es uns erstmal einfach und sagen dass die schlüsse ganze zahlen sind damit würde die hash
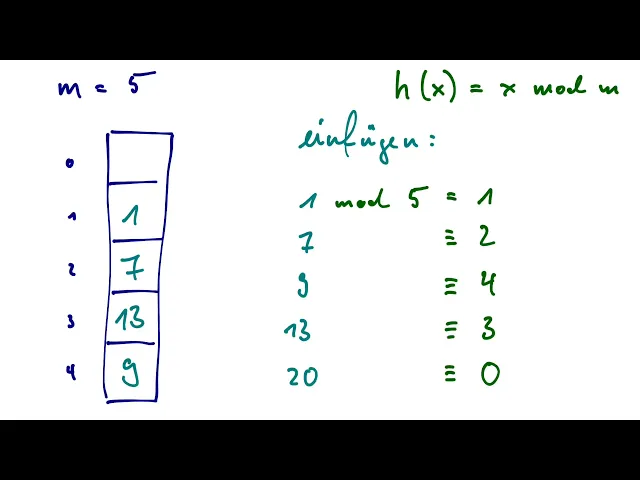
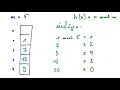
funktion haar vom ganzen zahlen auf natürliche zahlen auf eine menge von indizes also auch wieder zahlen abbilden stellen wir uns mal vor wir haben eine tabelle der größe 5 und wollen die zahlen 1 7 9 13 20 einfügen was könnte hier eine sinnvolle funktion sein die diese zahlen auf die indizes von 0 bis 4 abbildet eine wahl die wir schon kennen ist wir nehmen als cache funktion haar von ex die funktion hicks model m das heißt den rest aus der division von iks und emmaus der ganzseitigen division hier ist m gleich fünf das heißt 1
modul 5 bis 1 geteilt durch 50 rest 17 modul 5 gibt ein siebenmeter 5 gibt 1 rest 275 ist 29 geteilten 51 rest 413 geteilt durch 517 rest von 320 geteilte 5 geht glatt auf und wir haben den rest von 0 das heißt die 1 steht tatsächlich auch an der stelle einst die sieben steht an der stelle zwei die 9 am index- vier die 13 am index 3 und die 20 anfang an der stelle 0 ich habe die zahlen wir natürlich genau so gewählt dass es keine kollision gibt als das mal keine zwei zahlen einfügen
die auf den gleichen index abbilden hätte ich die sechs noch mit dazu genommen dann hätte ich model oder fünf natürlich auch den index 1 bekommen und dementsprechend hat man dann ein problem gehabt dieses problem wenn man uns nachher anschauen wenn es um kollision behandlung liegt hier auf der folie haben das gleiche beispiel noch mal also wir wollen ganze zahlen abbilden auf eine tabelle der größe m eine potenziell unendlich große menge auf eine endliche menge von indizes nämlich die zahlen von null bis minus 1 und wir machen das in dem wir die zahl modulo m nehmen
die tabelle hier unten ist die gleiche wie man sie gerade gesehen haben hier stehen die indizes und von links nach rechts habe ich die zeit also hier wird die einst eingefügt die sieben eingefügt die 9 die 13 die 20 eingefügt jeder eintrag die neu eingefügt wurde ist fett alle anderen einträge sind einfach normal was versehen ist nachdem fünf einträge in der tabelle der größe 5 einsortiert hat ist die tabelle voll das heißt wenn jetzt tatsächlich noch ein eintrag kommt spätestens dann muss es eine kollision geben spätestens dann müssen wir uns überlegen was wir machen das
ist unser programm für den rest der vorlesung wir wollen uns einmal anschauen welche eigenschaft sollten welche eigenschaften sollten die hash funktion haben beziehungsweise nicht haben wir werden dabei erst mal bei den ganzen zahlen bleiben dann wollen wir uns anschauen wie könnte ich den hash funktionen für beliebige typen definieren und wir werden bei zeichenketten bleiben hier geht es um die hash funktion danach wollen wir uns überlegen was passiert denn wenn mit kollision auftritt was können wir dann machen welche möglichkeiten haben wir kollisionen zu behandeln wir haben schon gesehen es wird zwangsläufig zu kollisionen kommen spätestens dann
wenn die tabelle voll ist also hier geht es um die koalitions behandlung beide zusammen liefern uns die hash tabelle mit deren hilfe ich zum beispiel abstrakten datentyp set oder den abstrakten datentyp map implementieren kann am schluss haben wir noch einen kurzen ausblick und werden sehen dass es auch noch andere anwendungen von resch tabellen oder von cash verfahren gibt nicht nur die suche in der menge von daten sondern auch einige andere allerdings braucht man dafür gegebenenfalls auch andere kassen von hess funktionen bzw noch andere überlegungen wir werden das kurz abreißen wir haben schon überlegt welche eigenschaften
ein hash funktion haben muss und möglichst haben sollte wenn wir uns die abbildung x-modelle von gerade eben anschauen dann gilt auf jeden fall dass diese abbildung konsistent ist mit der gleichheits relation gleiche schlüssel werden auf gleiche hash werte abgeliefert abgebildet also wenn nix gleich y ist dann ist ex model oem auch gleich lips i lon model ein außerdem kann ich diese abbildung effizient berechnen das geht tatsächlich in o von 1 ich muss nur die module operation auswerten die nächste frage ist ein bisschen komplizierter wie gut streuten diese funktion werte über meine tabelle und wir werden
uns eine einfache überlegen dazu anschauen denn offensichtlich ist es so dass wie gut haarsträubend türlich von den schlüsseln abhängt eine eingabe für h die kenne ich aber a priori nicht der einzigen parameter die ich noch habe das ist die größe meines feldes m und wenn uns überlegen das die güte der streuung tatsächlich auch von ihm abhängt appell abhängt das ist das einzige was ich hier tatsächlich wählen kann reicht eine vor überlegungen dazu man könnte jetzt versucht sein die tabellen größe einfach als eine zweier potenz zu wählen denn für eine zweier potenz ist es noch mal
einfacher und ja vielleicht auch ein tick effizienter den index zu berechnen weil ich die module operation im wesentlichen durch logisches und wir haben uns die mit operatoren in java nicht angeschaut es könnte an der stelle selber nachlesen dass es ein logisches und und einmal auf der rechten seite hier die maske die mit einer operation erzeugt wird diese operationen können auch schneller sein als tatsächlich model operation zu berechnen also man könnte versucht sein das zu machen und die frage ist ist das gut sollte man das machen und wir werden sehen dass es hier tatsächlich schlechtes dazu
betrachten wir tatsächlich mal die familie der funktionen haar von xx modellfamilie deshalb weil ich das hier tatsächlich noch als einen parameter den einzigen parameter für hh und wir wollen einfach die frage klären wie sollte man diese tabellen größe wählen bzw wie sollte man möglichst nicht wählen und warum dazu nehmen wir grad mal an dass wir den schlüssel den wir einfügen wollen kennen und das p der größte gemeinsame teiler von diesem schlüssel und der tabellen größe ist größter gemeinsamer tyler bedeutet p ist gleichzeitig gemeinsamer factor oder der größte gemeinsame faktor das wiederum bedeutet dass ich sowohl
den schlüssel als auch die tabellen größe m als ein produkt von p und im weiteren faktor hier xsp mal kuh und msp mal erst schreiben kann was man jetzt machen ist wir setzen einfach ein wir schauen uns an wie sieht denn hv mix tatsächlich außerhalb von xxx modulo m wir setzen jetzt die definition der module operation ein das heißt wir berechnen erstmal die ganzseitige division aus ickx und m oder ganzzahligen anteil dieses quotienten wenn man das wieder mit m multiplizieren und phoenix abziehen dann behalten wir den rest aus der division das kennt man aus dem
letzten jahr schon so jetzt setzt bei unsere faktoren ja das heißt xsp malki - und hier habe ich den ganztägigen anteil von quotienten six also wieder prq durch mlp mal und das ganze wieder mal im also mal pi mal r so an der stelle vorsicht ich darf hier das m nicht kürzen denn ich habe hier noch diese gaus klammern die mit den ganz eiligen anteil liefern allerdings darf ich innerhalb der gus klammern hier das kürzen gleichzeitig darf ich diesen gemeinsamen faktor p hier ausklammern ich mache das grad nur einfach so müssen hier weg streichen jetzt
immer auch schon fast fertig wenn ich nochmal ab schreibt steht hier p mal und jetzt in klammern - der ganzzahligen andrej kostin co ziehen muss und das ganze wieder mal herr oder p mal in klammer und wenn man jetzt hinschauen dann sehen wir dass das daher nichts anderes ist als model also können einfach wieder die definition der module operation einsetzen so ich habe gesagt jetzt sind wir fertig wo es jetzt hier das problem das problem ist dass diese funktion harfe mix jetzt offensichtlich nur über vielfache von p streut denn dieses p habe ich hier vorne
als ein faktor bedeutet wenn schlüssel ickx und tabellen größe m einen größten gemeinsamen factor haben dann streut meine hash funktion tatsächlich nur über diesen faktor p ob das so ist weiß ich nicht weil ich kenne ja meine schlüssel nicht ich weiß nicht wie die kommen aber ich muss damit mit allen möglichen schlüssel rechnen bzw oft ist es so dass ich ja tatsächlich nur bestimmte zahlen einsortieren oder dass ich weiß dass die zahlen die ich einsortiert bestimmte faktoren vielleicht häufig haben ein faktor 2 oder eben andere nicht haben und ich soll jetzt das hier an titi
zieren das heißt ich sollte versuchen diese streuung möglichst klein zu machen und wie kriege ich das hin das kriege ich hin indem ich dafür sorgt dass dieses möglichst einen wert von 1 hat so dass man über alle einträge streu noch nicht unbedingt gleichmäßig streuen aber wenigstens über alle einträge stunden wie kann ich das erzwingen wenn ich den schlüssel nicht kennen und das einzige was ich an meiner funktion ändern kann also meine familie von aesch funktionen hat diesen parameter m dann muss ich m so wählen dass der größte gemeinsame teiler von beliebigen ickx und m gleich
eins ist und das erreiche ich indem ich ihn als eine primzahl wählen wenn ich das mache dann vermeide ich eine streuung über vielfache so hier haben wir die rechnung noch mal und die bemerkungen wir streuen tatsächlich nur über vielfache von p bzw die lösung hier zwinge gleich 1 durch eine wahl von m als primzahl das ganze ist in gewisser weise eine reine vorsichtsmaßnahme da ich die schlüssel nicht kenne aber gleich in der praxis mit gemeinsamen faktoren das gilt gerade für zweier potenzen rechnen muss und genau deswegen ist dieses beispiel mit ich wähle die tabellen größe
als die zweier potenz in der praxis oft entschuldigung in der praxis oft problematisch es ist keine große einschränkung die wir hier an die tabellen größer als eine primzahl zu berechnen wenn jetzt annehmen oder muss ich primzahlen rechnen tatsächlich ist es so dass implementierungen von resch tabellen tabellen von primzahlen mitführen und dann immer für eine gegebene tabellen größe die nächstgrößere primzahl in dieser tabelle wählen also ich muss da tatsächlich nichts berechnen sondern ich kann mir einfach eine kleine menge von sinnvollen primzahlen vor berechnen und verwenden warum muss es eine kleine menge nur sein weil ich dafür
sorgt dass diese primzahlen exponentiell steigen das heißt die krieg unter umständen nicht beliebige tabellen größen sondern ich sorg wieder dafür dass wenn ich größere tabellen haben möchte dass die tabellen größe ähnlich wie bei unserem vector exponentiell wächst hesch tabellen sind sehr einfache datenstrukturen tatsächlich ist es so ihr werdet wahrscheinlich selten in die verlegenheit kommen eine verkettete liste als eine allgemeine datenstruktur nochmal zu implementieren wahrscheinlich werdet ihr auch den rot-schwarz baum eher selten selbst implementieren die wahrscheinlichkeit dass ihre häscher berlin mal selber implementieren müsst die ist tatsächlich hoch weil das ganze so einfach ist gebe ich
jetzt waren beispiel aber noch wichtiger ein kleines framework zum experimentieren mit cash tabellen bzw mit esch funktionen das cash table example ist ein programm wo man verschiedene funktionen verwenden kann und parametrisieren kann also verschiedene parameter noch angeben kann verschiedene arten der kollision behandlung auch durchspielen kann dazu komme im nächsten teil aber wichtig dass wir die ausnutzung auslastung der tabelle über die zeit visualisieren können und damit visualisieren können wie gut das ganze streut das sieht für ein schlechtes beispiel dann zum beispiel so aus ich hab hier tabellen größe von 18 das ist keine primzahl 18 ist
zweimal dreimal 31 ich habe ausgerechnet paar kleine primfaktoren kleine primfaktoren dass er wahrscheinlich dass den entschluss und dann auch vorkommen ich habe die schlüssel natürlich auch grad so gewählt dass es nicht so akut wird wir fügen 268 9 12 16 33 54 24 1 alle sind durch zwei und durch drei teilbar damit haben wir jeweils entsprechend gemeinsame faktoren und wir sehen dass das ganze wenig gut streut weil es hier bereiche der tabelle gibt die schlecht ausgelastet sind die einfach nicht getroffen werden wie ist das zu lesen genau wie gerade eben auf dem beispiel auf der
folie wir haben hier die indizes von 0 bis 17 und wir haben hier die zeit am anfang ist die tabelle leer dann füge ich die 2 1 danach füge ich die 6 1 dann füge ich die 8 1 für alle es ist gerade so das model 18 habe ich genau den entsprechenden tabellen index und so weiter und so fort irgendwann ändert sich gegebenenfalls die farbe und die farbänderungen die kennzeichnen kollisionen also hier habe ich das erste mal was eingefügt was einen eintrag trifft der vorher schon drinnen war in dem fall ist dass für die 24
passiert weil 24 modul 18 hier ist wieder sechs und die sechs hatten schon eingefügt wir wollen uns als nächstes überlegen wie wir hash funktionen für beliebige datentypen konstruieren können gemacht dass sie einfach so dass wir eine zusätzliche abbildung von einem beliebigen datentypen auf die ganzen zahlen konstruieren also würde von k auf die ganzen zahlen abbilden und diese zahl die wir euch dann bekommen die bild mit hilfe von harvey was gerade eben hatten auf unseren index eine konstruktion die hier immer funktioniert ist ich interpretiere meine daten also fast immer der schlüssel ist als eine ganze zahl
zum beispiel indem ich sagt letztendlich muss ich den schlüssel als eine anzahl eine folge von biz oder von mir aus auch als eine folge von byd darstellen und die definieren wir auch eine zahlen damit bin ich im prinzip schon fertig schauen wir uns als beispiel zeichenketten an und nehme an anders als es in java tatsächlich ist das eine zeichenkette als eine folge von byd gespeichert wird dann interpretiere ich diese folge von byd einfach als eine zahl und ich sage mir jedes einzelne weit definiert eine ziffer allerdings nicht im zehner system sondern im zwei hoch achter
system jedes byte besteht aus 8 bit dann kann ich diese funktion f so definieren indem ich einfach über jede ziffer mal zwei hoch acht hoch die stelle der ziffer berechnen und das mache ich für alle zeichen in einer zeichenkette vorsicht ganz so einfach ist es aber nicht weil in java ist dass bald eine vorzeichen behaftete größe also ich kann tatsächlich im positiven nur bis zwei hoch 7 -1 gehen ich habe noch das vorzeichen bit mit dabei all diese implementierungs details die blind machen der stelle gradmann raus wir merken uns nur in japan müssen ein bisschen
vorsichtiger sein oder generell müssen wir mit vorzeichen gegebenenfalls vorsichtig sein was wir hier tatsächlich machen es wir berechneten wert eines problems mit 2 8 als basis und den zeichen in einer zeichenkette als koeffizienten wenn man das in java berechnen und als typ den unternehmen dann haben wir allerdings das problem dass wir im positiven nur bis zwei hoch 31 - 1 gehen können das heißt spätestens nach dem vierten zeichen müssen wir mit einem überlauf rechnen und damit kann es passieren dass gar nicht mehr alle zeichen mit eingehen in den wert den ich berechne sondern tatsächlich nur
die ersten vier kommt noch ein bisschen darauf an auf die details wie diese überlauf aussieht in manchen sprachen wie c c++ ist es tatsächlich ein definiertes verhalten das heißt wir dürfen das gar nicht auch wenn es keiner daran hindert in jedem fall ist etwas was man nicht wollen weil das nicht so richtig handhaben können und gleichzeitig das wissen wir noch aus unserem eingangs beispiel reicht nicht sich auf wenige zeichen zu beschränken im eingangs beispiel hat man von den nachnamen tatsächlich nur das erste zeichen im ersten buchstaben genommen jetzt immer die ersten vier das macht es
zwar besser aber eben noch nicht gut das ist ganz wichtig eine hash funktion muss um gut streuen zu können tatsächlich informationen aus dem gesamten schlüssel nehmen eben nicht nur aus dem ersten vier zeichen wir dürfen uns hier nicht beschränken durch den überlauf oder möglichen überlauf kann das aber passieren wie können wir das reparieren wenn die funktion f hier tatsächlich ein poly nom auswertet also jedes zeichen xi entspricht einer ziffer in zwei achter also 2 256 das system dann können wir uns überlegen wie wir den sohn polynorm auswerten können bzw das alternativ auswerten können und das
wissen wir schon ich kann probleme so auswerten wie das gerade gemacht in der summe schreibweise also die xr wie hier durch mz ersetzt z 0 bloss z1 mal bsz 1 x b quadrat und so weiter und so fort bis zkb zur höchsten potenzial das ist der grad des problems ich kann dieses problem aber auch alternativ im horner china auswerten horner china bedeutet dass ich hier geschickt faktor ist so dass ich die basis hier jeweils immer wieder an den nächsten termin mit dran multiplizieren wenn ich aus multipliziere komme ich tatsächlich auf das gleiche problem man kann
sich überlegen hier steht b x zkb noch ein bmw noch ein b tatsächlich sind viele bis die ich insgesamt zählen und damit bin ich auch wieder bei einem bhkw gehe davon aus ihr seid mit dem porno china schon in berührung gekommen wir haben es im letzten jahr auch als ein übungs beispiel verwendet ihr kind aus der mathematik warum nutzt uns das ganze hier das horner schema liefert uns eine andere berechnung vorschrift für dieses polymun dass sie unten einmal im pseudo pooth hingeschrieben der pseudo boot ist ein kleines bisschen verwirrend deshalb weil ich tatsächlich das ganze
als eine zahl ansehe und die ziffern so wie wir das tun die von den einern über die zehner zu hunderten im dezimalsystem und die ziffern von rechts nach links lesen also die am wenigsten sie finden die signifikante ziffer ganz rechts deswegen läuft diese schleife auch in umgekehrter richtung im wesentlichen ist das aber die berichten zum thema genauso wie sich hier oben auch steht genauso wie man es im winter auch eine übungsaufgabe schon mal gemacht so eine sache die ist ein pseudo brot hier schon drin die fehlt jetzt hier was ich berechnen möchte ist ja am
ende der wert von fx j&m das ist das was uns die funktion h noch macht und was ich jetzt machen darf wenn m eine primzahl ist ich darf dieses wort m hier mit rein in die summe ziehen beziehungsweise für das horn china bedeutet dass ich darf nach jedem term den hieraus rechne model rechnen das gilt dann wenn eine primzahl ist also haben wir gleich noch einen grund für m eine primzahl zu verwenden denn auf die art und weise kann ich nach jeder teil rechnung die module rechnung machen das wiederum bedeutet dass ich den überlauf effektiv
vermeiden kann wenn man uns für diese abbildung auch noch mal überlegen ob die gutes dann sehen sie ist offensichtlich konsistent mit der gleichheits relation für gleiche schlüssel bekomme ich auch gleiche hash werte gleiche zeichen sind gleiche probleme damit bekomme ich auch den gleichen wert wenn ich aus werte ich kann die hash funktion effizient berechnen ich schaffe das in von grad des problems oder wovon anzahl der zeichen in einer zeichenkette das ist aber unabhängig von der anzahl schlüssel in meiner tabelle in dem sinn also konstant und gleichzeitig thema dass diese funktion tatsächlich relativ gut streut wenn
m eine primzahl ist das wiederum könnte mit dem thema auch einfach mal ausprobieren statt einer festen basis b könnte man hier auch verschiedene primzahlen abwechseln also man kann an der stelle mit verschiedenen abbildungen spielen wichtig ist dass wir den überlauf tatsächlich verhindern so dass man an jeder stelle sicher sind dass wir wissen was tatsächlich berechnet wird und dass keine information verloren geht der nächste punkt ist für die praktische implementierung wichtig tatsächlich kenne ich die tabellen größe m in der regel nicht zumindest dann nicht wenn ich mir gedanken mache eine hash funktion zu implementieren warum ist
das so ich möchte gegebenenfalls tabellen mit ganz unterschiedlichen größen haben habe ich möchte für jede tabellen größe wieder einen hash funktion implementieren können sondern die hash funktion möchte ich implementieren für einen bestimmten datentyp dass das wichtig ist sie immer allein schon aus der tatsache dass das java object eine methode hash code zur verfügung stellt die wir über schreiben können um hash werte zu berechnen für beliebige objekt also auch hier die hash funktion wird definiert mit dem datentyp oder mit dem schlüssel unabhängig von der konkreten tabelle in die ich einsortieren möchte was man deshalb macht man
konstruiert die hash funktion so dass sie auf einen möglichst großen wert bereich abbildet also möglichst den ganzen wertebereich der integer also so groß wie die größte tabelle die ich mir nur praktisch vorstellen kann sein kann und das erreicht man indem wir nicht modeln konkrete tabellen größe arbeiten sondern indem wir module ok arbeiten und geh wählen wir einfach als eine große primzahl als beispiel wenn wir auf integer abbilden als die größte primzahl gerade noch kleiner ist als der positive werte bereich der im ticker auf die art und weise bekommen immer einen gültigen hash wert aber noch
keinen tabellen index um den schließlich zu berechnen berechnen wir dann noch mal also tatsächlich würden wir zwei module operationen machen einmal model op das ist eingebaut in der hash funktion und dann noch motto lohan wenn man eine konkret tabelle von einer gegebenen größe einsortieren oder in dieser tabelle zu was man sich angeschaut haben ist eine möglichkeit wie man eine hash funktion konstruiert es gibt andere möglichkeiten die möglichkeit hier ist nicht schlecht und gleichzeitig ist sie relativ einfach aber es gibt immer wieder kleinere problemchen bzw stolpersteine auf die immer gut aufpassen müssen zb den überlauf oder
auch die tatsache ob wir bestimmte daten oder datentypen tatsächlich bit weise implementieren im interpretieren dürfen oder ob monster gegebenenfalls noch ein paar mehr gedanken machen müssen trotzdem ist die grundidee ganz oft wenn ich nicht weiß wie ich ihn datentyp einen hash wert umwandelt dann interpretieren einfach als eine folge von biz oder bikes also als eine ganze zahl und berechnet daraus einen hash wert genauso wie das gerade eben mit dem zeichenketten gemacht wenn ich in java tatsächlich hash werte von objekten berechne dann kann ich mir natürlich einfacher machen ich muss nicht für jeden objekttyp für jede
klasse eine ganz neue hash funktion definieren sondern was ich stattdessen macht ist ich berechne die hash werte für die attribute der klasse denn was in die hash funktion eingehen soll ist ja der zustand des objekts also alle attribute die den entsprechenden schlüssel definieren und was ich jederzeit machen kann es verschiedene funktionen kombinieren indem ich für das erste attributen hash funktion berechnet für das nächste attributen hash funktion berechne und diese beiden hash werte dann zum beispiel einfach aufsummiert und wieder modul op nehmen oder wenn man in java die mit operationen nehmen so was wie ein bit
weise exklusives oder mache und dann auch wieder gegebenenfalls die model operation an wände wie gesagt auch hier mit vorzeichen müssen ein kleines bisschen aufpassen also ich kann gerade bei objekten oder bei erschwerten von objekten hash werte der einzelnen attribute berechnen und die wiederum miteinander verknüpfen und auf die art und weise kann ich mir auch sie einfach cash funktionen konstruieren tatsächlich ist es so für alle primitiven datentypen habe ich in java vernünftiges funktionen die ich auch verwenden kann gleiches gilt die zeichenketten ansonsten müssen wir uns immer darüber klar im klaren sein dass die vor das vordefinierte
verhalten der methode hash code definiert in java lang object nicht unbedingt das verhalten ist dass wir haben wollen oder nicht unbedingt eine hilfsfunktion bezeichnet die besonders gut streut gleichzeitig wenn man bei cover und implementierung bleiben muss man auch immer im hinterkopf behalten die hash funktion soll konsistent sein zugleich heitz relation das bedeutet in java wenn ich gut implementiert dann muss ich auch die equals methode definieren also dass eine definiert mir die hash funktion das andere definiert mir auf den test auf gleichheit und beide müssen konsistent miteinander sein ich will dieses kapitel zur cash verfahren abschließen
mit einer kurzen bemerkung es gibt sogenannte universelle hash funktionen wer will kann das schul nachlesen einmal im goodrich unter masia oder auch im kommen universelle hash funktionen sind familien von resch funktionen die mir garantien geben und zwar garantien dass kollisionen nur mit einer bestimmten wahrscheinlichkeit auftreten können diese familie von mensch funktionen sind immer noch relativ einfache funktionen wenn ich mir anschaue familie deshalb weil ich einige parameter habe hier sind das zahlen a b und p wobei eine primzahl sein soll er sehr große primzahl sein soll größer als sehr viel größer als tabellen größe und a
und b jeweils zwischen 0 einmal ausschließlich einmal einschließlich und kollegen ist wenn ihr euch das dort in der literatur durchliest dann werden tageweise angegeben dass für diese wahl von parametern also für diese familie von resch funktionen tatsächlich garantien geben können dass die wahrscheinlichkeit einer provision kleiner gleich 1 durch die anzahl einträge in der tabelle ist dass er als eine möglichkeit so eine universelle hash funktion zu konstruieren es gibt noch andere wir wollen hier nicht weiter drauf eingehen sondern schauen uns im nächsten video an wie man mit kollisionen umgehen kann wenn sie denn tatsächlich auftreten und
egal welche garantie ich habe egal wie niedrig die wahrscheinlichkeit ist wir müssen immer mit kollisionen rechnen es wird in der praxis immer welche geben