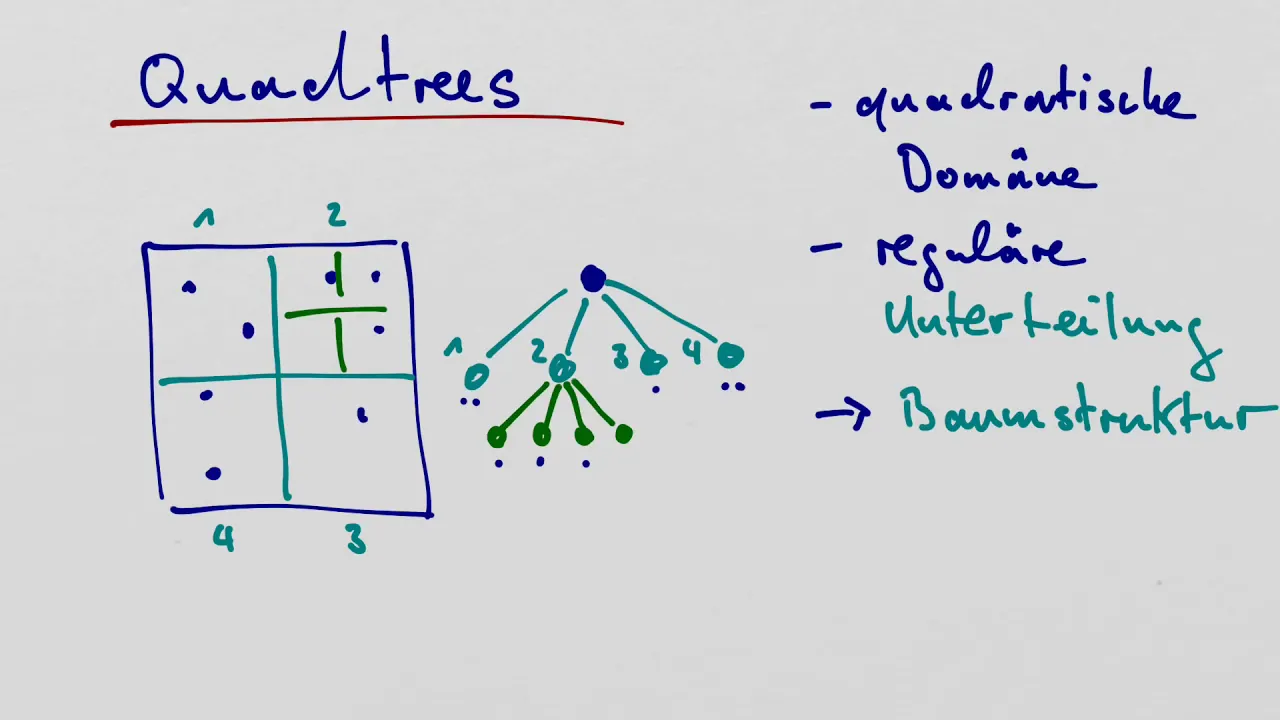
ich möchte am ende gerne noch mal eine andere art von such bäumen kurz vorstellen uns ging es bisher immer darum abstrakte datentypen set oder maps implementieren als wir wollen wissen ob ein eintrag in eine menge von einträgen drinnen ist oder nicht tatsächlich gibt es noch andere anwendungen zum beispiel in der computergrafik aber auch im maschinen learning wo es darum geht nachbarschaft informationen abzufragen das heißt gegeben eine menge von punkten nehmen die blauen punkte hier ich gebe einen anderen punkt in der ebene vor den roten und möchte jetzt wissen welche von den blauen punkten ist denn
der nächste nachbar also hat den geringsten abstand zu diesem roten punkt und auch diese abfrage möchte ich natürlich effizient durchführen es gibt noch viele varianten ich kann nicht nur einen nächsten nachbarn sondern k nächsten nachbarn erfragen ich könnte um diesen roten punkt ihren den kreis schlagen und fragen welche der blauen punkte sind dann in den kreis oder mir andere arten von bereich suchen ausdenken alles das kann ich auch wieder mit bestimmten baumstrukturen beschleunigen möglichkeiten dafür sind quad dreams kd bäume oder bsp bäume und die wollen wir uns ganz kurz noch anschauen ohne dass ich auf
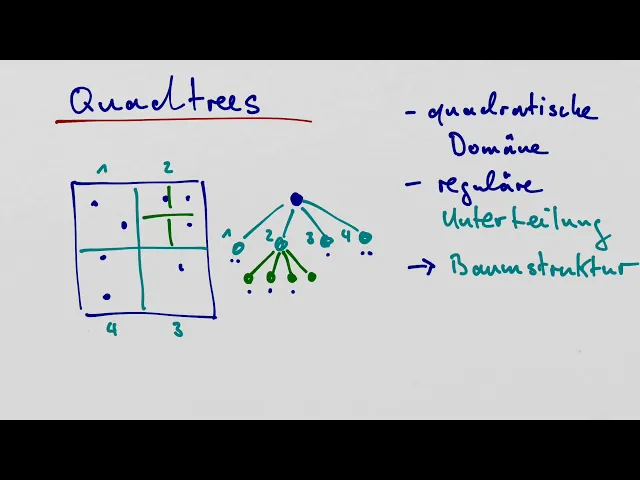
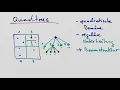
die algorithmen dazu eingehen werde ich werde nur ganz kurz darauf eingehen wie die bäume definiert sind wo er wie man sich die bäume vorstellen kann fangen wir mit quad fries an klopp wie es der name kommt von dem wort hier in der regel ein quadrat in der ebene dass mir meine domäne begrenzt also dass wir den teil der ebene begrenzt in dem ich meine daten punkte liegen hat das bedeutet gleichzeitig auch flops sind für 2d daten gemacht analog dazu funktionieren die sogenannte knock trees für 3d dar rogers unterteilen mir die ebene regulär in dem ich
immer wieder den mittelpunkt meines quads einfüge und dann weiter massiv unter teile also wieder mittelpunkt einfüge dabei entstehen jeweils vier neue quads und ich unterteile jeweils so lange bis ich in einer zelle nur noch eine maximal anzahl von punkten liegen habe ich habe hier unterteilt bis ich in jeder zeile höchstens noch zwei punkte liegen habe wenn man das macht dann liefert uns diese unterteilung eine baumstruktur der wurzel knoten steht für die gesamte domäne für das ursprüngliche quad jeder innere knoten im quad wie hat vier kinder denn jede unterteilung teilt in vier supports ich hab die
hier nummeriert 1234 also einmal so rum die nummerierung ist willkürlich ich muss nur einmal festlegen nach der unterteilung habe ich entsprechend einen knoten hier hier und hier und er steht für die zelle die zelle die zelle und für diese so die zelle nummer 1 nur drei und nummer vier die werden jeweils nicht mehr unterteilt da speichere ich meine punkte noch mit die da drin liegen die zelle nummer drei habe ich noch nur zwei habe ich nochmal unterteilen müssen weil da liegen drei punkte trennen und meine regel war dass ich höchstens zwei punkte pro zelle habe
ansonsten unter theidig wieder auch hier diese schranke wie weiter ab wann ich unterteil oder bis wann ich unterteile das ist auch wieder ein parameter an den baum also ich habe mich nochmal unterteilt dann auch wieder vier zellen und von diesen 43 jeweils einen punkt und eine ist leer geblieben da wo die unterteilung in cottbus sehr regulär ist wird das bei den sogenannten car den bäumen bisschen locker da die bäume sind guineer bäume das heißt ich unterteile immer in zwei teilen und die ids ich schaue mir wieder einen teil in dem fall meiner ebene an kde
bäume können aber punkte in beliebigen dimensionen beschreiben ich möchte es zeichnen können deswegen in der ebene ich bin hier nicht eine quadratische domäne gebunden sondern die kann irgendwie rechteckig sein das heißt die abmessung in jeder dimension müssen nicht gleich sein und die idee ist ich habe jetzt vier punkte in diesem blauen rechteck liegen ich versuche dieses rechteck entlang eine dimension zu teilen und zwar so dass ich in der einen und in der anderen hälfte gleich viele punkte zulegen hab das heißt da wo ich beim kd baum immer strikt den mittelpunkt eingefügt habe habe ich hier
den freiheitsgrad wo entlang dieser dimension theilig denn und diesen freiheitsgrad kann ich verwenden um den baum zu balancieren tatsächlich habe ich zwei freiheitsgrade in jedem schritt ich kann einmal die dimension wählen und ich kann einmal wählen wo ich diese dimension teil auf die art und weise der wurzel knoten steht wieder für das gesamte dunkelblaue rechteck bekomme ich jetzt zwei teile einmal dieses recht erhoben und einmal dieses rechte hier unten als linken und rechten knie und das spiel kommen jetzt weiter fortsetzen wir teilen oben auch wieder so dass ich links zwei rechts zwei knoten habe ich
habe diesmal entlang der anderen dimension geteilt gerade eben habe ich so geteilt die vertikale dimension geteilt durch den horizontalen strich und jetzt mache ich es genau andersrum ich teile horizontal durch den vertikalen grünen strich und bekommen jetzt wieder zwei knoten in dem fall unter teile ich nicht weiter dort speicher richtige speichere ich jeweils die beiden punkt und in der anderen hälfte unterteil ich auch nochmal hier unterteil ich noch mal in der gleichen dimension wie ich vorher unterteilt habe macht das genauso wieder dass ich jeweils oben und unten bzw im baum immer links und rechts die
gleiche anzahl punkte ab also ich kann die freiheitsgrade hier verwenden um den baum zu balancieren allerdings im unterschied zu den such bäumen wie wir sie kennen mache ich das nicht pro einfüge operation wie im rot-schwarzen oder vl baum sondern zu und kd baum wird üblicherweise einmal aufgebaut das heißt ich habe alle punkte vorliegen und schmeißt die in den ktv rein wenn ich danach noch punkte einfügt habe ich keine möglichkeit zumindest keine einfache möglichkeit mehr effizient auszubalancieren bsp bäume bsp steht für beinahe space praktisch und die lassen jetzt nochmal den freiheitsgrad zu die idee ist im
wesentlichen ähnlich wie für die kd bäume sind auch binär bäume aber ich unterteile jetzt nicht mehr in jeder dimension so streng nach einer achsen richtung horizontal oder vertikal sondern ich lasse jetzt beliebige ebenen oder über ebenen in der ebene geraden zu die mir meine punkt mengen einteilen so dass punkte im einen oder im anderen halb der ebene liegt also jede ebene oder jeder gerade hat einmal eine lage aber auch einen normalen vector denn er sagt das ist die eine seite ich sage die linke und das ist die andere seite die rechte seite der hebel links
rechts ist hier völlig willkürlich ich muss die beiden seiten unterteilen gehalt noch unterscheiden können welche warum habe ich hier mehr freiheitsgrade weil ich die ebene hier frei wählen kann das spiel von mir jetzt wieder weiter treiben und jeden halb raum regressiv wieder weiter unterteilt und auf die art und weise bekomme ich eine unterteilung die sehr viel unregelmäßiger sein kann die sich dafür aber besser an die daten adaptieren kann als beim kdd bsp bäume habt ihr vielleicht schon mal gehört die werden gerne in computerspielen verwendet um sichtbarkeit berechnungen zu beschleunigen die waren einmal vor berechnet für
eine große szene und dann verwendet um dafür zu sorgen dass viele berechnungen effizienter laufen können damit sind wir auch schon bei anwendungen für diese sowohl profis als auch kd bäume als auch bsp bäume beschleunigung von sichtbarkeit berechnungen in spielen habe ich gerade gesagt aber zum beispiel auch beim raytracing also bei der synthese von bildern der andere anwendung ist daten interpolation aus eine menge von punkten dabei ist es oft so dass man das mir nicht die gesamte das mich nicht die gesamte menge von punkten interessiert sondern immer nur wenn ich in der nähe von einem bestimmten
punkt meine funktion interpolieren möchte dann möchte ich natürlich dass auch nur datenpunkte in der nähe dieses punktes in den interpellanten eingehen ein beispiel für solche daten solches daten interpolation schema ist die sogenannte living leask wär's methode es gibt noch viele mehr eine andere anwendung die zb in maschinen drinnen viel verwendet wird das clustering zum beispiel mit hilfe von cummins mechanismus wo ich auch sehr oft nächste nachbarn mir verschaffen muss und das natürlich auch nicht durch eine brut force suche machen möchte also ich möchte nicht alle datenpunkte anfassen sondern ich möchte diese nachbarschaft natürlich auch möglichst
die logarithmische zeit und das kann ich jeweils mit diesen verschiedenen bäumen erreichen in dem fall würde ich wahrscheinlich den kadi baum verwenden wollen walt auf die weise noch einmal den bogen schlagen von den algorithmen und datenstrukturen zu anderen vorlesungen wie zum beispiel der computergrafik vorlesungen aber auch vorlesungen im maschinen löning viele von den ideen die wir versucht bäume brauchen tauchen hier ähnlich aus auf andere wiederum wie jetzt das spezielle balancieren bei rot-schwarz bäume brauchen hier nicht aber die ja das was wir tatsächlich erreichen wollen eine effiziente suche ist hier wie da gleich also unser ziel
ist jeweils das gleiche und auch die idee oder die vorstellung von balance ist die gleiche auch die implementierung ist jeweils ähnlich es sind bäume die wir hier implementieren müssen und da wo man die rot schwarz bäume zum beispiel als stream app in java oder als std set in c++ schon implementiert haben und das wahrscheinlich ihr nicht noch mal selber machen würden hier ist es so dass hier später ihr spezieller die anwendung und diese anderen sinn eben nicht mehr ganz so häufig wie in der menge von daten einfach mal suchen je spezieller die anwendung desto wahrscheinlicher
wird dass ihr selber implementieren muss und so was wie ein quad kann sie einfache datenstruktur sein oder umständen lohnt sich nicht eine vorgefertigte implementierung zu verwenden unter umständen hat die auch keine vorgefertigte implementierung die alle eure wünsche gut erfüllt das heißt für solche anwendungen ist es tatsächlich oft so dass ihr gezwungen zeit diese baum datenstrukturen auch noch mal selbst zu implementieren