Hoje a aula é sobre intervalos de confiança o objetivo é estimar uma incerteza da nossa estatística computa uma estatística de interesse por exemplo x Barra né e a gente quer saber qual que é a incerteza associada a essa estatística e a gente quer também fazer alguma relação de intervalos entre essa estatística e o nosso Mi né então a gente quer saber o intervalo de valores que cobrem a média populacional mi com uma certa probabilidade Então vou começar com uns exemplos bem intuitivos né ah a temperatura de amanhã estará entre menos 100° e mais 100º com certeza a temperatura vai est nesse intervalo Mas isso não dá muita informação né um intervalo muito largo pode ser muito quente ou muito frio Definitivamente não é uma coisa informativa pra gente não dá para tomar nenhuma decisão com base nisso por outro lado se fizesse uma estimativa numa precisão lá sei lá qual caso decimal né então é improvável o intervalo eh vai cobrir a verdadeira temperatura máxima do do dia né mas se for correto é altamente informativo mas é improvável que isso cobra a temperatura real tá e o objetivo é gerar um intervalo de confiança que faa sentido usando esse conhecimento que a gente teve nas aulas anteriores sobre distribuições de médias amostrais o primeiro ponto que a gente vai usar das aulas anteriores É aquela ideia de estimadores não invad a média x Barra é um estimador não invado do mi populacional assim como a variância da amostra S quadado né então dividido pelo n -1 estima eh de forma não invada a variância populacional tá então esse aqui é um primeiro elemento que a gente vai usar um outro elemento que a gente vai usar é o que a gente viu na aula passada né do teorema central do limite que se você tivesse uma amostra com n grande o suficiente a distribuição das suas médias amostrais vai seguir uma função densidade de probabilidade que é centrada No Mi e seguindo uma distribuição normal e com o desvio padrão sigmax bar dado pelo Sigma da população original dividido pelo raiz do n Esses são os dois aspectos da aula dois e da aula três que a gente vai usar para conseguir definir nso nossos intervalos de confiança vamos fazer isso com base num outro exemplo para entender entender como que o o intervalo de confiança é computado o exemplo que a gente vai ver é sobre notas do ENEM a o fbc informa uma repórter que o desvio padrão das notas dos alunos aprovadas no fbc O desvio padrão é 100 mas se recusa a informar qual que é a média das notas Ou seja a gente sabe o Sigma e a gente não sabe o m gostaria de estimar esse M E essa repórter ela decide investigar esse assunto ela faz uma amostra bem aleatória né então invés de ficar perguntando pras pessoas na frente da sala o que ela fez foi pegar todos os números de telefone ela teve acesso a todos os números de telefone ela ligou para cada um desses elementos da amostra sorteados 100 alunos sorteados Aí ela perguntou para cada um deles qual que era a nota ela conseguiu um X bar 705 a média obtida foi 705 e o que ela queria fazer é colocar o intervalo de confiança para essa média dessas notas e ela gostaria de falar a gente estima que seja 75 mais ou menos alguma coisa esse intervalo de confiança tá então esse é o nosso exemplo e aqui é o que que a gente já conhece né então a gente já sabe que a nossa média x Barra veio de uma distribuição que tem essa função daidade de probabilidade e o que que a gente precisa para sistematizar esses dados primeiro o Sigma e o n né então com isso a gente consegue definir qual que é o desvio padrão das médias né então o desvio padrão dessa função desidade de probabilidades de onde esse x Barra veio ela consegue computar então que o erro padrão Ou desvio padrão da Média que é a mesma coisa né é 10 então é uma distribuição que ela é centrada num mi que eu não sei quanto que é mas é uma distribuição normal com desvio padrão 10 desvio padrão da média é 10 então tem esses valores aqui o mi - 10 mi - 20 Men 30 mi + 10 mi + 20 mi + 30 e essa é a distribuição que se espera para gerar os X Barras Então qual que é a chance dessa média amral ter caído nesse intervalo de mi - 10 até mi + 10 isso aqui é relembrar o que a gente viu na aula passada aquela leitura de tabela que enorme P enorme né mas é que eu vou sistematizar aqui nessa figurinha que é mais fácil né então é entre menos um desvio padrão e mais um desvio padrão tem 34 com34 então aproximadamente 68 por de chance tá então tem 68 de chance que esse x Barra tenha vindo desse intervalo e nesse intervalo aqui que vai então de mais ou menos dois desvios padrão né então é 13 com 34 dá o dá um 47 47 do outro lado dá mais ou menos os 95% rodar no R Qual que é o um que enorme de 2,5 ou de 97 7,5 você vai ver que cai mais perto do 1. 96 né então 1. 96 que é para conseguir os 95% beleza mas então esse aqui vai ser o intervalo de confiança que aquela repórter vai fazer vamos supor que ela queira usar o intervalo de confiança dado por essa fórmula aqui então x bar mais ou menos o Sigma ra n ela colocou o intervalo de confiança dela centrado no 705 que foi esse x Barra que ela computou e ela colocou um desvio padrão da média para cima e um desvio padrão da média para baixo então 705 + 10 dá 715 705 - 10 dá 695 tá então esse aqui é o intervalo de confiança que ela produziu que esse intervalo de confiança 65% esse aqui foi o experimento que foi efetivamente feito agora vamos fazer uma simulação aqui para entender o que que quer dizer esse 68 por.
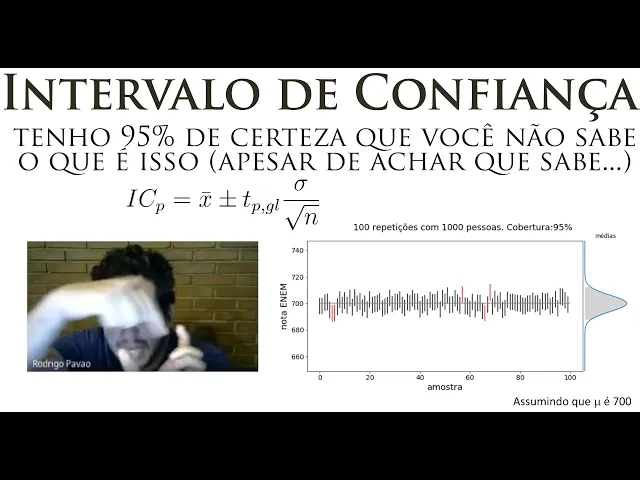
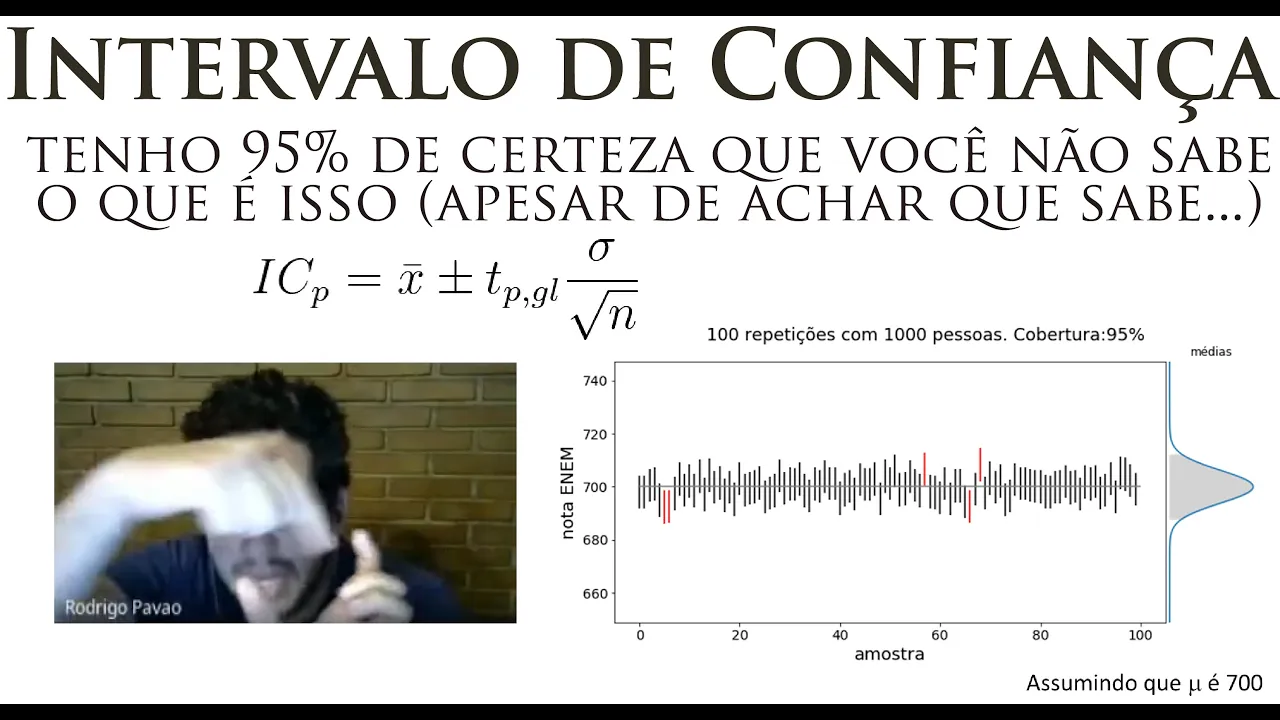
vamos assumir que o nosso mi é 700 tá então seriam feitas e sem repetições com o mesmo tamanho de amostra para cada amostra de 100 pessoas foi obtido um x Barra diferente e foi centrado o intervalo de confiança com um desvio padrão da média para cima e um desvio padrão da média para baixo e o que você observa que a a nossa média mi ela é coberta por apenas 68 dos intervalos de confiança Então os que estão em preto aqui os que estão em vermelho não cobrem o nosso Mi tá esse é o sentido do intervalo de gente já sabe da tabela agora vamos voltar aquele exemplo da repórter né inclui o verdadeiro parâmetro da população o mi com um determinado probabilidade eu quero fazer um outro intervalo de confiança naquele mesmo experimento só que agora eu quero fazer o intervalo de 95% para fazer o intervalo de 95% eu tenho que colocar lá o quase dois né quase dois desvios padrões 1. 96 para ser um pouco mais preciso construindo 100 amostras sempre com 100 pessoas o que eu teria agora é que uma porcentagem muito maior dos intervalos vai incluir o mi populacional aqui a gente tem uma cobertura de 95% U por caso exatamente o mesmo valor do esperado por teoria e se eu quiser fazer de um outro jeito eu quero mudar o número de pessoas tá eu quero fazer amostras maiores Eu quero fazer uma amostras com 1000 pessoas o que acontece é que meus intervalos de confiança vão ficar mais estreitos tô colocando um n maior tô dividindo essa margem de erro aqui associado a esse XV não mais pela raiz de 100 mas sim pela raiz de 1000 mas eu tô mantendo como eu tô mantendo o z associado a 95% né colocando 1. 96 ali o que acontece é que eu continuo com aquela cobertura de cerca de 95% essa a ideia do intervalo de confiança uma estratégia de computar um intervalo ao redor do seu x Barra que vai incluir o seu mi populacional numa certa probabilidade então A Regra geral para produzir um intervalo de confiança quando a gente sabe o Sigma né que era o caso Desse exemplo é isso aqui x bar mais ou menos um z vezes o erro padrão vezes o Sigma da população original dividido pelo raiz do n p é a porcentagem desejada de valores que vão conter o seu parâmetro e z é o valor valor correspondente aquele P né então é aquele valor que você consegue a partir de uma tabela Z né ou usando o que enorme do R Então vamos só relembrar aqui como que tendo um p como se obtém um z eu quero achar uma probabilidade de cobertura do parâmetro mi de 68 por.
tá então eu vou ter um valor - e em valor mais e que centram os 68 por de probabilidade aqui no meio e eu sei que essa é uma distribuição simétrica e que tem que somar 100% ou seja tem 16% aqui e outros 16% aqui Relembrando tanto a tabela quanto o PME eles eles usam a integral dessa distribuição de menos infinito até o valor de Z né então e e e na tabela Z lá o que aparece são os valores positivos de Z apenas Então você tem que procurar na tabela o valor correspondente a 84% procura na tabela até chegar aos seus 84% e você encontra o seu Z aqui que no caso é um então um daí zero na primeira casa decimal e zero também na segunda casa decimal Então 84% esse é o jeito para chegar aqui e que eu poderia fazer no R por outra estratégia escrever o que enorme p84 então eu chegaria no meu z = 1 aqui né aproximadamente 1 no R eu poderia colocar também valores menores do que 50% ou seja Associados a z negativos então se eu colocasse o 16 ele me dá o -1 a integral de menos infinito até um é 0. 16 né então 16% de probabilidade e se eu quisesse fazer o 9 5% eu quero achar os valores de Z que limitam 95% de área tem que ter 2,52 para cada lado faço a integral do menos infinito até o Z positivo que soma os 97,5 por. e é só procurar na tabela Onde está o 97,5 então é 1.
96 né então parte inteira a primeira casa decimal vem aqui das linhas e a segunda casa decimal vem dessa coluna Então pode colocar no R lá então o que enorme associado a 97,5 por daí ele vai te dar lá um 1. 96 você pode botar o 2,5 né ele vai te dar - 1. 96 tá a gente já sabe da tabela agora vamos voltar aquele exemplo da repórter né tem ela sabe o Sigma 100 ela quer o intervalo de confiança 95% fez uma amostra de 100 alunos e observou que a média da nota do ENEM desses 100 alunos é 705 ela quer construir o intervalo de confiança Primeiro passo é computar o erro padrão O desvio padrão da Média aquela distribuição que a gente sabe por teoria de onde se originam os X Barras né os X Barras eles vê de uma distribuição que tem aquela função densidade de probabilidade o Sigma do X bar só aplica a formulazioni é 705 mais ou menos um p96 vezes o 10 que é o erro padrão tá o intervalo de confiança é dado por 705 mais ou menos 19.
6 você pode apresentar também de outra forma intervalo de confiança inferior é tanto intervalo de confiança superior é tanto ou o intervalo de confiança tá limitado por esses dois valores é assim que se apresenta intervalo de confiança beleza vamos pegar um outro exemplo agora né Vamos usar agora tá então a duração de uma peça de um equipamento Segue uma distribuição normal com Sigma 5 horas Ah então de novo ele tá dando Sigma pra gente então ela dura por uma determinado número de horas e o desvio padrão desse número de horas que essa peça dura é cinco tá então foram amostradas 100 peças e obtiveram uma média de duração de 500 horas então esse aqui é um x Barra certo a gente já tem aqui o nosso Sigma a gente já tem o nosso xbarra e tem o nosso l então a gente quer construir um intervalo de confiança pra duração da Média com nível de significância 95% primeiro passo lá computa o erro padrão descobre o valor de Z associado à aquela probabilidade e finalmente computa o intervalo de confiança então o x bar que é o nosso 500 mais ou menos o z que é 1. 96 vezes o erro padrão que é 5 dividido por √1 né então só aplicamos a fórmula aqui bem facinho mesmo só relembrar que a gente sempre tem que construir a nossa distribuição das médias né Sempre tem que saber o desvio padrão da nossa distribuição das médias tá e assumindo então que ela saiu da distribuição normal você consegue usar o z da tabela normal padrão continua com o cálculo aqui chega nesse intervalo de confiança 499 até 501 quase a né e agora vamos complicar um pouquinho mais quando a gente não sabe essa variância foram sempre dados os valores de desvio padrão e se eu não tiver o desvio o valor de desvio padrão da população se não tiver eu estimo eu sei que a melhor estimativa do Sigma da população é o desvio padrão da minha amostra né então eu uso o meu S né eu faço aquele estimador s com n-1 ali e e daí eu continuo usando os zore do mesmo jeito né daquela da nossa tabela Z e só que isso só funciona quando o nosso n é grande pelo teorema central do limite a gente só consegue construi uma distribuição das médias que se iguala a uma distribuição normal quando você tem um n gigante né se você tem um n pequeno ele ainda não não adere perfeitamente é uma distribuição normal para quando o n é grande você consegue usar essa mesma estratégia que a gente já tinha visto vamos pegar aqui um outro exemplo com um n gigante de 500 peças examinando 500 peças encontrou-se 260 defeituosas 52% de de peças defeituosas né 260 divido por 500 a gente chega aqui no nosso x Barra de de 52 do Qual que é o intervalo de 95% da proporção das peças defeituosas aqui a gente vai ter que aplicar aquela mesma equação minha só que agora a a gente não tem o Sigma né mas eu vou dizer para vocês que a variância de uma proporção é dada por P 1 Men P se a variância é isso é só tirar a raiz que a gente chega no desvio padrão temos o nosso x Barra de 52% temos a nossa variância que é p 1 Men P tira a raiz desse P ou men P né então 52 x 48 e a gente chega no desvio padrão então o desvio padrão dá média né então o nossoo erro padrão de 0. 02 né e depois a gente continua naquele mesmo esquema né como o n é gigante a gente consegue usar aproximação normal sem problema a gente está querendo fazer o intervalo 95% a gente chega no z de 1.
96 intervalo de confiança o x bar 052 mais ou menos 1. 96 o erro padrão 0. 02 Dan e Chegamos no nosso intervalo de confiança 95% né de pon 47 até p 56 Tá mas isso aqui funciona porque quando o seu n é gigante né quando o seu n é gigante a distribuição normal aproxima bem a sua distribuição das médias mas quando você tem um n pequeno isso já não funciona então a premissa para conseguir usar esse teste que a gente falou é ter um n grande mas daí tem um cara genial né então o gosset um statio que trabalhava na Guinness que faz cerveja e ele produziu ferramentas estatísticas incluindo essa distribuição T que que usa no teste t né teste t de students ele botou isso como pseudônimo dele para conseguir publicar esses trabalhos ele produziu essa distribuição t e essa distribuição t o que que ela é Ela é uma distribuição que se aproxima muito com a normal só que ela tem uma maior densidade de probabilidade nas Caldas tá nas caudas da esquerda e da direita Então ela é mais conservadora aqui eu fiz um plot de uma distribuição normal ela começa aqui embaixo e depois ela sobe sobe sobe e chega aqui em cima é a mais magrinha né ela tem menos probabilidade aqui menos probabilidade aqui e o máximo de probabilidade perto do zero tá essa é normal e aqui estão as distribuições T com diferentes graus de liberdade tá então é um parâmetro dessa função que tá associado a um n né o grau de liberdade é dado por n - 1 aqui um grau de liberdade um ou seja essa aqui é a distribuição com maior densidade nas caudas tá e quando você vai aumentando o grau de liberdade Você tem uma maior concentração da probabilidade perto do zero e minimização nas caudas e isso aqui é só o codigo Zinho que eu usei para produzir essa figura colocando aqui o dorme né que a gente já tinha visto né para construir a função da estade de probabilidade de uma normal e depois em seguida eu coloquei as distribuição T com diferentes graus de liberdade né então 100 30 10 5 até um a gente vê que é bem similar assim como tinha lá o p enorme o q enorme agora a gente vai usar o qt e o PT e sempre colocando o grau de liberdade que é o parâmetro Extra né que tem da distribuição T aqui tá colocada aquela tabela que a gente já conhecia da distribuição normal a tabela Z e aqui tá a dessa distribuição que que é muito parecida com a distribuição normal mas que é ela tem essa variação das densidades aqui dependendo do grau de liberdade e dá para ver que aqui a organização da tabela já é totalmente diferente né O que que o que foi colocado Aqui foram os graus de liberdade nas linhas e os valores de probabilidade nas colunas a integral de menos infinito até um determinado valor de T que é o que tá colocado aqui tá associado a 60% de probabilidade 60% de probabilidade que tá aqui com grau de liberdade de um e o que a gente vê que quando vai subir no grau de liberdade a gente chega aqui num no no grau de liberdade infinito isso isso aqui é exatamente an normal né então a gente pode procurar esses valores de probabilidade associado a esses valores do nossos quantias né do nossos valores de t a gente pode procurar isso aqui na tabela Z então vou procurar os valores de probabilidade Então tá aqui o valor mais próximo de 60% aqui o valor mais próximo de 70 80 e assim por diante e qual que é o valor de Z associado a esses valores né o z de 0.
25 que é o valor que a gente tem aqui o 0,25 aqui o 0,52 que é o valor que a a gente encontra aqui de 0 a 52 então só mostrando que a tabela normal é igual a tabela T quando você tem um grau de liberdade infinito mas quando a gente vai diminuindo o grau de liberdade os TS ficam mais distantes do zero né ou seja eles estão eles vão tornar esse nosso intervalo de confiança mais largo quando você tem um n pequeno você vai ter um grau de liberdade pequeno ou seja você vai tender a ter valores de T mais distantes do zero né ou seja esse intervalo de confiança de uma amostra pequena é mais largo do que de um n grande e por doas razões né primeiro porque tem o raiz de n ali e depois também porque tem vai ter um grau de liberdade menor Então vai ser o número maior Então vamos lá vamos pegar um outro exemplo aqui então agora um exemplo com uma amostra bem pequena com n menor do que 30 você é obrigado a usar uma distribuição T mas como a t e a normal chegam no mesmo lugar vale a pena usar sempre a t porque a t ela vai corrigir pro seu grau de liberdade o jeito fácil para não fazer bobagem é sempre usar T Então vamos olhar isso nosso exemplo a média O desvio padrão de uma amostra de 10 elementos NT 10 são 8. 7 a média e 2is o desvio padrão Qual que é o intervalo de confiança com o nível de 95% e daí primeiro passo computar o erro padrão segundo passo procurar na tabela agora tabela T Qual que é a probabilidade associada a 95% né sempre lembrar que o 95% não vai estar aqui na coluna 95% não é assim que funciona você tem que colocar os 2,52 de cada lado lá e chegar a 97,5 né então a gente tá com probabilidade 95 né então tem que procurar no 97,5 e a gente tá com grau de liberdade nove né então que é o 10 elementos menos 1 então grau de liberdade 9 grau de liberdade nove que a gente puxa aqui ou a gente poderia procurar isso pelo R né a gente usa o qt né Qual que é o quantil da distribuição T com esse grau de liberdade 9 eh associado a 97,5 por. aí você acho chega no mesmo valor né então a gente tem lá o nosso valor de T correspondente esse grau de liberdade e essa probabilidade e daí é só construir o intervalo de confiança x bar 8.
7 o t 2. 26 vezes o erro padrão né que é o a melhor estimativa que a gente tem do nosso Sigma que é o nosso desvio padrão amostral do e o n né o raiz do n que era 10 né então chega nesse intervalo que vai de 7. 2 até 10 Beleza então a conta é fácil mas agora vamos partir um pouquinho paraa interpretação podem ser verdadeiras ou falsas interpretando intervalo de confiança eu estou 95% certo de que minha média mostral está correta tá não essa afirmação tá errada em vários níveis uma média mostral ela não tá certa ou errada a chance de que você tenha conseguido colocar sua média mostral em cima do teu mi é quase zero né principalmente se for contínua sua distribuição a chance de encontrar x Barra exatamente igual ao seu mi É zero né E então não faz sentido essa afirmação né E E se eu repetir Meu experimento mi vai variar mas cairá no meu intervalo de confiança em 95% das vezes Isso tá errado por quê Porque tá falando que mi varia como a gente já sabe mi é uma constante né O Mi é um parâmetro populacional fixo o que vai mudar é o x Barra né que é o x Barra ele vai depender da sua amostra ele tem uma distribuição diferente do mi que é uma constante então o mi nunca muda o que muda é a média amostral e o intervalo de confiança ao redor dela né que o intervalo de confiança sempre tá centrado no x Barra o intervalo de confiança da Média tá sempre centrado na média mostral daí aqui ó se você repetir seu experimento muitas vezes repetindo também o procedimento de cálculo para obter o intervalo de confiança 95% espera-se que 95% dos intervalos irão cobrir a verdadeira média M da população Então esse aqui é a coisa certa né Então essa é a interpretação de intervalo de confiança o meu intervalo de confiança tem 95% de probabilidades incluir Mi vocês acham que isso aqui tá certo ou tá errado você defini um intervalo de confiança ou dois números maior ou menor e o seu mi ele pode est lá dentro ou não tá o mi é uma constante que pode estar dentro daquele seu intervalo de dois números sim ou não Não não é que ele tenha uma probabilidade de 95% o que tem a probabilidade de 95% é o método Se você usar esse método você vai produzir intervalos diferentes é aquela ferramenta que tem a probabilidade de 95% não aquele intervalo então o seu intervalo não tem isso aqui então isso aqui não tá exatamente certo talvez você possa achar que isso é algum preciosismo mas é mas não é a definição formal do intervalo de confiança o problema daqui é que uma vez definido o intervalo ele contém ou não mi é uma concepção com e errada de intervalo de confiança e a definição essa que a gente tinha colocado aqui né então seria esse procedimento de cálculo aqui tem uma explicação um pouquinho mais mais prolongada disso aí se vocês tiverem eh só pegar depois o link nos slides os intervalos de confiança são construídos para conterem mi numa fração das repetições e não sabemos onde nosso mi está a gente não tem um valor de probabilidade associado a isso O que a gente viu aqui foi tudo sobre intervalo de confiança da Média que a gente pode computar dessa forma Esse é o jeito habitual Esse é o jeito que se ensina eh Mas como já tinha mostrado na primeira aula eu gosto muito desses métodos de de reamostragem esses métodos Monte Carlo né esses procedimentos Bootstrap é uma coisa muito simples né você não precisa de toda a teoria do teorema central do limite e você consegue computar intervalos que convergem muito bem pros que são computados dessa forma toda baseada em teoria tá E só para relembrar o que que é esse procedimento Bootstrap você amostra sua amostra né com reposição com o mesmo tamanho você tem 10 elementos você seleciona 10 elementos ao acaso aqui com reposição então você pode pegar mais de uma vez cada elemento duas três vezes o mesmo elemento tem elemento que você pode não pegar nenhuma tem uma aleatoriedade ali e daí você computa sua estatística de interesse que pode ser a média mas pode ser mediana pode ser desvio padrão pode ser intervalo interquartil você pode usar a estatística que você quiser tá é claro que tem as estatísticas aí que a gente sabe que tem os vieses né Então o intervalo interquartil tem viés o O desvio padrão tem um viés principalmente se você tá trabalhando com com tamanho de amostra muito pequeno mas você consegue produzir para essa estatística seja ela viesada ou não você consegue produzir um intervalo de incerteza dela é uma chave mestra né então você não precisa se preocupar se você tem um n baixo ou um n alto ele vai produzir já o seu intervalo já considerando todos esses aspectos você pode usar isso para várias estatísticas de interesse tá E e é um procedimento que tudo bem ele é um Pouquinho complicado na primeira vez que você vê mas com o tempo isso vai ficando mais fácil né então re amostra com reposição computa sua estatística de interesse qu seja ela qual for e repete isso várias várias vezes né e depois a partir dessa as estatísticas re mostradas você computa os percentis né de início e fim do intervalo Então pega o o percentil 2,5 percentil 97,5 por exemplo para produzir o intervalo de confiança 95% da sua estatística aqui é um exemplinho a gente faz aquele mesmo procedimento que a gente já tinha visto na primeira aula mas que vale a pena lembrar né que é definir os valores definir os vetores e depois eh fazer um loop aqui com muitas repetições em cada um deles você faz o sample né usa sua função sample amostrando a sua amostra com o mesmo tamanho dela com reposição tá então essa aqui vai ser sua amostra Bootstrap tá e você faz isso múltiplas vezes e e em cada um vez Dessa você computa sua estatística que pode ser média desvio padrão mediana intervalo entre quartil o que for né e aqui tá por exemplo mostrado o histograma das médias seguiu razoavelmente uma distribuição normal e você consegue pegar lá os intervalos dessa média de amostra boot step pegando aqui o percentil 2,5 975 então você conseguiu construir o intervalo de confiança 95% e isso pra média ou pro desvio ou pra mediana ou pro intervalo interquartil você consegue fazer sempre o mesmo procedimento e eu vou partir um pouquinho aqui pro R para repassar vários aspectos interessantes dessa aula né então primeiro eu quero refazer algum daqueles exemplos examinando 500 peças encontrou-se 260 defeituosas Qual que é o intervalo de confiança de 95% das peças tá sabendo que a variância de uma proporção é é P1 Men P Então vamos lá Primeiro passo é definir a nossa amostra a minha amostra de 500 peças tem 260 uns repete o um 260 vezes é isso que tá colocado aqui e repete o zero 240 vezes né o 1 Men p e depois concatena esses dois vetores né então um monte de zero e um monte de um essa aqui é a nossa amostra certo então aí é foi a partir disso aqui que foram computadas todas essas estatísticas e você pode fazer o caminho todo ali computar o n né que é baba que D 500 gente já sabe disso o nosso x Barra a média desse monte de zero e monte de um que vai dar os seus 52% o se desvio padrão que deu quanto aqui deu meio que tem que dar a mesma coisa que isso né a variancia da proporção é 1 p menos p e tirar a raiz quadrada dá muito próximo um valor do outro depois a gente tem que calcular o z né a gente tinha feito isso aí tudo para para amostras gigantes quando a gente só sabia do Z ainda né poderia pegar o que enorme do 97,5 que daí deve dar 1.
96 pra gente ou a gente pode agora usando o t né então o qt também para 97,5 colocando o grau de liberdade n - 1 Então temos o nosso t 1. 96 aqui né então você vê que a normal é aproximada muito bem pela T quando seu grau de liberdade é gigante tá quase o mesmo valor né o z e o t uma vez que tem isso vamos fazer aquelas continhas que a gente tinha feito antes Z vezes o erro padrão então o desvio padrão dividido pela raiz do n tá então esse aqui vai ser a nossa margem de erro né 0. 04 que a gente pode pegar esse valor e multiplicar por um vetorzinho um 1 um + 1 e o menos um né então mais ou menos o jeito de fazer no R é colocar esse vetorzinho mais 1 e men1 multiplicar aquele número né que a gente tinha produzido aqui e a gente chega nisso aqui a gente só soma o nosso x bar e pronto a gente tem o nosso intervalo de confiança né que era o 0,52 - 04 e 0,52 + 04 ou seja 0,47 0,56 era isso que a tinha feito nos slides né e a gente pode agora fazer o t computar o intervalo de confiança no t é só colocando x Barra mais ou menos o seu T vezes o erro padrão e chega aqui no seu intervalo de confiança usando T né que dá quase a mesma coisa a gente pode passar agora para um outro jeito de resolver isso a gente viu isso tudo fazendo na mão né fazendo todas as continhas lembrando de cada um dos detalhes de como que se faz essa conta mas no dia a dia o a gente usa as funções nativas dos programas né para fazer as suas contas e aqui a gente usa Por exemplo essa função ttest né a função Nativa do RT test te dá o intervalo de confiança essa função serve para outras coisas esse pedaço aqui todo a gente pode ignorar por enquanto mas o que vem daqui é um intervalo de confiança da nossa média né então é de men.
47 nã até pon se Nan que é exatamente o valor que a gente obtém aqui né em todas as casas decimais ou seja o que o r tá fazendo nessa função por baixo é Rodar isso aqui e aqui então aparece a média e aparece o intervalo de confiança você colocando nesse ttest da sua amostra e a gente pode também caçar isso pelo Bootstrap né a gente poderia computar os nossos intervalos de confiança usando o Bootstrap né que é é só definir aqui o nosso vetor onde a gente vai colocar as nossas médias amostrais e rodar aqui então as as várias várias vezes né os vários bos bootstraps em que cada vez você constrói uma amostra Bootstrap a partir da sua amostra original então sample função sample para fazer amostragens né da sua variável amostra com o mesmo tamanho da sua variável amostra com reposição aqui então a tem a nossa amostra que é o monte de zero monte de um né aquelas peças defeituosos e não defeituosos e fizemos uma amostra aqui então temos uma amostra pro strep que agora amostrou aleatoriamente aqui esses valores tá e computou a média e vai salvar numa posição desse vetor quando você roda isso aqui asas 10. 000 vezes aqui o nosso histograma bonitinho mostrando que aproxima muito bem de uma distribuição normal e consegue computar os quanti aqui 2,5 e 97,5 por e dá para ver que eles se aproximam muito daquilo que é dado pela função Nativa do R né usando o t lá p 476 e o p 564 né fazendo pelo Bootstrap a gente não precisou de nenhuma teoria do teorema central do limite a gente chegou no mesmos valores disso né só fazendo amostragem com reposição da nossa amostra e computando a estatística em cada vez e depois computando os x 2,5 e 97,5 chegando lá no nosso intervalo de confiança tá então esse aqui é o primeiro exemplo que eu queria mostrar para vocês mostrando todas as coisas que a gente viu em aula mas agora com a mão na massa né E vamos fazer terceiro exemplo o que que era mesmo a média desvio padrão de uma amostra de 10 elementos são 8. 7 e 2 qual o intervalo de confiança de 95% tá então a gente já tem o n que é 10 tem o x Barra que é 8.
7 e tem O desvio que é do é isso que a gente tem Poxa eu quero fazer aquela usar aquela função Nativa que é uma mais prático de todos né só que a gente não tem amostra né a gente só tem as estatísticas da amostra a gente tenta rodar isso aqui não roda né porque não existe essa variável para conseguir usar as funções nativas do R você tem que ter uma amostra e a estratégia aqui que eu vou mostrar é como simular a sua amostra a partir das estatísticas porque a gente precisa de alguma coisa como os valores brutos Tá eu vou assumir aqui que essa amostra veio de uma distribuição normal e cheguei nums valorzinho ali vindo de uma distribuição normal com média zero e desvio um Mas vocês vão ver que a média dessa amostrinha que a gente fez que veio do distribuição normal de média zero desvio padrão um ela não tem média zero Tá mas a média dela aqui no caso deu 0. 43 e o desvio padrão que a gente imagina que viria do um na verdade de 1. 18 eu quero transformar nisso né Eu quero transformar ela numa amostra de 10 elementos com essa média e esse desvio tá Como é que eu faço o primeiro passo é Forçar ela a ter média zero e desvio padrão um como é que eu faço para forçar ela a ter essas estatísticas média zero e desvio padrão um Primeiro passo é deslocar essa amostra no sentido inverso da Média dela né então se ela tem a média 0.
43 eu tenho que subtrair o 0,43 para fazer ela ficar centrada no zero tá então uma vez que eu fiz isso eu tenho a minha amostra centrada no zero e o próximo passo é dividir pelo desvio padrão Eu tenho um desvio padrão de 1. 18 se eu divido pelo desvio padrão de 1. 18 eu forço ela ficar com desvio padrão um então eu vou rodar isso aqui e Observar se deu isso de fato Qual que é a média agora desse valor atualizado Aqui é zero então a média é menos 3 elevado a 10 a-17 ou seja é zero é o é o o que o computador consegue representar como zero e o desvio padrão aqui deu um né Então temos média zero desvio padrão 1 e daí é só multiplicar essa amostra que agora tem média zero desvio padrão 1 eu multiplico ela pelo desvio padrão que eu tenho interesse que é dois fiz desir o padrão sair de um e ir para dois e depois eu somo no meu x Barra né então ele vai sair de zero e vai cair no meu x Barra no caso aqui 8.
7 tá então agora tá atualizada a nossa amostra com todas as características e vamos checar aqui a média é 8. 7 e o desvio padrão é do tá então temos a nossa amostra aí com esses valorzinho que chegam nessas estatísticas agora a gente tem nesse dado simulado a gente consegue aplicar as funções nativas do R né para conseguir computar o nosso intervalo de confiança rodamos o ttest tem todo esse pedaço aqui que a gente ignora por enquanto né E chegou lá no nosso intervalo de confiança de 7 a 10 vocês podem checar lá nos slides vão ver que vai dar bem e poderia fazer também pelo Bootstrap aplicar exatamente o mesmo caminho né exatamente que a gente já tinha visto no outro caso então a distribuição tá lá centrada no 8. 7 que era a média dela e tem o desvio padrão a gente pode olhar o desvio padrão quanto que dá o desvio padrão PR essa média bootp isso aqui é para dar o erro padrão né 0.
59 8 a gente conseguiria pegar fazendo o qu pegando o s dividido pelo ra n se eu pego o s que é 2 divido pelo ra do n que é ah a gente aproximou muito bem né Conseguiu chegar muito perto do erro padrão computado por teoria e através dessa ferramenta Bootstrap depois que a gente fez isso aqui no Bootstrap a gente pode computar o intervalo de confiança né então que deu bem parecido o intervalo de confiança pela função Nativa do R né ela deu até um pouco mais estreita Se você olhar ó aqui deu de 7. 26 até 10 usando o teorema central do limite adaptado para para aquelas distribuições de de n baixo né então botando mais botando a calda mais mais pesada Tá mas quando você faz um Bootstrap na verdade você tem até uma uma definição até um pouco mais estreita isso Às vezes acontece um lado Às vezes acontece o outro não é uma regra de que o Bootstrap seja mais apertado Bootstrap na verdade é uma medida mais acurada ele usa exatamente a informação que tem naquela amostra é claro que é uma amostra simulada aqui mas ele usa toda a informação que tem naquela amostra para conseguir fazer uma estimativa dos seus intervalos de confiança muito bem se você coloca uma distribuição que é muito assimétrica ou uma distribuição bimodal dá um intervalo de confiança muito mais estreito que do que deveria ser se você faz o Bootstrap ele fica mais largo o Bootstrap ele é uma uma ferramenta mais acurada para fazer estimação de intervalo de confiança tá E aqui aquele último Pedaço o intervalo de confiança de várias estatísticas né então aqui era só definição da nossa amostra e aqui os a definição dos vetores onde a gente vai salvar as médias Bootstrap desvio Bootstrap mediana Bootstrap para cada uma delas né a gente roda lá os nossos 10. 000 bootstraps para cada um deles a gente faz a mesma coisa né então primeiro a gente define a nossa amostra Bootstrap faz o sample da sua amostra com o tamanho da amostra com reposição e para cada loop desse você tira a sua estatística de interesse a média O desvio padrão a mediana o intervalo interquartil aqui é a função do R para fazer intervalo interquartil né mas que dá o mesmo resultado daquela outra que pega os quantias explícitos né quanti 25 e o quanti 75 faz todo esse caminho você pode olhar como que é a cara das distribuições e pode olhar Quais são os intervalos de confiança definidos para cada um deles pegando os percentis 2,5 e 97,5 então a está produzindo intervalo de confiança 95% da média um intervalo de confiança 95% do desvio padrão o da mediana e assim por diante é uma ferramenta que serve para montte de coisa né então é uma chave mestra aqui para conseguir computar intervalos de confiança da estatística que você tiver interesse independente do formato da sua distribuição tem que ficar se bas and muito em teoria a teoria já vem automaticamente pelas aleatorização que são feitas por esse procedimento eu só quero passar mais um detalhe aqui eu só queria fazer um exercic inho rapidinho é um pouquinho mais aplicado né para aquele exemplo que a gente tinha dado na primeira aula de eleição aquela pesquisa que foi feita na véspera da eleição do primeiro turno da Prefeitura de São Paulo nessa pesquisa foram entrevistados esse n de pessoas 2800 e tanto eles encontraram essas porcentagens né estimaram Essas probabilidades A partir dessa entrevista com essa amostra confiança de 95% De onde veio esse intervalo de confiança centrado nessa média mais ou menos essa margem de erro é isso que eu queria mostrar aqui para vocês como fazer isso né então vamos lá vamos limpar tudo aqui o nosso environment então eu tô colocando esse n esse 2897 e eu vou fazer só o primeiro caso aqui tá desse candidato aqui o candidato Bruno conas então eu tenho esse n tenho essa probabilidade que é 23 e eu posso usar aquela Estimativa de desvio padrão de de proporção né p xes 1 - p para chegar na variância tirar na raiz para chegar então no desvio então o nosso desvio é o ponto 42 para essa Estimativa de média tem esse desvio e construo o nosso intervalo de confiança né que é x Barra que é essa probabilidade mais o qt para buscar o nosso t o mais ou menos ele pegou o 2,5 97,5 e pegando o qt para aquele grau de liberdade né o DF aqui é degrees of Freedom né o grau de liberdade que é o n - 1 tô colocando DF = mas não precisaria né se você der um F1 aqui no qt ele te diz que você põe a probabilidade na primeira posição e o grau de liberdade na segunda posição então é redundante né colocar esse DF aqui tá na mesma Enfim então só jeitos diferentes de escrever no R tá então aqui a gente tem que o t deu 1.
96 né o n é gigante então vai aproximar normal vai dar 1. 96 e daí então probabilidade o x Barra mais o valor de T vezes o erro padrão né que é o desvio dividido pela raiz do n que aqui deu esse 0. 007 e daí eu consigo computar Então o meu intervalo de confiança que deu quanto de 021 até o 0,24 no intervalo de confiança a gente consegue chegar na margem de erro subtraindo a probabilidade ele tinha falado 2% Tá mas na verdade é 1,5 por né É é é 2% uma estimativa um pouquinho mais conservadora pelo menos para esse candidato Você pode trocar lá botar o 014 e fazer toda essa mesma conta e chega num outro intervalo deu 1.