ayer sainz as analytics bueno nos da todo lo que sería el procesamiento ilimitado qué quiere decir esto de procesamiento ilimitado cómo lo vamos a ver más adelante dentro de la your saints analytics nos permite poder tener configuración de recursos por demanda y que sean elásticos de forma tal de que nosotros podamos empezar con un nivel bastante bajo por ejemplo para manejar vigas hoteleras de información y poder llegar a un nivel más alto por ejemplo llegar a manejar petabytes de información todo dentro de la misma plataforma y que ahí no nos tenemos que preocupar por lo
que sería en capacidades de crecimiento en cuanto quesería capacidades de crecimiento es conforme a sus necesidades la plataforma puede crecer verdad puede crecer y como les dije anteriormente pueden pasar por ejemplo una una única workspace de un único sigo el pool dentro del jersey nets puede ser de un petabyte y dentro del sainete pueden crear tantos puzzles como ustedes desean entonces pueden venir y tener ahí por ejemplo 5 petabytes de información dentro de lo que sería la plataforma igual dentro de los clusters de spark que vamos a ver más adelante que son los es park
pool podrían tener tantos clusters como deseen y cada clase puede crecer hasta 32 nodos y ustedes lo desean entonces tienen 2 closer pueden tener 64 no necesitan más capacidad podemos crecer a 128 nodos necesitan más capacidad podemos crecer a 256 nodos así entonces dentro de lo que sería las capacidades de análisis de datos son completamente elásticas según las necesidades e igual podemos iniciar pequeños podemos iniciar con 1 y conforme sea necesario podemos ir subiendo las capacidades esa es la ventaja de tener esto como una como una plataforma que además de poder venir y crecer nos
permite poder venir e implementar una plataforma completamente e integral que significa una plataforma integral o una plataforma unificada dentro de lo que sería el ayer sign apps analytics nosotros podemos tener una plataforma donde si ustedes desean implementar un data warehouse lo pueden hacer si ustedes desean implementar una solución de big data también está soportado si necesitan hacer todo lo que sería procesos de integración de datos o sea consumir ya sea de plataformas microsoft o no plataformas microsoft lo pueden hacer si desean publicar sus datos y que sean consumidos para plataformas microsoft o plataformas no microsoft
también se puede hacer todo como un servicio en la nube si después ustedes deciden ahora yo quiero empezar a trabajar con modelos de machine learning y quiero trabajar y tengo mi equipo de ciencia de datos que quiere trabajar con esos datos que yo genere de este de mi vida está quiero empezar ahora a generar soluciones escritas en python o escritas en r lo pueden hacer y ahí tienen toda la plataforma para poder venir y generar una plataforma colaborativa para la ciencia de datos y después ustedes dicen ah mira yo también ahora tengo mis científicos de
datos y ellos quieren publicar sus modelos ok no hay ningún problema los modelos también se pueden publicar en esta plataforma para que sean consumidos por este terceros ya sea por este el mismo componente de microsoft o un tercero por medio de 3 mbps y si ustedes quieren que eso sea crecer también escalamiento en cuanto a lo que sería un algoritmo o un modelo perdón publicado que soporten miles de operaciones por segundo puede crecer también que yo le pueda asignar un clúster para que atienda a todos los diferentes este componente o todas las diferentes llamadas entonces
vende que por eso indica que es una plataforma unificada dentro de la misma plataforma voy a tener diferentes soluciones entonces para ejemplificar tenemos este slide usualmente antes de sign apps siempre se había hablado de que teníamos soluciones de big data tenemos soluciones para hacer experimentación para datos estructurados semi estructurados que teníamos un data lake o un lago de datos y que por otro lado teníamos nuestro athar house y los datos relacionales donde teníamos opciones para transacciones para manejo de este bloqueos para manejo de seguridad etcétera pero en que usualmente sería cómodo solución de separadas entonces
qué es lo que decimos cuando hablamos de que es una única plataforma ayer sainz apps analytics viene e integra todo lo que sería los dos mundos de forma tal que ustedes pueden venir y hacer soluciones como les dije anteriormente de big data soluciones de análisis de datos soluciones de data warehouse soluciones de machine learning y todo dentro de una misma plataforma en un único servicio lo único que tienen que hacer es empezar a utilizar la plataforma y a gritar los componentes según ustedes lo necesite o empezar a utilizar los componentes están ahí los tienen que
empezar a utilizar bien ahora si nos vamos un poco detallados a lo que sería los ambientes microsoft usualmente donde lo que nosotros tenemos los ambientes microsoft tenemos está este es light este es light este o arquitectura ha sido presentada y ustedes lo más seguro que ustedes lo hayan visto muchas veces como la plataforma de abonados moderno de microsoft durante muchos años en donde decía bueno nosotros tenemos datos on premises tenemos datos que están en la nube datos que están en terceros por ejemplo aquí tenemos el force que es bastante utilizado y teníamos que pasar por
diferentes capas y con diferentes productos por ejemplo teníamos por aquí un data like teníamos para ingesta de datos todo lo que sería el datafactory para preparación de datos podríamos hacer contacta factory o con ayer data breach para hacer transformación y enriquecimiento de datos igual lo podemos hacer con datafactory mayor data brics y después para poder venir y consolidar la información lo hacíamos con el mayor data warehouse y la visualización con power vial esto estuvo esté bastante válido durante varios años sin embargo con el surgimiento de ayer sainz al sonar y tics lo que se da
es una integración en donde todo lo que sería las soluciones del agua de datos cuando ustedes crean un ayer sainz a sanar y tics workspace se crea el lago de datos ustedes pueden elegir el agua de datos dentro de las salinas analytics está incluido toda la que sería las herramientas de ingesta de datos o sea el datafactory que ustedes tenían que crear ahora por separado está dentro de ayer sainz apps analytics como un producto ya integrado si querían hacer por ejemplo este programación en sparc tal y como lo hacía aquí con ayer data brics para
hacer algún tipo de tratamiento datos ya no es necesario lo pueden hacer perfectamente con lo que sería el spark pulse que es una implementación de microsoft spark tal y como lo dice ahí anteriormente todo lo que sería lo que se conocía anteriormente como lo que sería la solución de data warehouse que era el 5 el data borrados en la nube escalable ahora eso se ha convertido en un componente dentro de ayer sainz al sonar yente esquema un chico el pool verdad que nos permite poder venir y tener dentro de la misma plataforma datos estructurados que
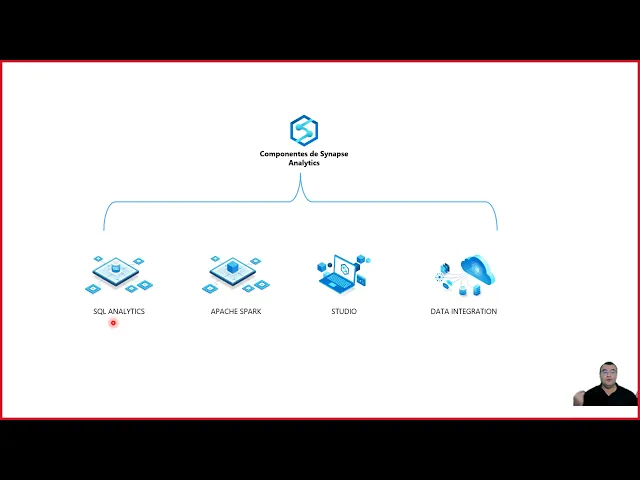
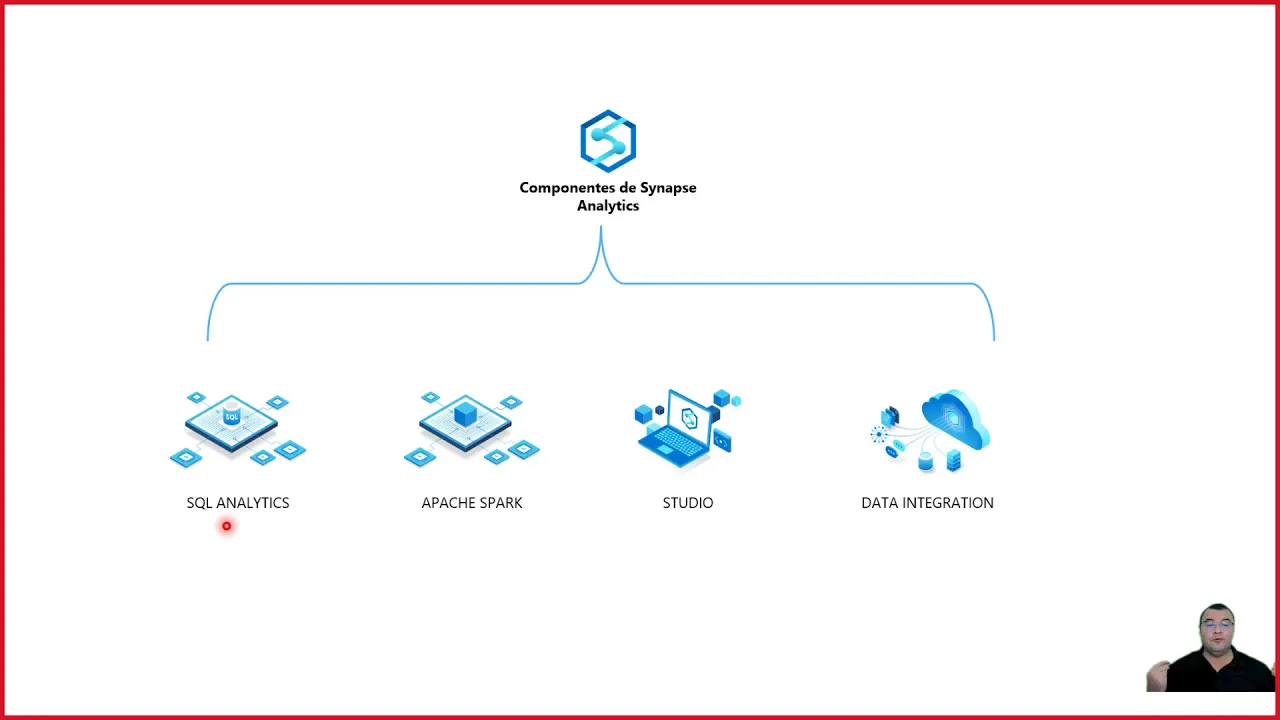
se comportan como una base de datos normal que soporta transar verdad de hecho si nosotros nos vamos a ir un poco más detallados dentro de lo que serían los componentes de sign up vamos a tener los siguientes de alto nivel dentro de lo que sería el saint john's analytics vamos a poder venir y tener si ustedes desean analizar datos con estilo de tranza qué sql verdad que sería el tradicional de éste sql bueno lo pueden hacer con el componente escuela analytics el componente de circo el analytics específicamente dentro de ayer sign up se llama es
un componente llamado como un sql pool s sql pool lo que nos permite es poder generar un un componente dentro de sign apps que soporta tranza que se cuele ahí vamos a poder nosotros venir y crear tablas hacer tablas normales tal y como los nosotros no las conocemos y hacer relaciones ya las primarias índices etcétera es una base de datos muy compatible con todo lo que sería sql server perdón sin embargo tiene unas grandes diferencias dentro de lo que sería el cic o el pool s 5 el pool puede manejar desde un giga de información
hasta perdón hasta un petabyte de información y cómo lo logra este psico el pool nosotros le configuramos un nivel de procesamiento el nivel de procesamiento más bajo eso un nivel 100 en ese nivel 100 lo que nosotros vamos a tener que parece pool tenemos un nodo por ponerlo aquí de forma general tenemos un nodo asignado verdad que tiene memoria tiene disco y tiene el procesamiento de sp si nosotros aumentamos a otro nivel por ejemplo un nivel 2000 o un nivel 3000 entramos a la consola y decimos pasamos de 100 a 3000 en ese momento la
plataforma pasa de un nodo a varios nodos ustedes como usuarios del sistema van a seguir viendo un pool un 5 el pool pero internamente ya tenemos un clúster de nodos que me están atendiendo mis datos e igual cuando ustedes definen una tabla y una tabla es muy grande digamos que tienen miles de millones de registros ustedes le pueden indicar a la plataforma que esa tabla va a ser distribuida entonces con fort con solo que ustedes declaren como la tabla qué va a hacer con una distribución este entre con una distribución ya sea por año por
fecha por fecha o por algún tipo de distribución cuando ustedes agregan nodos esas tablas van a ir siendo almacenadas en otros nodos de forma tal de que en un 5 el pool yo tengo un procesamiento distribuido y además datos distribuidos de forma tal de que nos da mayor desempeño entonces imagínense una tabla que tenga 10.000 millones de registros entonces esa tabla que tiene 10.000 millones de registros yo la puedo configurar de forma tal que esos 10 mil millones de registros estén distribuidos en 10 nodos cada una de las partes de esas tablas automáticamente es distribuida
en los 10 nodos y cuando se hace una consulta se hace una consulta distribuida de forma tal de que el motor esté de desempeño de procesamiento de consulta técnico el pool hace una consulta distribuida varios nodos entonces puede imaginar cómo que si usted estuviese en un clúster de forma muy general de 10 servidores con los datos y las tablas distribuidas entre esos 10 servidores cada uno con su propio storage cada uno con su propio procesamiento cada uno con su propio cpu y que cuando ustedes envían la consulta llega a este nodo que es el nodo
principal que es el 5 el pool y si es necesario hacer una consulta distribuida se va a hacer verdad entonces eso es súper importante de hecho es muy parecido a cómo funciona todo lo que sería el concepto en big data que es un nodo maestro este de datos y nodos de procesamiento entonces eso lo podemos hacer con el cic o el pool donde nosotros podemos aumentar el nivel y aumentar el nivel de nodos además de poder hacer esto algo que me soporta los cinco el pool que son los datos estructurados primero me soporta todo lo
que sería el colomo stuart index para poder venir y acelerar lo que serían las consultas me soporta todo lo que sería vistas materializadas de forma tal de que ustedes tienen una consulta muy complicada de diferentes jones se puede hacer una vista materializada para que sea mucho más rápido de las consultas otra de las características que tienen 5 el puzzle es que por ejemplo si ustedes están trabajando con power by y favor vía y empieza a hacer consultas dentro de las características que están en este caso disponibles y que están en previo y que ya van
a estar para producción está todo lo que sería la capacidad de que yo le puedo decir auto tuning de él ayer sainz apps analytics cuando yo le digo el auto tuning del ayer shaila saliente que significa que todas las consultas que habían al de power by el nodo el pool empieza a ponerlas en caché todo aquellos cruces que hacen las personas para análisis de datos se empiezan a poner en caché de forma tal de que la segunda vez que ingrese otro usuario que está utilizando ese mismo conjunto de datos no tengo que ir a buscar
en todos los nodos sino que ya está en caché para tener una respuesta mucho más rápida también me permite la generación automática de vistas dentro de que sería vistas materializadas entonces qué quiere decir que cuando consultan desde power bike son muchos datos esa vista o ese resultado se puede materializar para que para que la siguiente vez sea mucho más rápido de forma tal de que entonces ustedes tienen power vía y tienen el sic o el pool le activa en la parte de este caché y de optimización inteligente entonces todos los cruces de de datos y
análisis que está haciendo los usuarios automáticamente se van optimizando dentro de lo que sería el circo el pool otra de las ventajas que tiene y aquí es donde vemos de que no es sólo una base de datos por eso se llama un 5 él analytics es donde ustedes también el mismo este chico al público si ustedes tienen información en el lago de datos y es una información del agua datos que es es por ejemplo un csv que alguien cargó al lago de datos con el mismo datafactory co puede haber sido con el mismo side up
bueno yo puedo crear dentro del chico el pool algo que se llama una tabla externa la tabla externa lo que hace es de que le digo cree esta tabla externa apuntando al lago de datos con esta estructura usualmente eso es lo que se hacía en las soluciones de big data hagamos que sería la solución de pasadas en high soluciones basadas en este impala etcétera de que es ha sido muy muy popular en este caso dentro del circo el pool yo puedo tener exactamente la misma funcionalidad yo puedo decir generemos una tabla externa que está mapeado
a mi lago de datos el formato puede ser el formato csv que es textual o si ustedes están ya trabajando con lo que sería big data y están familiarizados recuerdan que otro formato de manejo de datos dentro de los el lago de datos es o hereje o r/c entonces ustedes pueden cambiar una tabla externa en el circo el pool ofrece si ustedes les gusta trabajar con parquet que es otro de los formatos bastante utilizados que es un formato columnas entonces ustedes también pueden venir y mapear lo a una tabla dentro del sic o el pool
mapear lo como una tabla externa a un parquet que está dentro de lo que sería nuestro lago de datos bien que esas son operaciones que usualmente se hacían en las soluciones de big data pero ahora las tenemos integradas dentro de todo lo que sería los cic o el pool de este de microsoft aunque aquí no nos pregunta fue a menezes que si tengo el plan de emigrar tome sus estructuras de datos incluyendo el data borrados al data ley que tanto cambiaría la manera de datos de trabajar para los data centers que capacidades técnicas tendría que
tener recomiendas para esta gestión de datos en este ambiente bueno dentro de lo que sería el uso de las capacidades dentro de lo que sería aquí los ingenieros de datos si lo que van a hacer es cargar este datos y lo pueden hacer con lo que sería el manejo de la ingesta de datos mediante el componente ingesta de datos de saint georges analytics ss drag and drop verdad también si lo que desean es también poder tener más control y generar scripts que usualmente los ingenieros de datos generan scripting ahí pueden generar van a ellos van
a poder generar scripting de dos formas al estilo trans a que se cuele con el 5 el pool verdad ahí lo van a poder hacer si desean ahí pueden hacer todo lo que sería el tratamiento de datos en 5 el pool pero también si están llevando ingeniería de datos y a ellos les han empezado a enseñar a hacer todas las tareas de transformación de datos con scripting xss en parte en sparc python o escala bueno entonces sería dentro de que sería el espacio apache spark verdad entonces dentro de estos ambientes cuando yo van a tener
que aprender sobre 5 él analytics en este caso tranza que se cuele sobre spark y específicamente cuando estamos hablando de estar van a tener que aprender sobre dos componentes o dos lenguajes que son de los más utilizados bueno primero todo lo que sería es parque güell que es este el un pseudo tranza que se cuele que se utilicen estar para transformación para consulta y transformación de datos también a tener que aprender python o ere usualmente ahora para ingeniería datos y están casi todos los cursos de ingenieros de datos utilizan python como base y lo otro
es de que cuando se hacen transformaciones rápidas de de datos ya no se hacen impacto no se hacen en escala que es otro lenguaje la ventaja desde que la plataforma de microsoft me soporta esos lenguajes entonces qué es lo que pasa ustedes van a poder trabajar con tranza que se cuele si desea pueden trabajar con es parque güell si lo desean trabajar con este python con pandas o cualquier otro paquete de payton que ustedes deseen y para manejo de gran cantidad de datos sin transformación lo pueden hacer con escala todo dentro de lo que sería
la misma plataforma la ventaja de que las opciones están ustedes solo empiezan a utilizar y todo está dentro del mismo ior sign up analytics no tienen que instalar nada nada más es la misma plataforma para que estaban funcionando es aquí esta parte del ciclo 'el analytics las diferentes características que tienen ustedes pueden ver que no es únicamente una base de datos que puede ser de que ustedes tengan esa idea la primera vez que utilicen no es una cantidad de nodos que puede pasar éste de una forma de 12 a 64 nodos ustedes desean de forma
transparente puede utilizar datos no estructurados tal y como le dije anteriormente pueden venir y consumir datos del data lake de con tablas externas ya sea en formato en formato este ejemplo jason puede tomar en formato todo lo que sería la parte de el formato parquet formato eres formato abro que son formatos usualmente el agua datos de big data lo pueden hacer también si desean pueden consumir modelos de machine learning dentro del mismo ciclo el analytics hay un predicado que se llama predictivo de hecho así se llama el estatuto el estatuto es predict entonces ustedes crearon
un modelo de machine learning y lo quieren aplicar dentro de una transacción de éxito el pool lo van a poder hacer sin ningún problema sólo dicen predict y hacen referencia al modelo que ustedes quieren aplicar y ese modelo puede haber sido creado en python sin ningún problema o en er air cree haber sido creado en un automatismo chiner ning machine learning de microsoft todo se puede hacer acá cual es el otro componente que nosotros tenemos el otro componente que tenemos es el componente de apache spark eso qué es lo que pasa usualmente donde durante todas
las tareas ahora de ingeniería de datos o de construcción de modelos de machine learning es muy común poder venir y primero tener sparks para este como un nodo y en ese nodo empezará a trabajar este con todo lo que sería los aspectos de un clúster aquí tenemos otra pregunta de que si el virtual maneja datos estructurados no estructurados y maneja datos no estructurados entonces como maneja datos no estructurados ahí ya esa elección de ustedes si quieren manejarlos en el 5 el pool o si lo quiere manejar en el cosmos debe pero podríamos manejarlo directamente dentro
del el cic o el pool porque podemos hacer ese manejo de datos no estructurados directamente acá puede ser aún a una pregunta ahora sí continuando acá con la con el otro componente el otro componente que nosotros tenemos es el apache spark apache spark bueno viene del opensource y todo en todas las carreras de ciencia de datos en todas las carreras de ingeniería de datos se utiliza apache spark como una solución para poder hacer dos cosas primero soluciones de machine ending y de ciencia de datos y también soluciones de limpieza y tratamiento y conversión de datos
entonces qué es lo que ha hecho microsoft microsoft dentro de ayer sainz apps incluyó un componente que se llama específicamente spark pool el spark pool como su nombre lo dice hace referencia a una instancia por ponerle un nombre a una instancia de spark que está respaldada por un clúster qué quiere decir esto yo creo un spark pool y cuando yo creo el spar pool yo le digo la cantidad de nodos que voy a poner en el clúster cuando yo le digo crear microsoft automáticamente hacen despliegue del clúster qué quiere decir esto donde esté en la
parte de él de los datos por ejemplo dentro de la parte de los diferentes datos que es lo que nosotros vamos a tener creamos el spar pool le decimos en el spark pool el tamaño del cluster que queremos usualmente se recomiendan tres nodos es lo mínimo digo cuánta memoria cuánto cpu va a tener cada nodo y le digo crear entonces se crea microsoft crea automáticamente el clúster de spark pueden parte iniciarlo con tres nodos si desean pueden descargarlo hasta 16 no o si ustedes desean sólo van a la consola y le dice ahora quiero 16
nodos eso es todo lo que tienen que hacer y microsoft de toda la instalación de lo que sería un spark que usualmente instalar 16 nodos de spark y se llevaría a sus semanas instalando los premis en la nube sólo decirle quiero 16 nudos a partir de ese momento tengo el spark pool disponible y cada vez que voy a ejecutar un script de spark el nodo se levanta hoy closer se levanta qué significa esto el spar pool es por demanda que es una de las ventajas que tiene entonces que yo haya creado un cluster de 16
nuevos no quiere decir que los 16 nuevos están encendidos y consumiendo este recursos no esos se utilizan sólo durante el tiempo de ejecución de los scripts de spark o de transformación ya sea de los notebooks entonces qué es lo que va a hacer voy a ejecutar una tarea se levanta los 16 nuevos se ejecuta si esa tarea tardó cinco minutos en ejecutarse yo le puedo configurar que cuando termine esa tarea se detenga el clúster y ya no voy a tener mayor consumo entonces es una de las ventajas que yo voy a tener aquí con el
apache spark una vez que tengo aquí el apache spark recuerden podemos este programar en los diferentes éste lenguajes que les había mencionado anteriormente otro de los componentes que nosotros tenemos en hay un sign up es el componente principal la consola principal que es el mayor sign up se estudió ahí donde están todos los diferentes charcos para poder venir y acceder a los cinco el pulse acceder los apache pulse y a los spurs perdón y después tenemos toda la parte de integración de datos en la parte de integración de datos es por ejemplo si ustedes habían
utilizado anteriormente datafactory y ahora está integrado exactamente el mismo componente está integrado dentro de lo que sería el ajax hay nada más que ahí se llama data de sessions hoy y si van a la consola van a sentir a decir integrity y ahí van a poder hacer todas sus tareas de integración integración de datos