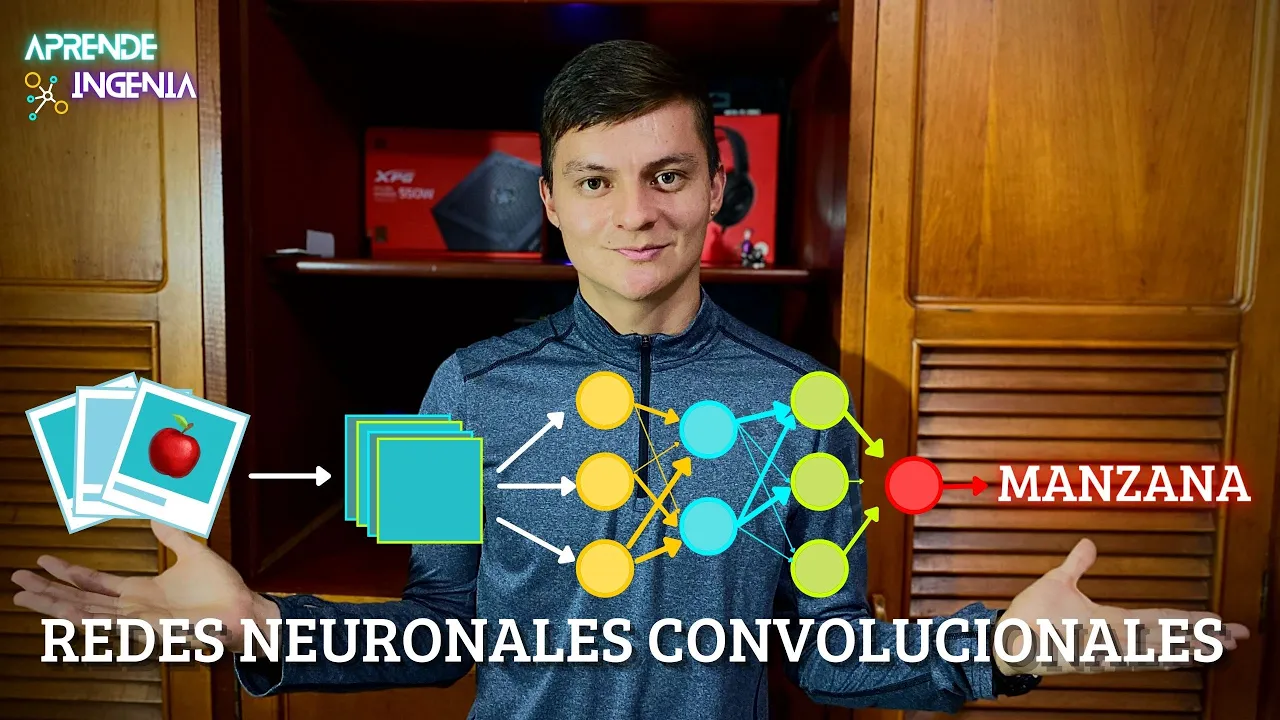
bueno entre bienvenidos una vez más este canal aprende ingenia les hables entrego sánchez y el es traigo un vídeo muy útil porque les voy a explicar cómo funcionan las redes neuronales convolución alex les voy a explicar cómo hacer un ejemplo en python y les voy a explicar cómo podemos monitorizar la en su entrenamiento así que no me enrollo más y comencemos con el vídeo bueno gente ya estamos aquí en mi computador me disculparán amigos de enfermo pero es que todavía estoy un poquito agripado el día de hoy vamos a ver el comportamiento de tres redes neuronales una es una red neuronal densa otra es una red neuronal convolución 'la y la otra es una red neuronal convencional control out que vamos a ver estos términos que son vamos a ver cómo funcionan las redes neuronales convolución alex y les voy a enseñar a hacer una red neuronal en python que lo que tengan mucha presten mucha atención porque este es un vídeo de bastante bastante detalle para que ustedes aprendan pues cómo funcionan las redes neuronales y aprender a hacer sus propias redes neuronales en python también antes de pasar con la prueba de los algoritmos quiero comentarles que si llegamos a 10. 000 suscriptores estaré liberando no solamente este archivo punto país sino que también les estaré liberando unas diapositivas de redes neuronales artificiales de redes neuronales convolución al es que yo mismo hice y además les estaré entregando que el data set digamos que la base de datos llenas de imágenes de esta red neuronal para que ustedes puedan utilizarla también les voy a enseñar cómo pueden descargar este data set así que pues bueno eso en el transcurso del vídeo nuestras redes neuronales convolución alex las hemos las hemos entrenado para diferenciar entre manzanas y naranjas como pueden observar son frutas bastante diferentes y bastante parecidas al mismo tiempo ambas son redondas tiene más o menos el mismo tamaño así que nuestra red neuronal deberá hacer un buen trabajo para poderlas distinguir lo primero que vamos a hacer es que vamos a probar nuestro a nuestra red neuronal densa esta no es una red neuronal convolución 'la sino que simplemente contiene neuronas de clasificación y para entender bien el funcionamiento de una red neuronal artificial les recomiendo que vean mi vídeo pasado donde les explico pues bueno cómo funcionan este tipo de redes así que vamos a empezar con esta donde vamos a colocar aquí james si vamos a empezar con nuestra red neuronal densa para ver qué tal se comporta esta red neuronal no obtuvo muy buena muy buena muy buen porcentaje de precisión y también obtuvo un porcentaje de pérdida bastante alto así que vamos a ver qué tal funciona si le entregamos una manzana a ver cómo pueden observar funciona bastante regular es bastante regular sigue diciendo que es una naranja así que pues bueno bien podemos observar de que ahorita se dice que es una manzana ves podemos observar que es una red neuronal con un porcentaje de efectividad bastante bajo ahorita vamos a probar con algunas imágenes para que podamos observar bien cómo es el comportamiento pues con la fruta real y con algunas imágenes así que vamos a empezar a ver mostrando el aquí ahí sí nos dice que son manzanas vamos a pasar la foto o mostrar si nos dice que esto es una manzana no nos dice que es una manzana vamos a ver esto es una naranja debería decirnos que es una naranja bien aquí tenemos otra naranja bien como puede observar el todo el tiempo está realizando una predicción porque es un programa bastante básico pero pues bueno esto ya hace parte de que nosotros digamos que decidamos cuando queremos realizar la predicción esto ya se hace con una interfaz gráfica etcétera etcétera aquí como solamente vamos a tocar el tema de redes neuronales entonces pues por eso no quise digamos que meterme mucho en el tema de las interfaces y todo esto pero es totalmente realizable bueno ahí más o menos detecta las manzanas pero como como podemos observar las redes neuronales densas no son la mejor opción para clasificar imágenes así que vamos a pasar con la primera red neuronal convolución al que cnn así que vamos a ejecutar el algoritmo y vamos a ver qué tal nos va con con las imágenes vamos a empezar con esta imagen que ustedes están observando acá es una imagen de manzanas y como pueden observar automáticamente de una la reconoce y nos dice que es una manzana completamente estable vamos a pasar a ver pasamos a la otra manzana nos sigue diciendo que es una manzana vamos a pasar creo que sigue una naranja efectivamente nos dice que es una naranja automáticamente cambia la predicción de nuevo nos dice que es una naranja vamos a pasar naranja a ver en esta se confunde un poco pero ahí nos dice que es una naranja bueno manzana vamos a ver manzana manzana y poder manzana ahí lo tenemos esto fue con las imágenes vamos a ver qué tal nos va con las frutas aquí nos dice que esto es una naranja bueno ahí se está confundiendo un poco naranja naranja vamos a cambiar vamos a cambiar a ver un poquito como se ve a la fruta a ver un poquito así naranja bueno y ahorita vamos a ver qué tal reconoce esta manzana la manzana si la reconoce bastante bastante bien así que pues bueno podemos decir que esta red neuronal convolución 'la funciona mucho mejor ahorita vamos a pasar con la segunda red neuronal convolución al y esta red neuronal convencional tiene un drop out que es un rap out básicamente se los va a explicar más adelante pero es básicamente intentar que nuestra red neuronal no tenga un sobreajuste así que pues bueno se los va a explicar más adelante y koko las diapositivas que les digo pero de momento vamos a intentar de luego con las imágenes vamos a colocar aquí las imágenes camps y vamos a ver qué tal nos va nos dice que son manzanas bien manzana bien naranjas bien naranja bien naranja bien ésta se reconoce mucho mejor esta imagen nos dice que son naranjas muy bien manzana manzana y ya estaría como puede observar no fallo en ninguna imagen y ahorita vamos a probar con las frutas reales entonces nos dice que es una manzana en la manzana a manzana manzana a manzana cambiamos a la naranja muy bien vamos a cambiar naranja naranja vamos a intentar cambiar la la pose de bueno la pose no ya la posición de la mano naranja naranja naranja manzana manzana a manzana manzana manzana así que cómo puede observar esta última red neuronal convolución al funcionó mucho mucho mejor y es mucho más precisa así que vamos a ver cómo funcionan las redes neuronales convolución alex y cómo pueden hacer este tipo de redes tan precisas por decirlo alguna manera en sus computadores bueno gente vamos a empezar con la explicación de redes neuronales convolución alex y recuerden que si llegamos a 10. 000 suscriptores me pueden contactar por mi instagram que se los voy a dejar por acá con el fin de que les pueda pasar los archivos del programa y también estas diapositivas que hablan de redes neuronales convolución alex y redes neuronales artificiales la trama de clases neuronales artificiales las vimos en el vídeo pasado así que les recomiendo que se vea en este vídeo para que entiendan este por qué porque vamos a empezar retomando el ejemplo del vídeo pasado donde entrenábamos una red neuronal para hacer una conversión de pulgadas a metros les recuerdo en este vídeo que este tipo de problemas no se solucionan con una red neuronal porque una red neuronal digamos que es un elefante para un problema tan pequeñito cierto es algo muy grande para un problema tan pequeño así que vamos a tomar este ejemplo y es que las redes neuronales artificiales las utilizamos para solucionar otro tipo de problemas por ejemplo problemas donde no tenemos una función matemática establecida como por ejemplo la estimación de la renta o de la venta de una casa según la cantidad de habitaciones que tenga según la cantidad de baños que tenga el estado de la cocina si tiene piscina etcétera etcétera como aquí ya tenemos una función establecida pues para este tipo de problemas no las utilizamos pero queremos en digamos que retomar este ejemplo porque este ejemplo es un problema es un problema de regresión eso quiere decir que es un problema numérico netamente numérico ingresas un número te entrega un número qué pasa con este tipo de redes neuronales este tipo de redes neuronales te solucionan problemas lineales porque porque nos estamos basando en el comportamiento básico de una red neuronal un producto y una suma porque todavía no hemos hablado de funciones de activación que ya lo vamos a ver más adelante así que tenemos que salir de este mundo lineal porque queremos ya empezar a obtener resultados de cosas mucho más complejas así que este tipo de red neuronal se queda corta para la clasificación como pudieron observar ese tipo de red normal que ustedes están viendo ahí o que ustedes están viendo en pantalla es un tipo de red neuronal densa sí que fue el primer modelo que vimos que prácticamente no fue capaz de clasificar absolutamente nada de estas dos frutas no fue capaz de clasificar la naranja de la manzana por eso les digo que no funciona también para imágenes porque en imágenes tenemos es un problema de clasificación y no de regresión así que vamos a empezar por el principio y es le entregamos las imágenes a una red neuronal lo primero que nosotros hacemos es pasar nuestras imágenes de color a escala de grises porque las pasamos de color a escala gris es cuando nosotros tenemos una imagen a color como la crisis ya están viendo en este momento tenemos tres canales rgb rojo verde y azul eso qué quiere decir esos tres canales que tenemos tres matrices una matriz roja una matriz verde y una matriz azul y cada una de esas matrices contiene un valor numérico para poder observar o para poder volver ar el color que ustedes están observando en este caso como ustedes ven la manzana roja bueno el valor numérico de la matriz roja es muy alta el de la verde es bajo y el de la azul es bajo también para que ustedes puedan observar el rojo o en este caso que están viendo esta naranja verde pues entonces el valor numérico de la matriz rojas bajo de la verde es alto y del azul es bajo como ustedes intuir han tenemos tres valores numéricos que procesar al momento de pasarlo a escala de grises ya no tenemos tres valores numéricos tenemos un solo numérico porque tomamos esas tres matrices las pondremos y tenemos un valor en un valor único en escala de grises entonces al realizar esta presión pasamos a tener tres canales a un solo canal y eso quiere decir un solo valor numérico y eso a su vez quiere decir que va a ser mucho más fácil procesar estas imágenes ahora es sobre el color por el tamaño lo que vamos a hacer es que vamos a restringir nuestras imágenes a un tamaño estimado cierto porque han tomado estimado porque ese tamaño va a determinar la cantidad de neuronas de entrada que necesitamos entonces en este ejemplo en este caso lo que hicimos fue tomar cada imagen y restringir la a 200 x 200 píxeles eso quiere decir que tenemos internamente o sea en toda la matriz tenemos 40 mil píxeles que van a equivaler a 40 mil neuronas que podemos observar en este pequeño esquema entonces podemos observar que aquí en la izquierda tenemos la representación de la imagen de nuestra manzana cada uno de los píxeles que pertenece a la imagen de esa manzana va a ir una neurona que pertenece a una capa de entradas entonces en este caso como tenemos una imagen de 200 x 200 que no necesariamente tiene que ser específicamente de la manzana tiene que puede dar más píxeles alrededor tenemos poseemos en esta imagen un ejemplo 40 mil píxeles y tenemos 40 mil píxeles en la imagen bastante pequeño por ende necesitamos 40 mil neuronas en nuestra capa de entrada a continuación después de la capa entrada vienen las capas de convolución y de agrupación de una red propias de una red neuronal convolución al pero antes vamos a hablar de las funciones de activación que son las funciones de activación las funciones de activación son las que nos permiten salir de un mundo lineal como así que de un mundo lineal recordando el ejemplo pasado del vídeo pasado que estamos realizando una conversión de pulgadas a metros a través de una red neuronal artificial simplemente estábamos realizando una multiplicación y una suma que son propias del funcionamiento de una red neuronal vamos a recordarlo aquí muy brevemente tenemos en la entrada 6 pulgadas que son las pulgadas que queremos convertir a metros el funcionamiento de una red neuronal artificial básica sencilla es el siguiente tenemos la entrada y la multiplicamos por el peso el peso es un valor numérico que se le entrega a una conexión entre dos neuronas entonces sería 6 por 3.
7 6 por 3. 7 nos da 22. 2 y a eso se le suma un sesgo el sesgo es un valor numérico propio de cada neurona entonces se le va a sumar el sesgo entonces 6 por 3.
7 22. 2 y le sumamos el sesgo 4. 2 en este caso y eso nos daría un resultado de 26.
4 esta red neuronal sin función de activación nos entregaría como resultado 26. 4 pero como tenemos una función de activación entonces éste 26. 4 primero va a ser analizado como así que analizado si vamos a determinar nuestra función de activación que en este caso va a ser reloj entonces la función reloj que nos dice si el valor que hay aquí es menor a 0 es decir un valor negativo se va a convertir en 0 entonces vamos a hacer ejemplo de que aquí no dio 26.
4 sino menos 26. 4 eso quiere decir que esta neurona nos va a entregar un 0 sí porque es menor a 0 ahora si el valor es mayor a 0 se entrega el mismo valor que es este caso entonces como el 26. 4 se va a entregar 26.
4 y ya estaría es sostener una función de activación simplemente tomar ese valor y pasarlo por una función y cambiarlo si la función dice que hay que cambiarlo o dejarlo si la función dice que hay que dejarlo igual también podríamos utilizar la función sigmoide hay un sinfín de funciones entonces pues bueno esto ya está en que ustedes investiguen un poquito por qué es importante las funciones de activación me voy adelantar un poquito porque estas funciones de activación nosotros las utilizamos en las capas ocultas que pertenecen a la etapa de clasificación entonces cómo pertenecer a la etapa de clasificación podemos clasificar de mejor manera por medio de las mociones de activación básicamente es por eso así que ahorita sí vamos a pasar a las capas de convolución y agrupación y es que estas capas son las encargadas de extraer características importantes de nuestras imágenes como así que extraer características importantes de nuestras imágenes nosotros entregamos todos y cada uno de los pixeles a cada neurona cierto y estas neuronas lo que hacen es determinar en un principio cambios de de color y tonalidades bordes líneas etcétera etcétera y esto hace parte de características propias de esta imagen por ejemplo de la naranja o de la manzana así que aquí tenemos un ejemplo un poquito general por decirlo de alguna manera vamos a suponer que nuestra red neuronal determinó que un círculo era una característica importante para clasificar estas dos frutas pero si era solo se quedan con el círculo pues le va a quedar muy difícil clasificarlas porque digamos que esta manzana no está tan redonda pero puede haber una crisis y va este y ahí va a tener muchos problemas en clasificar así que ella debe de encontrar otra característica que le ayude a clasificar por ejemplo determinó de que este palito y es una característica importante porque la naranja no lo tiene y la manzana así entonces ella va a decir círculo + palito es manzana círculo sin palito es naranja sí así que aquí tenemos un ejemplo con manzana naranja el coco círculo podrían ser manzana naranja o coco círculo + palito en naranja cierto ahora quedarían dos opciones círculos sin palitos podría ser coco o naranja así que círculo más tres circulitos pequeños sería coco y círculo solo por ejemplo sería naranja estos son solamente dos características pero una red neuronal aprende muchas características de las imágenes no solamente dos es solamente para que sepamos cómo es el comportamiento de estas capas de convolución y agrupación que al fin y al cabo son capas de extracción de características como podemos observar en este esquema tenemos la representación de la imagen de la manzana donde cada uno de los píxeles va a una capa entrada cartón a una neurona estas neuronas entregan bueno entregan estos píxeles a una capa de convolución que vamos a ver cómo funciona la convulsión y ésta a su vez entrega sus resultados a una capa de agrupación las capas de convolución y agrupación no necesariamente pueden ser una ayuda sino que puede haber convolución agrupación convolución agrupación convolución agrupación y así las veces que sean necesarias con el fin de extraer carácter cada vez más complejas porque porque cada vez que agregamos una capa de convolución y agrupación pues hacemos más pequeñita la imagen con el fin de resaltar las características más importantes de cada una de ellas y continuando con el esquema de la red pues ahí estamos los resultados de esa de estas capas de convolución y agrupación para unas capas ocultas que son las capas de clasificación donde pues bueno determinan si es manzana o si es naranja en este caso y pues por último bajo una capa de salida que nos entrega la información así que vamos a ver cómo funcionan esas capas de convolución y agrupación y es que esas capas están basadas en las neuronas de la corteza visual de los gatos un experimento que hizo joven y wiesel por allá en 1960 o alrededor de 1960 ellos determinaron que nuestra corteza visual que es la parte de nuestro cerebro donde procesa las imágenes en esa corteza visual existen dos tipos de neuronas las neuronas simples y las neuronas complejas donde las neuronas simples se encargan de se encargan de procesar pequeñas regiones de las imágenes y las neuronas complejas agrupan varias neuronas simples vamos a ver un ejemplo tenemos esta imagen vamos a hacer de cuenta que sólo estamos observando esta imagen las neuronas simples se encargan de cada una de los píxeles de ésta de esta imagen o no cada uno los píxeles sino pequeñas regiones de una imagen y ella simplemente realiza una convención es decir detección de líneas detección de contornos y detección de bordes etcétera etcétera y la contiene ella solita ahí ella no sabe qué hacer con ella ya simplemente dice vi un borde vi una línea vi un círculo y un contorno vi eso ella no sabe qué hacer con eso entonces por eso vienen las neuronas complejas y le dice yo sí sé qué hacer con eso yo tomo tu parte de tu línea tu parte de túlor de tu parte de tu círculo y los 1 y formó una característica por ejemplo en esta neurona toma esa parte de la imagen está neuro una simple toma esta parte de la imagen esta no era una simple toma esa parte de la imagen y es tan euro una simple toma esta parte de la imagen ellas por separado no sabían que eran eran simplemente líneas bordes contornos hasta que llegó la neurona compleja y dijo venga es que está la parte de arriba de una manzana lo mismo pasa con estas neuronas que están aquí en la parte de abajo donde llegó la neurona compleja y unos tics de abajo de una manzana por eso ustedes logran percibir digamos que esto es una manzana si solamente ven la parte de arriba o si solamente ven la parte de abajo si así que ustedes pueden determinar si una manzana es una manzana si está así y así como este la manzana porque nosotros todo el tiempo estamos extrayendo características de ella por medio de este funcionamiento entonces las neuronas simples realizan la convulsión que es la extracción de esas pequeñas características y la neurona compleja realiza la agrupación de todas esas características pequeñas por el de las neuronas complejas tienen un campo visual mucho más grande que las neuronas simples porque ellas agrupan pues varias neuronas simples así que ahí están las capas de convolución y agrupación la capa de convolución básicamente son esas neuronas simples que toman bordes hitos líneas contornos círculos rectángulos etcétera etcétera y las neuronas complejas agrupan todo eso para extraer una característica ya más completa porque tenemos la representación de la imagen aquí cierto como pueden observar y cada uno de esos pixeles va a una capa de entrada que en este caso en esta capa contiene 40. 000 neuronas bueno esta capa de entrada y cada una de estas neuronas contiene un pedacito de nuestra imagen que se la entrega a la capa de convolución con el fin de que ahí podamos extraer pues bueno las líneas bordes contornos círculos todo cierto y esos esas pequeñas características por sí solas no nos dicen nada así que agregamos la capa y agrupación que es la que nos une cada una de esas características chiquiticas pero por separado entonces las une y nos entrega características mucho más completas con el fin de que nuestras capas ocultas las puedan clasificar y entregarnos un resultado a través de la capa de salida así que teniendo en cuenta ahorita si vamos a pasar a la parte de la programación bueno gente voy a empezar la programación desde cero para que ustedes no tengan ningún tipo de problema así que lo primero que vamos a hacer es importar las librerías sin importar las librerías y ya les voy a explicar que librerías vamos a utilizar y para qué entonces por acá y son las siguientes librerías vamos a utilizar la librería 2 para saber dónde están nuestros datos es cierto la librería de tensor flow que es una librería de inteligencia artificial la librería de open se ve para procesar algunas imágenes la librería de mando el lic para observar algunas imágenes como es gráfica cierto la librería en un pin y pues bueno vamos a utilizar el tensor guarde tensor flow con el fin de observar el entrenamiento de las redes neuronales y también vamos a utilizar el generador de imágenes de tensor flow con el fin de generar algunas imágenes extra para que nuestro entrenamiento sea mucho mejor así que vamos a ir a file settings y vamos a importar esas librerías entonces vamos a empezar con para empezar tensor flow y es que yo les recomiendo que instalen la versión específica en una versión las 2. 2 2.
222 está instalen está para que no tengan problemas con la programación bueno gente mientras se instala yo les quiero ir mostrando donde encontré el data sets de imágenes y es que ustedes pueden encontrarlo hoy mismo si lo quieren lo pueden descargar que se llama tensor flow data sets cierto entonces simplemente van a el primer link y ahí pueden descargar cualquier data set que ustedes quieran para que puedan entrenar sus redes neuronales y ver qué tan bien funciona en sus redes neuronales interés para el primer link después vamos al catálogo aquí en el catálogo simplemente elegimos clasificación de imágenes y aquí tienen muchas muchas muchas en bases de datos que ustedes pueden descargar para entrenar sus redes neuronales así que lo que deben de hacer es lo siguiente en la carpeta donde ustedes estén grabando grabando no programando vamos a ir a la carpeta ustedes van a crear lo siguiente es aquí un vídeo entonces van a crear una carpeta que se llame ta ta ta ta bass como ustedes quieran hay dentro van a tener una carpeta de entrenamiento y una de validación entonces entra en la carpeta entrenamiento y para tener otras dos carpetas una de manzana donde están las imágenes de las manzanas y otra de naranjas cierto ahí está y en la de validación exactamente lo mismo manzanas imágenes de manzanas y naranjas imágenes de naranjas sí así que pues bueno es lo que tienen que hacer vamos a esperar a que se termine de instalar las librerías y continuamos listo gente ya se terminó de instalar lo que vienen siendo todas las librerías así que ahora lo que vamos a hacer es que vamos a almacenar la dirección de las imágenes entonces voy a ver por acá y lo voy a pegar lo voy a hacer de esta manera para no demorar me mucho tiempo escribiendo el texto porque tenemos que añadir la dirección de las imágenes porque vamos a almacenar todas las imágenes en en una lista vamos a almacenar en una lista las imágenes de entrenamiento y sus respectivas etiquetas y en otra lista las imágenes de validación y sus respectivas etiquetas entonces por eso llamamos a la librería osh así que a partir de aquí lo que vamos a establecer son los parámetros del ancho y el alto de las imágenes y también pues vamos a crear las listas de entrenamiento para almacenar las fotos y las etiquetas estas direcciones esa dirección que yo tengo aquí está el programa pasado así que voy a cambiar aquí una cosita [Música] listo ahí lo tenemos entonces esos son los parámetros simplemente son las listas donde vamos almacenar las etiquetas y las fotos entonces vamos a crear lo que viene siendo el 2 foro con el fin de pues bueno de extraer las imágenes de entrenamiento y asignarle un respecto una respectiva etiqueta que hasta antes esto lo que hacemos en estos dos foros y después lo vamos a hacer con el de validación entonces vamos a crear un nuevo foro para esto en realidad se podría dar con un solo foro pero yo lo hago así para que ustedes pues bueno vayan entendiendo para qué es cada cosa entonces aquí extraemos las imágenes de entrenamiento de las almacenamos en una lista y le asignamos etiquetas en este caso serios para manzana y uno es para naranja y lo mismo para las imágenes de validación la salvación amos en una nueva en una lista y 0 es para manzana y uno es para naranja así que ahora lo que tenemos que hacer es normalizar las imágenes como así que normalizar las imágenes bueno lo que vamos a hacer es que vamos a dejar las imágenes en escala de grises pero en vez de tener un valor entre 0 y 200 5 vamos a tener un valor entre 0 y 1 ciento de donde ser es negro y uno es blanco y vamos a tener unos valores flotantes en medio que pertenecen pues a [Música] a la escala de grises como tal también vamos a pasar las listas de lista a un array aún a una matriz porque así no lo piden en las redes neuronales no no lo y lo entregamos comer como como listas nos va a generar un error así que eso no es lo que queremos a continuación lo que queremos hacer es que queremos digamos que modificar un poquito las imágenes si ustedes notan tenemos aquí las imágenes de manzana no sé qué no sé qué pero si nosotros modificamos un poco las imágenes las rotamos le generamos cierta distorsión nuestro a nuestro modelo no va a tener algo que se llama sobre ajuste y es que en el entrenamiento va a ir súper bien va a tener una eficacia muy alta pero en la validación va a tener una eficacia muy baja quiere decir que en el entrenamiento súper bien pero en la vida real superman entonces eso no es lo que queremos queremos que no tome siempre las mismas imágenes para entrenamiento y que no siempre venda las imágenes de entrenamiento de memoria por decirlo alguna manera sino que simplemente sepa de verdad que es una manzana y que es una naranja entonces para evitar este fenómeno vamos a modificar las imágenes entonces utilizamos el generador de imágenes de tensor flow quisiste que ustedes están observando aquí y lo vamos a pegar por acá entonces simplemente decimos esto lo voy a ahorrar porque yo no lo necesitamos simplemente decimos lo siguiente decimos que genere una rotación aleatoria en las imágenes que mueva la imagen a los lados que movemos en de arriba a abajo es todo esto es aleatorio o sea no es que lo hagan todas las madres sino en algunas y en otras no para generar pues velo como esa sensación de realismo cierto de que está en la vida real el entrenamiento aquí que inclinen la imagen unos 15 grados aquí que hagas tú que lo acerque que lo aleje etcétera etcétera aquí que gire haga giros aleatorios verticales y giros área aleatorios horizontales entes básicamente es volver esas imágenes una nada así que vamos a imaginar vamos a ver un poquito cómo vendría siendo bueno cómo quedarían las imágenes entonces les voy a mostrar por acá cómo quedaría las imágenes básicamente decimos que tomé todo lo que está esto es imagen 30 hasta entonces que tome todas las fotos y les realicen pues bueno todas estas operaciones y este por simplemente es para observar algunas imágenes en pues aquí cierto cuando nosotros ejecutemos entonces vamos a ejecutar para observar cómo quedarían esas imágenes así distorsionadas para nosotros observar si es lo que queremos o no es lo que queremos les esperamos unos segunditos y vamos a observar cómo quedarían esas imágenes distorsionadas aquí tenemos las imágenes pues correcta cierto tal cual naturales por decirle algo de manera y ahorita las vamos a ver después desde el proceso de transformación con el fin de que no se genere ese es ese fenómeno que se llama sobre ajuste también vamos a observar él el que el comportamiento de las redes neuronales a medida que se va entrenando y se va validando bueno aquí lo tenemos de momento no tenemos ningún error y podemos observar aquí las imágenes transformadas entonces miren que están rodadas y dadas aquí esta tiene un cierto zoom sí como pueden observar esto es para que la nuestra red neuronal aprenda bien básicamente así que a partir de aquí vamos a empezar a crear nuestras redes neuronales vamos a empezar con nuestra capa densa entonces vamos a empezar que con esta capa densa no con nuestra red neuronal densa esta red neuronal como ustedes puede observar no tiene capa de convolución ni capa de agrupación entonces es una red neuronal para problemas numéricos para eso no funciona también en imágenes entonces que lo que hacemos decimos que es una red neuronal secuencial y decimos que vamos a ingresar una imagen de 200 x 200 para que ya prepare las 40 mil neuronas que nosotros necesitamos creamos una primera capa densa con ciento ciento 150 neuronas y activación reloj otra segunda capa densa con 150 neuronas y activación reloj y por último una última capa con una neurona y aquí sí este va a ser el modelo denso ahorita vamos a pasar al modelo de red neuronal convolución al entonces el modelo de capas convolución a les decimos que es una red neuronal secuencial y empezamos con nuestra primera capa de convolución donde queremos que tenga en 32 convolución es con un kernel de 3 x 3 activación reloj y le decimos que van a ingresar imágenes de 200 x 200 píxeles con un solo canal eso es para imágenes en escala de grises hacemos nuestra capa de agrupación establecimos nuestra capa de agrupación pasamos a nuestra segunda capa de convolución segunda capa de agrupación tercera capa de convolución y tercera capa de agrupación pueden observar o puede agregar cuantas sea necesario siempre y cuando nos funcione oyeron y por último agregamos las capas densas de clasificación que serían una una sola capital densa de 256 neuronas con activación reloj y una última capa de salida con activación sin móvil y por último vamos a establecer una red neuronal convolución al con drop out que es drop out el drop out básicamente es apagar y prender la mitad de las conexiones en cada ciclo entrenamiento para que ella encuentre caminos diferentes y no siempre se aprenda el mismo camino entonces aquí es donde establecemos el drop out si ustedes observan tenemos exactamente las más capas de convolución y agrupación solamente que agregamos una el drop out cierto antes que se apague en la mitad de las conexiones en este entrenamiento y en el próximo entrenamiento se apaguen otra otra el otro 50% y así sucesivamente se van alternando así que a partir de aquí lo que vamos a hacer es compilar los modelos y agregar lo que viene siendo en nuestra función de pérdida y el optimizador entonces tenemos un optimizador a adam y agregamos una función de pérdida que básicamente es binner y cross entre sí así que a partir de aquí vamos a observar y vamos a entrenar nuestras nuestras redes neuronales convolución al es entonces como lo hacemos vamos a pegar esto aquí les voy a mostrar le va a aplicar para que no es nada del otro mundo empezamos con el modelo denso entonces el modelo denso le decimos que vamos a utilizar el tensor board que es el comportamiento d de la red neuronal en su en su entrenamiento ya que nos muestra el comportamiento de ella le decimos le entregamos las imágenes de entrenamiento que ustedes como pueden observar son las que tenemos aquí en imagen 30 si es imagen en tren va a ser igual a imagen tren flow las fotos y las etiquetas con un lote de 32 cierto entonces simplemente entregamos las imágenes de entrenamiento entregamos el lote y le entregamos los datos de validación que recuerden que éstos y los almacenamos en unas listas que después pasamos a matrices entre sí de a fotos dos etiquetas dos porque si notan aquí en las imágenes de variación asignamos a fotos dos las imágenes en escala de grises y etiquetas dos si las etiquetas entonces simplemente agregamos esto decimos que agassi en ciclos de [Música] de entrenamiento invalidación 100 epoxy que llame o que almacene en board en su el entrenamiento de la neurona y bueno esto ya van ya básicamente son los steps por epoc y la validación de steps que son dos variables que tenemos que declarar obligatoriamente sean un poquito feas pero pues bueno y en lo que hacemos aquí es guardar el modelo entonces guardamos el clasificador denso y es exactamente lo mismo para la red neuronal convolución a los seis observan que es exactamente lo mismo solamente que cambiamos pues el nombre en el momento de guardarlo y pues cambiamos el nombre de la de donde mantenemos el entrenamiento el comportamiento del entrenamiento y lo mismo para la red neuronal convolución al control out que fue la que mejor se comportó así que lo que vamos a hacer es ejecutarlo pero antes recuerden que tenemos que cambiar nuestras nuestras direcciones entonces vamos a copiar esta dirección que está aquí y vamos a pegarla acá pegarla aquí pero solamente queremos que lo deje hasta vídeo y que no se inventaba taselli nice copiamos esto y lo pegamos aquí vamos a ver si tenemos algún error si tenemos algún error lo corregimos y si no pasamos a ver el entrenamiento de las neuronas como tal ejecutamos y bueno como podéis observar se empieza a entrenar la red neuronal como tal esto sea demorar bastante tiempo porque son tres redes neuronales así que pues bueno no hacer un corte del vídeo y les voy a mostrar el comportamiento de las redes neuronales como tal listo intensa volvimos entonces ahorita vamos a ver el comportamiento de las redes neuronales así que vamos a utilizar el tensor board que tanto habíamos dicho entonces cómo se utiliza el tensor board ustedes simplemente van a llegar y van a abrir su símbolo de sistema simplemente van a aquí cmd van al explorador de windows embedded y van a copiar lo siguiente tensor board espacio -- log de ir igual y aquí van a colocar hoy la dirección donde ustedes almacenaron pues estos tensor board desbaste board en soft board cnn y hbo arce nn 2 entonces le vamos a dar enter y él lo que va a hacer es que nos va a entregar un una dirección web cierto entonces apenas nos entrega esa dirección web vamos a ir abriendo nuestro explorador bla vamos a pegar ahí y vamos a analizar el comportamiento de nuestras redes neuronales lista de intentos ya tenemos el http que es este que tenemos aquí entonces lo vamos a seleccionar y lo vamos a pegar acá nos pegamos le damos enter y aquí podemos observar el comportamiento de nuestras redes neuronales entonces vamos a empezar por el principio vamos a quitar esto de aquí vamos a empezar con el modelo de hecho si ustedes pues como ustedes puede observar aquí pero empezamos bastante bien por decirle alguna manera pero pues bueno el naranja es el comportamiento de entrenamiento y el azul el comportamiento de validación como podrán ser para que tuvimos una calle en validación pero pues bueno al final se sé cómo se se recompuso y obtuvimos un una eficacia del 64 69 por ciento como pueden observar no es lo mejor del mundo y aquí tenemos la función de pérdida donde empezó bastante alto y fue corrigiendo corrigiendo corriendo pero nunca aprendió nada más ya siempre se mantuvo en 0. 5 nuestra función de pérdida en el 50 por ciento de pérdida que es bastante malo ahora vamos a pasar con nuestra rendón al convolución al síndrome auto y como puede observar empezó bastante mal por decirlo alguna manera al entrenamiento de la validación empezó bien y fue aumentando aumentando aumentando y fue aprendiendo aprendiendo aprendiendo que podemos observar con esta pendiente de la recta que si hubiésemos dejado más y en pocas pues ya hoy se seguirá aprendiendo aprendiendo aprendiendo terminó en un 84 por ciento de eficacia así que bastante bien y como consecuencia de eso de quién fue aprendiendo aprendiendo aprendiendo su función de pérdida fue bajando bajando bajando esto también nos indica que si hubiésemos dejado más épocas 2b no hubiese aprendido más y hubiese tenido menos errores ahorita vamos a ver nuestra red neuronal con drop out como pueden ver fue la que aprendió como más rápido y sigue teniendo está pendiente digamos que al alza entonces lo mismo si hubiésemos dejado más épocas pues hubiese aprendido más y tenemos un 83% efectividad que está bastante bien y pues su función de error cada vez se fue minimizando cause fue minimizando minimizando cada vez más bueno amigos se me olvida la parte más importante que es la parte de la predicción porque pues bueno entregamos el modelo para que utilizarlo de alguna manera es algo muy sencillo donde importamos las mismas librerías que ustedes van a observar es más la librería más los lee no es necesaria y lo que hacemos es pues bueno especificar las direcciones donde están nuestros modelos en este caso asignen tres variables modelo denso red neuronal convolución alumno y red neuronal convolución al 2 asignamos a una variable digamos que cargar ese modelo entonces sloan model y bueno te efe punto que eras punto models punto load móvil y asignamos la dirección como puede observar esto de los pesos no es necesario es más lo vamos a borrar para que ustedes vean que no es necesario y qué aumentará si es necesario si es necesario si es necesario ya regular bebé bueno a partir de ahí lo que hacemos es asignar los pesos de cada red neuronal pues bueno a cada acá variable que contiene la red neuronal como tal entonces asignamos esos los pesos del modelo denso los pesos de la red neuronal convolución al 1 y los pesos de la red neuronal convolución el 2 aparte desde aquí creamos una vídeo captura y creamos un well truck lo mismo de todos los vídeos leemos los fotogramas pasamos los fotogramas a escala de grises porque nosotros entrenamos nuestro modelo en escala de grises realizamos el redimensionamiento de 200 x 200 igual que lo entrenamos y normalizamos las imágenes quiere decir que ya no están de 0 255 sino de 0 a 1 cierto y lo que tenemos que hacer es entregarle una matriz al modelo porque nosotros le entregamos una matriz entonces pasamos la imagen de pues utilizamos esta función de conversión de imagen a matriz y le entregamos la imagen en escala de grises agregamos un nuevo eje y lo que hacemos es realizar la predicción entonces eso está como un vector dentro del vector dentro del vector en tres extremos del primer vector y extraemos en el primer vector de nuevo para la presión y simplemente preguntamos si la presión es menor o igual a 0. 5 es porque estamos cerca 0 quiere decir que estamos hablando de una manzana hoy lo contrario estamos hablando de una naranja mostramos los fotogramas y ya estaría ejecutamos esto por acá pero me traigo la manzana y la naranja y yo o no y pues bueno así es como funciona básicamente otros warney molestos pero como pueden observar a ver estamos con el la red neuronal con droga contra out entonces cómo puede observar esta funciona bastante bien es bastante bastante precisa podemos moverla mover la mano y aún así ya sí que prediciendo que es la manzana y lo mismo pues con la naranja en un momento nos dice que es una manzana así que pues bueno a gente ahorita sí está les haya gustado el vídeo ahora para que si llegamos a 10.