[Música] perfeito pessoal eh dá dá um contexto para vocês o que que é essa parada pessoal eh O que que é essa parada do rag E quando é que a gente tá tá utilizando ela eh basicamente o o winterberg deu deu um exemplo no caso dele de pegar um a uma documentação de de suporte e você imputar lá fazer um um banco de dados Vetorial em cima disso para você poder tá utilizando né Eh por não utilizar isso diretamente no prompt por exemplo tu não poderia eh Winter passar essas informações diretamente no prompt Por que
tu não faria isso tamanho né Principalmente primeira coisa tamanho segundo complexidade de manutenção perfeito perfeito complexidade de manutenção e cara eu vou te falar aqui dois pontos a serem levado em conta Porque eh vocês T que evitar adicionar informações excessivas no prpt de vocês eh Então pessoal o primeiro ponto é a questão do do custo mesmo então vocês Imagino que vocês já tem Tem essa ciência né que o custo que vocês têm Vocês foram lá no site da da pna vocês vão ver lá que cada modelo tem eh um curto de X a cada 1
milhão de token a aquele 1 milhão de token é basicamente a tua entrada o texto que você insere para ele o texto que você insere tá Basicamente contido o seu prompt a sua pergunta mesmo a entrada mesmo que você manda paraa II e se você tiver mandando histórico de mensagens todo histórico entra como input Então são esses três itens eh mais a saída da ai tudo isso são os tokens E aí teu custo associado a todas essas informações e obviamente quanto maior teu prompt maior vai ser esse custo o teu o teu eh se você
tiver com histórico habilitado né o teu prompt ele já começa quanto maior teu prompt Maior teu custo já de cara e ele vai aumentando com o tempo né basicamente eh então eh tem essa primeira questão do do do do custo né então se tu quiser pegar toda a documentação de uma empresa tu tem assim 1000 2000 páginas de documentação para para subir seria seria bem caro tu inserir todas essas informações do prompt E além disso pessoal além de ser simplesmente caro existe uma questão eh da das eais que é o conceito de janela de contexto
a Janela de contexto pessoal todos os modelos tem tem janela de de de contexto que é uma característica fundamental das EA é das eais que eu digo da das dos large language models né das llms Então pessoal eh e e pela própria arquitetura da das llms necessariamente elas vão ter essa questão da da janela de contexto que a quantidade de informação que ela consegue permanecer coerente para vocês entenderem isso pessoal é é muito importante Eh vocês entenderem como é que essas eis funcionam na prática como é que essas llms são são geradas né O que
que é essa parada que você você vê ah é um modelo de 3 bilhões de parâmetros modelo de 20 bilhões de parâmetros 70 bilhões de parâmetros O que é que diabos é isso esses parâmetros Pessoal estão relacionados diretamente ao o o treinamento desses modelos dos modelos dessa dessas llms e através desses parâmetros ele transforma o teu input no Output é na pergunta que tu faz na na resposta ou se gerada então o que que acontece na prática pessoal os caras pegam o conteúdo da internet como todo e eles formulam uma série de perguntas formulam ele
já tem ele já tem as informações lá ele já tem as informações a partir do momento que você tem tem as informações que você quer então sei lá quem descobriu Brasil pedes Cabal por exemplo a o input é esse input é esse quem descobriu o Brasil e o Output esperado é esse eh Pedro Álvares Cabral aí como é que isso acontece pessoal basicamente eh esse esses 3 bilhões de parâmetros eles pegam essa informação esse input principal e eles fazem eles esses esses parâmetros eles T pesos e a partir de uma série de cálculos matemáticos eles
vão transformar esse input no output numa saída correspondente então basicamente Eles começam definindo pesos plenamente Aleatórios para esses parâmetros então basicamente tu vai pegar o input que a gente descobriu o Brasil vai passar por esses três bilhões de parâmetros e vai sair uma resposta completamente aleatória completamente aleatória eh mas essa resposta completamente aleatória tu repete isso 1 vezes por exemplo e tu vê dessas saídas dessas 1 saídas que tiveram qual dessas 1 saídas ficou entre asos mais parecido com a resposta esperada Qual a resposta esperada eh Pedro Alves Cabral na por input Quem descobriu o
Brasil tu pega esse modelo eh essa esse essa definição aleatória esses 3 milhões de parâmetros com pedos aleatórios que mais chegou perto e tu vai criar uma pequena variação nele tu vai eh criar 1000 Clones deles com pequenas variações com pesos levemente diferentes nesses cálculos matemáticos E aí tu vai gerar mais uma geração tu vai gerar isso fazer isso que acontecer mais 1 vezes E aí tu vai pegar o novo Vencedor o que teve uma resposta completamente aleatória ainda não dá para entender e mas que tá mais parecido com output esperado Pedro al Cabral e
tu vai repetindo esse ciclo geração P geração milhares e milhares de vezes até tu ter um modelo funcional que ele vai pegar o input Quem descobriu o Brasil eh quem descobriu o Brasil Pedro Alves Cabral é assim que que esses modelos funcionam né é estatística multivariada o nome então tu basicamente é é assim Que essas EA são treinadas E essas EA pessoal elas são treinadas como eu comentei com informações que estão disponíveis na internet então sempre um input vai gerar um output e por pela própria forma que a essas ferramentas são são construídas pessoal elas
acabam entrando e elas têm característica né esses lms todas as lms no mercado da Open da antropico do Gemini do grock ETC elas funcionam dessa forma que é o que eu compartilhei com vocês por essa Característica pessoal desse desses modelos existe essa questão da janela de contexto e o que é que é a janela de contexto a janela de contexto é basicamente a quantidade de informação que pode ter no histórico da eii para ela permanecer coerente Então os modelos da da openni por exemplo tem uma janela de de contexto de 64.000 tokens por exemplo eh
tokens O que que é tokens né Eh tokens é com uma conversão que funciona para as llms né então Eh bora Fazer aqui uma abstração dizer que cada token é uma sílaba Não exatamente assim mas bora bora fazer essa essa extrapolação então Digamos que os modelos Open aceitem na janela de contexto 64.000 sílabas aí o que que acontece pessoal basicamente é se tu tem um longo histórico de mensagens que tu foi trocando lá a ideia com com a II e tu passou informação lá no início lá no início da tua da tua conversa que tu
Explicou falou para ela que teu nome é Pedro e depois de de já passou mais de 80.000 tokens de conversa mais de 880.000 sílabas de conversa tu perguntou de novo qual é meu nome essa informação já extrapolou da janela de contexto Então por mais que você passa essa informação input pela pela simples forma que os modelos que o modelo é treinado que ele é gerado né ele pega o input passam nesses 70 bilhões de parâmetros e geram output E e essa arquitetura desses Modelos é incapaz de entender contexto infinito tu não pode pegar uma Bíblia
inteira de um lado e pedir um output gigantesco do outro lado que ela se perde ela não consegue manter a coerência e o que que é a coerência pessoal a coerência é justamente isso ela corresponder de forma humana o input corresponder ao output eh parecido com com a com a a a a linguagem humana né que eh os L linga de modas tentam tentam corresponder a essa linguagem humana né Então esse essa é a ideia da janela de contexto então da Open e são 64.000 tokens da Cloud é 128.000 tokens do Gemini a gente tá
falando foi o que teve uma maior Jal de contexto estamos falando de 1 milhão de tokens Eh mas você pode ver que por exemplo o geminii ele tem essa característica de é o modelo que mais aguenta eh tem uma maior quantidade de tokens que ele aguenta todavia eh muita gente não gosta da das respostas do germini e da Google que Parece que ele não é muito conciso que ele gera começa a falar demais gera respostas muitoo longas para perguntas Super simples e isso é uma característica do seu da forma de Treinamento eh às vezes eles
priorizaram uma g de contexto mais alta e isso acaba retornando em um output determinado com características determinadas né então beleza pessoal e isso é janela de contexto E aí eh o que o que de onde é que surgiu o Rag né eh R returner retriever argument né do o o a a a a informação completa essa essa essa questão pessoal Surgiu da necessidade de passar mais informações pra Iai Então o que acontece eu eu tenho um colega por exemplo que ele fechou com o escritório de advocacia esse escritório de advocacia para vocês terem terem uma
noção eles operam em quatro línguas diferentes tinha na base de quatro Tera de informação para para passar no contexto da iia quatro téa Vocês se perguntam quatro téria é viável de passar em prompt de forma nenhuma tá ligado de forma nenhuma é é viável de forma nenhuma passar ess essas informações em prompt então Eh e o rag ele surge para isso né Eh e o que que é esse decho do rag e é muito importante eu transmitir esse conceito para vocês eu essa essa Live é é um spoiler do assunto que a gente vai abordar
na próxima semana do fluxo que eu vou apresentar para vocês daqui a pouquinho Que a gente vai tá tá abordando mas o rag pessoal é é importante vocês saberem como é que o rag funciona e PR vocês poderem usar ele corretamente porque pessoal o que eu mais vejo É principalmente a gente que usa low code né a gente usa ferramentas que simplificam a nossa vida a gente muitas vezes acha que é só jogar o documento lá eh joga o documento acho que vai funcionar perfeitamente acho que é isso aí tem lá um negócio de Chunk
etc nem Sei o que que significa põe um valor aleatório Mas beleza povo como é como é que como é que esse rag funciona e por que ela soluciona essa esse quesito essa questão do da janela de contexto então basicamente pessoal eh eu vou ter que explicar primeiramente o conceito de eh o conceito de banco de dados vetorial para vocês então o que que é um banco de dados vetoriais o reg pessoal é uma uma técnica né para buscar informações recuperar informações de um Banco de dados vetorial e o que é que é um banco
de dados vetorial ele é basicamente eu quero que vocês tentem imaginar um gráfico eh um gráfico por exemplo de uma única dimensão uma única dimensão uma linha reta Então tem o a bolinha lá no mundo de uma dimensão o que que ela pode fazer ela pode ir pra esquerda ela pode para direit isso é isso é a única dimensão único vetor né na física a gente trata vetores como como dimensões então vetor É um valor valor por exemplo de de zer a um né pode ser e 0.6 0.7 0.8 e ele vai dizer a posição
dessa bolinha por exemplo Então ela pode tá 06 paraa direita eh 07 08 etc e aí a gente pode criar uma segunda dimensão então além da gente ter a dimensão de largura eu vou dar a dimensão de altura Então ela pode ter vai ter o vetor então ela vai est no 06 na direita e ela vai tá no 04 de altura então a posição dela vai estar aqui então a gente tem tipo uma folha de Papel para trabalhar isso são duas dimensões três dimensões pessoal a gente tá tratando de é a dimensão Nossa do no
nosso universo tem três dimensões espaciais então além de altura e largura agora a gente vai ter profundidade agora a gente vai ter uma profundidade a ser trabalhada então basicamente eh se eu for passar minhas coordenadas para vocês eu vou estar passando minha minha latitude minha longitude e a minha altitude então eu tô na na altitude sei Lá nível do Oceano né moro aqui em Fortaleza literal tô a nível do Oceano e eu tô na altitude logitude de Fortaleza são três coordenadas que eu tenho que passar se vocês quiserem aqui me me achar então então é
isso são três coordenadas a gente tá trabalhando Pessoal esse em banco de dados multivet orial a gente tá falando 536 dimensões por eh 1536 dimensões eh o exemplo aqui que eu vou apresentar para vocês é de 1024 dimensões então Eh nem consigo apresentar para vocês o nosso universo só tem três dimensões espaciais para apresentar mas a gente tá falando em vez de ser três um uma dimensão um pontinho que tá em três dimensões a gente tá falando de 1000 dimensões tá ligado Então é uma precisão bem interessante e e e eh não tem como apresentar
uma imagem para vocês quanto a isso isso faz sentido matematicamente mas é difícil de de visualizar essa parada aí o que que que acontece pessoal Existem modelos da mesma forma que existem os modelos das lms né que transformam um input no output Existem os modelos de egens existe os modelos de egem da da da Open da da Gina da da Hero vários modelos de ens e o que que são modelos de ens ens ele ele pega o input a qualquer informação de texto que você passar para ele Olá tudo bem Como você está hoje isso
é uma informação e após passar o modelo de ele transformar essa Entrada em um output que são coordenadas e no caso de um modelo de 124.000 dimensões ele vai dar e a dimensão dele segundo Aquele modelo de ens onde é que ele estaria nesse nesse banco de dados vetorial ele daria uma posição para para isso e e agora eu vou começar a explicar de fato o que que é o rag Então pessoal agora que eu já expliquei esses conceitos é basicamente pessoal a gente vai pegar documentos milhares de documentos etc a gente vai pegar esses
Documentos e quebrar essas informações em vetores essa esses vetores pessoal é essencial que esses vetores tenham Que tipo de informação lá dentro esses vetores eles precisam ter a resposta do usuário ele precisa ter a informação que o que o usuário precisa então eu fiz um bitfy e botei lá tem tem um vetor lá de quem fundou bitfy fui eu Mateus eh isso é informação que não tá disponível publicamente na na internet como tá massivamente distribuída na internet se Eu perguntar para openni quem fundou a bitfy ela não vai saber responder E aí nesse nesse tipo
de caso que entra justamente é o rag então eu crio um vetor que vai ter essa informação de quem quem quem fundou a bitfy e guardo ele essa informação meu banco de dados vetorial ele vai ser um pontinho nesse banco de dados vetorial E aí basicamente o reg pessoal essa esse essa essa busca basicamente ela vai pegar a Carry a pergunta do usuário Tipo quem fundou AB Bitfy ele vai fazer um embag e ele vai ou seja agora esse essa pergunta virou um ponto virou um ponto e eu vou pegar agora que eu tenho esse
ponto eu vou pegar os pontos que estão mais próximos do meu banco de dados vetorial Então eu tenho esse ponto que é a pergunta do meu usuário e eu Vou extrair os pontos que estão mais próximos dele Essa é a parada mágica do pessoal é diferente de eu fazer uma Busca um banco de dados por palavra chave se você já fez isso num banco de dados grande você faz uma lá ele vai processando el vai carregando todas as informações uma a uma para tentar achar informação isso Além de demandar muito poder de processamento ela não
tem uma correlação semântica O que que é uma correlação semântica se eu pegar por exemplo eh o o a palavra mesa se eu pego a palavra mesa eh e no meu banco de dados Tá a palavra table M em inglês e eu faço uma busca por palavra-chave ele não vai achar não vai ter correspondência no meu banco de dados todavia semanticamente pessoal table e mesa são a mesma coisa são sinônimos semanticamente o o valor de embem o a o posição dela no banco de dados vetorial é extremamente próxima porque semanticamente é praticamente a mesma coisa
então é essa é a parada do do imagin eu consigo extrair múltiplos Vetores eu consigo extrair múltiplos vetores eh que tão que fazem sentido estão são coerentes com a com a minha solicitação que tão mais próximos da da minha solicitação eh semanticamente falando então é é é isso basicamente Esse é o processo de de rag e e agora que que eu cheguei nesse ponto eh eu vou chegar no ponto de O que é um vetor bem feito o que é um vetor bem feito então pessoal eh muita a maioria dessas ferramentas que que cria vetor
para Vocês o próprio floatify etc o Defy ainda tem a questão de criar em perguntas e respostas Mas o modelo padrão ele geralmente só pega aquele texto para ficar mais vitativa eu vou compartilhar a tela aqui para vocês verem beleza pessoal eh Vou importar aqui um documento peguei esse documento aqui e aqui ele começa a dividir em vetores quando eu vou dividir aqui em vetores pessoal ele me dá algumas opções de de Tratativa então por exemplo tem esse automático que ele divide por ponto tem esse personalizado que ele vai me permitir ó que eu tô
dizendo aqui quero que identifique um segmento por quebra de de linha dupla eu quero que o o fragmento tenha no máximo 500 500 caracteres e eu quero que ele tenha uma sobreposição de 50 caracteres é isso daqui eu ainda posso fazer um tratamento para ele substituir espaços excluir urls emails etc Eh sobreposição é interessante pessoal porque quando você faz esse esses cortes secos assim só só vai cortando eh acaba pessoal que eh muitas vezes tu pode perder uma informação lá dentro por isso que se tu for usar essa técnica eu não recomendo vou passar outra
técnica para vocês que eu recomendo que vocês usem é essencial vocês botarem uma sobreposição que geralmente é interessante de 10 a 20% depende do teu caso de uso para ele poder para quando ele for buscar o vetor Às vezes um vetor complement outro e você consegue ter a resposta qual é o tamanho correto dos fragmentos pessoal o o tamanho correto dos seus fragmentos Depende muito do do conteúdo que você vai est transformando em manco de dados vetorial então explicações mais longas mais densas Eh que que necessariamente exigem mais caracteres se tu botar eh vetores pequenos
de de 20 100 caracteres por exemplo não vai caber essa informação Aqui dentro não vai caber eh o quanto que se for informações mais curtas e diretas mais perguntas de tipo sim ou não coisas mais papum direto ao ponto se tu pegar vetores mais longos e tu fizer essa segmentação vai entrar muito lixo vai entrar muito lixo Então tu não não pode fazer dessa forma tu tem que fazer essa essa vetorização e a forma que tu sabe se se os vetores são de de qualidade é fazendo buscas aqui tem sobre o site Da Apple aqui
por exemplo aí eu posso perguntar Tipo o que que é a Apple por exemplo aqui tá configurado top k top k pessoal para vocês entenderem é a quantidade de vetores que estão tão sendo tão tão buscando então aqui ele trouxe esses três vetores porque top K3 aqui é esse daqui para vocês terem a noção eu já transformei ele o Defy tem uma uma opção Nativa de transformar já No formato de fac de perguntas e respostas eu ativei né então ele vai fazer um um pós-processamento de ai para pegar esses documentos e transformar em fac e
isso é bem interessante eu já vou explicar por que isso é bem interessante eh então ele trouxe aqui três vetores os três vetores que estão mais próximos então ele fez o edens aqui então se eu se eu vi aqui ó configurações fornecedores configuração do modelo sistema modelo de raciocínio Modelo de incorporação modelo de reordenação então o modelo de incorporação aqui ele tá usando o Gin Bins V3 aqui no caso para fazer essa incorporação então ele pegou esses ens eh transformou el em um vetor e ele comparou no meu banco de dados vetorial Quais são os
vetores mais próximos e os vetores mais próximos são esses três e aqui ele ainda traz a nota pra gente aqui teve uma nota de 0.3 uma nota de 0.17 uma nota de 0.13 e às vezes pessoal Esses vetores podem ou não trazer informação que você quer então por exemplo aqui a gente teve notas baixas o que a Apple aqui a gente teve nota de 0.3 e esses vetores vocês vão ver aqui que são lixo ó o que é o Apple intelligence o Apple inteligence refere-se a tecnologia e recursos inteligentes desenvolvidos pela Apple para melhorar a
experiência Única dos seus dispositivos isso aqui ele não não não Respondeu sobre a Apple respondeu sobre o Apple intelligence O que é o propósito do Apple book como a Apple facilita não sei que lá não sei que lá então isso são vetores lixo que só poluem um contexto da i a janela de contexto da II e não agregam na informação final se eu pegar Porque de fato não não tinha um vetor bom para isso não tinha um vetor que explicasse bem o que seria isso mas por exemplo o que é intelligence que a gente já
sabe que que a gente já tem uma Resposta para isso agora a gente já teve um vetor que teve 90% de correlação ou seja um vetor de altíssimo qualidade que traz exatamente o que a gente quer exatamente o que a gente quer e ainda a gente tem aqui ó esse limitar pontuação esse limitar pontuação é interessante para evitar lixo na sua janela de contexto quanto quanto mais lixo você injeta na sua de de contexto mais chance dai alucinar mais caro fica seu prompt e menos coerente fica o a interação com a Iai se você limita
a pontuação aqui em 05 por exemplo por mais que o top k ele seja três se eu fizer aqui a a pesquisa vetorial surpreendentemente Não veio nada era para para ter vindo no caso aqui tá vindo aqui e se eu ponho limitar a pontuação e eu ponho 03 por exemplo boa deu algum tipo de bugzinho mas se eu ponho 0 botar 0,80 0,76 aqui ele tá abaixo de acima de 42 Né aqui tá Tá diferente e aí ele era para pegar só aquele Apple intelligence por algum motivo tá bugado aqui agora foi em 039 ele
tá pegando só o só o Apple intelligence Tem algum tipo de debug enfim tá beleza pessal T isso em vista eu preciso transmitir para vocês o conceito de o que que seria um bom vetor um bom vetor ele precisa ter duas duas questões principais tá ligado eles ele Precisa ter necessariamente e a informação a ser buscada então ele precisa ter ele precisa ser semanticamente próximo da pergunta do usuário e ele precisa conter a resposta pro contexto da i e justamente por essa característica de isso é é um bom vetor por essa característica o é muito
interessante eu gosto muito de usar e é o recomendado que vocês usem sempre que possível vetores no formato de fac vocês façam processamento de ai ou no caso de Um projeto que não tem um banco de dados vetorial muito grande vocês mesmo montem o fac perguntas e respostas solicitem pro cliente e perguntas e respostas mais comuns Por que que o fac é perfeito pessoal porque o fac ele vai ter exatamente a pergunta do cara e ele vai ter exatamente a resposta que a i precisa do contexto sem firula exatamente sem poluir contexto exatamente a informação
necessária então a nota vai dar altíssima quando tá no Formato de fac vai dar uma alta correspondência e vai trazer exatamente as informações que a i precisa para responder isso é um bom vetor pessoal isso é um bom vetor então vetores que não correspondem is que tipo tem informação a menos informação a mais são vetores de baixa qualidade e vão entregar um rag igualmente de baixa qualidade e aí pessoal essa última semana eu tava trabalhando num agente que que eu vou mostrar para vocês agora Isso daqui vou est entregando para vocês na próxima semana tá
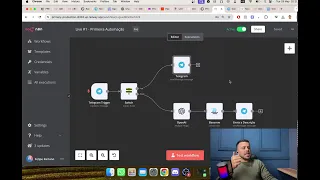
Fiz o mínimo para para fazer funcional o bagulho ainda tá tá feião mas explicar para vocês o que que parada faz que era a questão que eu tava buscando fazer eh e fazer com qualidade para passar para vocês basicamente Pessoal esse daqui foi é um fluxo ele basicamente cria pra gente esses vetores eh eu posso passar documentos aqui extensos para eles para para esse fluxo E ele vai criar aqui vetores de alta qualidade e o primeiro ponto aqui por exemplo a gente tem um nó da Gini esse Jini pessoal é uma ferramenta fantástica eu já
tô até com com ele aqui aberto aqui só só acessei o Gina não fiz login nem nada só acessei E por incrível que pareça eu acesso aqui Eles já te mostram até tua chave de api aqui tu nem precisa logar Eles já gera uma chave de api baseada sei lá no que no teu teu IP nem Nem sei de onde é que que eles te acessam isso mas o que que que ele tem aqui pessoal então ele tem esse modelo de ens eu expliquei para vocês carens que é pegar uma informação e e transformar em
em e em vetores em coordenadas transformar em um vetor com coordenadas tem esse daqui nem cheguei a explorar ainda tem esse daqui que a gente vai utilizar e ainda tem alguns outros o que é que essa parada aqui p pess basicamente Esse é o modelo de de Scrapping dele para vocês verem como é que é simples velho esse esse modelo de scrapping deles basicamente a única coisa que tu precisa fazer a Curl a autenticação é essa tua chave de api normal e essa aqui a chave de api deles a Curl é http do P bar
r pg.ei e a URL que você precisa acessar qualquer coisa que você faça isso ele já vai fazer o scrapping completo para vocês eu vou mostrar um exemplo para vocês eu vou fazer um scrap do que que eu faço vou Pegar o site do NN beleza eu literalmente venho aqui escrevo http 2R bar. dou enter e ele vai fazer o scraping completo da minha página da da página do NN aqui ó perfeitamente lindamente ele faz isso ele faz isso não apenas para sites que já é maravilhoso ele faz para para documentos pdfs por exemplo faz
para uma série de questões eh documento texto tudo então basicamente o eu vou est fazendo uma uma t para ele da mesma forma que eu fiz Aquele to de gerenciamento de v Store eu vou implementar eh essa parada também que tu vai passar o próprio eh o próprio shot né quando você passa qualquer informação para ele ele já transforma isso ele armazena isso no S3 gera um link para você eu consigo passar esse link pro Gina e ele consegue fazer o scrapping na página fizemos aqui esse scrap beleza e eu fiz esse esse code aqui
esse code Ele vai dividir ele vai basicamente dividir esse texto em blocos menores eh a a o a questão do tamanho do bloco vai depender principalmente da do modelo que você quis for utilizar aqui eu tô usando Eh comecei usando 4 o aí eu quis dar tava dando um ótimo resultado mas eu queria ter um resultado melhor ainda a partir do momento que você cria eh você gasta Token para fazer um imagem pessoal é do site inteiro eh José Paulo faz de do site inteiro E ainda tem se eu não me engano ainda tem parâmetros
para fazer busca em subpáginas aqui ele pega só da página página inteira né mas se eu quiser pegar em subpáginas eu ainda se eu não me engano ainda tem parâmetros que ele vai atrás de buscar subpáginas e fazer scraping de subpáginas é muito bom e genial né pai beleza então Eh aqui eu fiz divisões de 1500 de de cada segmento vai ter no máximo 1500 e eu ainda botei um overlap de 15% então Ele vai ter uma sobreposição de de 15% em cada bloco E aí pessoal eu passo isso num loop e nesse loop tem
um extrator de um information extractor né um extrator de parâmetros da mesma forma que vocês já tão familiarizados tem lá notify também mas que que essa parada faz pessoal aqui eu ponho o segmento e aqui ele vai me trazer algo que eu não tenho não tenho a possibilidade de fazer isso no no dy e por isso que eu tô fazendo aqui direto No mas aqui ele vai transformar aquele input em em perguntas e respostas no formato de fac e ele vai trazer a pergunta a pergunta ele vai trazer a question em inglês ele vai trazer
sim perguntas similares Porque apesar de de o próprio formato do ele funcionar dessa forma que eu comentei com vocês que table tem um valor semântico muito parecido apesar disso às vees tem uma Variedade de perguntas e respostas para aumentar mais ainda a qualidade desse desse do te Então esse perguntas desses perguntas similares também né a resposta e o trecho específico o trecho específico do do documento e por último ainda pedi para lhe botar algumas tags se eu quiser filtrar por tags Eu também ten essa possibilidade e eu botei todos eles como requeridos para para o
estator buscar por todos esses esses parágrafos Fiz esse prompt para ele entender exatamente como agir como se portar e como escrever essa essas tags como escrever esse essas informações eh ele vai passar aqui eu botei um weight Pessoal esse weight aqui ele é importante Porque dependendo do do modelo que vocês forem utilizar aqui a gente tá usando a Open a Open vocês sabem que eles têm tiar né Quanto mais vocês vão gastando crédito na openi e mais tempo vocês vão utilizando a Ferramenta vocês vão subindo no tiar e esses esses shs eh te possibilitam ter
uma quantidade de requisições cada vez maiores eh Então se tu quiser abrir um SAS e tiver quiser ter 1000 pessoas usando um modelo teu na base do GPT tu não vai conseguir porque tu vai ficar batendo no rate limit deles e vai ficar morrendo nisso eh e por isso que eu botei esse weight aqui esse weight aqui vocês vão botar de acordo com o Tier de vocês então vocês vão fazendo os testes Você vê que um segundo mundo tá pouco aí pode aumentar para 5 10 10 10 segundos para ele não ficar incorrendo nesse rate
limite poder usar à vontade e aqui são são os tokens de fato pessoal para vocês verem o formato então aqui peguei informações da da bitfy então basicamente que a pergunta o que é a bitfy tecnologia educação O que é a bitfy a é perguntas similares né qual é a missão da bitfy qual o serviço da bitfy oferece a bitfy tecnologia Educação lit também conhecida como bitfy é uma empresa que combina tecnologia automação low code inteligência artificial para oferecer soluções inovadoras se que l não sei que lá essa aqui é a resposta essa aqui é o
trecho e essa aqui são as tags e e ele vai fazer isso para todos os segmentos todos os segmentos eh até pela questão da janela de contexto que eu que eu expliquei esse Conceito para vocês no começo aqui da nosso encontro pessoal não adianta eu passar um S gigantesco para ela de cara uma Wikipédia inteira para ela que vai extrapolar a janela de contexto e ela não vai conseguir gerar as perguntas e respostas com qualidade por isso que eu fiz esse code aqui para aqui no caso tô repartindo em blocos de de 1500 caracteres com
um o overlap de 15% para obter qualidade para não extrapolar Jal de contexto e ela poder ter qualidade Nas perguntas e respostas que ela vai estar criando next step próximo próxima etapa pessoal aqui a gente tem um segundo loop que vai fazer o qu esse segundo loop pessoal ele primeiro tem esse esse no cripto aqui ess esse nop pessoal faz algo estupidamente estúpido ele basicamente ele só cria aqui essa data aqui ó ele cria uma umid para você uma um ID né uma uma indicação Única que você pode passar para para informações né no caso
vou utilizar no meus vetores esse I Eid aqui eh e aí eu vou ter que explicar uma questão de Por que a gente tomou esse caminho que eu vou passar para vocês agora e aí eu já vou adiantar aqui algumas atualizações que a gente fez na Ana a gente fez algumas atualizações aqui que vai ficar muito bacana inclusive o Lilo Eu acho que o O Lilo tá tava aqui eu não sei se ele saiu se Tiver aqui L me dá me dá um oi mas peguei Fala aí fala aí Lil peguei alguns eh dei uma
copiada no seu no seu directos Fiz aquele esqueminha que você fez que ficou muito irado mano aí eu tô trazendo aqui pro pessoal do circo perdão aí por copiar sua ideia mas daqui a pouquinho eu mostro para vocês e aí o que que acontece pessoal antes a gente tinha um agente aqui que faz a mesma coisa que esse agente aqui que é um agente especializado em buscar dados Buscar vetores no no manco de dados vetorial esse agente pessoal ele tava funcionando usando ap do dfy ele tava usando AP dfy para buscar esses vetores e trazer
a resposta dar o contexto pro agente principal essa forma pessoal que que foi feita ela é muito interessante eh e é bem interessante que vocês sigam nesse modelo também porque o que que acontece ó é muitas vezes quando a gente Define um top k como um top k de se topk de 10 Ele vai trazer 10 vetores e 10 vetores vai ter um monte de lixo lá dentro Vai ter um monte de porcaria e e aqui olha o que a gente consegue fazer aqui eu botei Vector Store return o retorno da Vector Store e eu
ponho exatamente o retorno da Vector Store então Eh em vez às vezes só um vetor ele vai trazer um pouco de lixo eh ele vai trazer informações que que que não eh que não agregam né vai trazer um pouco de informações lixo aí ele vai aqui Nesse Vector Story return nenhuma informação eh ele vai ele vai trazer literalmente só informação necessária para agregar na janela de contexto eh sem poluir a janela de contexto de nenhuma forma por isso que eu separei em dois agentes primeiro por uma questão de de qualidade na busca então o bacana
desse primeiro agente pessoal é que ele ele tem a capacidade de analisar o input do usuário histórico de conversa e ele consegue fazer Múltiplas perguntas com mensagens diferentes e cada pergunta pode retornar seis eh 10 tokens por exemplo para agregar na resposta então é um agente especializado nisso ele vai fazer múltiplas eh buscas ele vai poluir a janela de contexto dele mas o agente principal que é o que tem um long etc e ele não vai poluir porque aqui ele passa só as informações necessárias para responder que no caso nenuma informação relevante foi encontrada na
base de Dados para auxiliar a resposta se ele não encontrar nada útil ele dá essa resposta padrão então é por isso que eu fiz essa divisão e uma questão pessoal que eu tava insatisfeito em utilizar a api doy na versão eh self hosted na a versão Auto hospedada é que a gente já tava tendo alguns problemas a nível de performance com comfy né e eu fiquei p da vida quando eu fiz uma pergunta super simples e ele demorou e era pergunta de nível tipo bem idiota e ele demorou 29 Segundos para responder que tava naquela
versão antiga que eu passei para vocês até passei com PR release porque eu tava precisando justamente da ajuda de vocês para evoluir pra versão que a gente conseguiu chegar hoje e Então sempre que eu botar PR release é porque não Tô 200% confiante naquela naquela versão não recomendo que vocês e rodem produção quero que vocês me ajudem a testar pra gente chegar numa versão mais lisinha que foi essa que a gente chegou hoje Justment tava tendo esses problemas de performance mesmo por quê Porque a gente tava acessando a api do dfy estamos acessando a api
doy a ap do dfy ela às vezes estava como a gente não tá rodando wify como fluxo mesmo em produção às vezes ela fica em background lá no servidor Então ela tem que meio que reac no servidor e às vezes pode demandar demorar muito tempo para ela responder né como tu tá acessando um serviço dentro da da tua VPS então isso Tava causando um delay que não fazia sentido pessoal não era não era coerente e a solução que que eu encontrei eu fui e pesquisar ver as outras opções de de Vector Store que que tinham
no mercado dei uma olhada se vocês verem aqui nas opções que já tem nativas do do n8n se eu vi aqui é a nard nodes e inct Store Essas são as vect stor que estão disponíveis Então essa tem em Memory né a narrativa do do n8n o Pine con o postag v Store O que é K durante Vector Store superbase Vector Store e o que Vector Store e não só isso pessoal mas os recursos dessas opções são muito limitadas então se eu vou vou clicar aqui no PG vectory Store por exemplo olha as opções que
ele tem ele só tem esses aqui get runet document from vectory Store que é fazer uma Carry para Buscar documentos ele tem esse e retrieval document for ai process que é a mesma coisa é buscar o documento via Carry só que aqui é para conectar num Agente dei aqui é para fazer manual num fluxo e por último adicionar um documento na Vector Store são só três possibilidades três end points só que a gente consegue trabalhar isso limita muito as nossas possibilidades pessoal porque esse fluxo aqui por exemplo que que eu mostrei para vocês eu crio
não crio um documento eu crio o vetor por vetor e eu quero adicionar vetor por vetor quero ter o controle por vetor por vetor se eu Quiser atualizar um vetor eu quero atualizar aquele vetor específico tipo mudei um preço de um produto mudei uma informação eu quero atualizar aquele vetor específico quero recalcular o daquele apenas vetor específico não do documento inteiro e é muito limitado as coisas que que ainda hoje de forma Nativa os mais completos é o picon aqui que tem a única diferença que tem esse update vetor hisor documento atualizar um vetor específico
E aqui no também tem atualizar um vetor específico Esses são os únicos que tem essa opção os outros os outros quro são são bem limitados nem nem atualizar um vetor eu tenho essa possibilidade e eu fui pesquisar dentre as opções que que tem no mercado qual já teria uma ap né que a gente trabalha eu vou aproveitar também essas aulas de de vect hisória para abordar esse assunto com vocês de forma mais aprofundada lá No no círculo mas aqui ó V ST qu qual desses V ST já teria e fácil pra gente trabalhar que que
a gente não teria que acessar o banco de dados eh diretamente então por exemplo se a gente fala do PG Vector ele não tem um api eh o PG Vector é basicamente é o o post agrees né É uma extensão de PG Vector eh que te possibilita armazenar esses vetores mas eu não consigo manipular eles via api nativamente eu poderia Construir um api mas eu não queria construir eu queria al um api já pronto aí a a gente tem por exemplo o suas V Store que ele é em cima do post V Store também não
tem pronto eu posso construir o que das opções que eu analisei pessoal a a mais simples de todas que tem uma API mais fácil de consumir foi justamente o pinecone o pinecone que de fato é a opção do mercado hoje mais mais utilizada mas a que eu olhei de fato pessoal e vi que atendia a gente Perfeitamente era o pinecone e essa daqui que a documentação da AP deles vocês vão ver que é é Super Simples então aqui basicamente pessoal ele tem a parte de de vetores e a parte de index só isso tem um
monte de coisa que que não vem ao caso mas na parte de de index aqui eu posso listar os index que Traduzindo pra linguagem do Defy seria as Vector Stores né seria os datasets na linguagem do do do DEF ele vai listar os os index existentes Ele vai criar um novo index ele vai descrever vai buscar as informações desse desse index vai deletar o index vai configurar o index e eu não sei o que que se faz Bel e e os vetores o pset vetor esse upset ele vai atualizar ou criar um vetor então tu
passa o ID daquele vetor se aquele ID foi existente ele atualiza se ele não foi existente ele cria aqui ele vai fazer uma Carry vai buscar esses vetores aqui ele vai vai buscar os Vetores mas vai buscar não por por correlação semântica né vai buscar ou por palavra-chave por por pela metadata aqui dentro do pinecone update vect Store então atualizar um vetor né deletar um vetor e tá listar os Vector ID basicamente só isso super simples o Def ainda cria uma camada mais de complexidade que dependendo do caso pode ser útil que é a complexidade
do caso de eh a complexidade de ele cria documentos também então por exemplo Tem tem a questão do vai ter a questão do do dataset documentos e Vector ids né no no Defy aqui é mais simples só tem o Database e os vetores os index e os vetores bem bem mais tranquilo dei uma olhada na P deles e eu fui começar a trabalhar ver a eh responsabilidade eh o o no caso aqui pessoal o pinecone ele tem uma característica que alguns de vocês vão gostar e alguns de vocês não vão gostar que ele é a
principal coisa interessante deles pessoal é que ele é Uma ferramenta eh amplamente utilizada no mercado eh a boa parte do dos players grandes utilizam o pinec ele tem um alta disponibilidade alta responsabilidade você cria você pode escolher onde você vai vai aar se vai ser na WS se vai ser no Google se vai ser na azu ele tem essas flexibilidades E no caso eh ele tem um limite gratuito muito bom eh Tu tem uma larga quantidade de uso gratuito para usar eh e depois que você Passa de eh sai desse limite gratuito ele de fato
ele é muito ele não é caro de fato eh ele vale muito a pena tu delegar da mesma forma que a gente tinha optado por delegar naqu dentro da da bitfy eh a gestão do nossos da nossa Database mesmo principal pro superbase pra equipe do do superbase em vez de aut hospedar um serviço extremamente complexo do do superbase eh eu também tô indo caminham de deixar no paric deixar eles cuidarem ter essa tranquilidade eh Informações eh o banco de dados vitorial pessoal é um ativo da da da empresa do do teu da pessoa que tá
prestando serviço como eu dei aquele exemplo amigo meu que fez para quatro térias de de dados eh em quatro línguas diferentes para o escritório de advocacia ele gastou uma nota pessoal nisso a nível de de prompt mesmo de tratamento de processamento com aí eh e também em Bees né ele gastou uma boa nota nisso e não faz sentido você ter que retreinar isso Tudo de novo entende é inclusive uma questão muito salutar deles é que se em qualquer momento você quiser migrar você consegue eh importar eh informações você consegue fazer fazer backup Então você se
você quiser passar essas informações eh utilizando o o pinec depois você quiser me mirar para outro dataset você consegue fazer isso com relativa tranquilidade eh porque isso é de fato um nativo e é é muito importante que você não perca esse Artigo que ele não corrompa etc então na minha visão vale muito a pena tu delegar um ativo que é tão importante para uma empresa boa consolidada que consiga cuidar desse desse ativo seu com você com tranquilidade você não tem que se preocupar com isso e a desvantagem do pinec especificamente para muitos de vocês que
gostam do das opções selfhosted o pinec não é selfhosted então Apesar dele ser gratuito por um uma boa faixa de uso por um bom começo Ele é gratuito ele não é s fost Então você não vai ser dono em si do do código fonte inclusive eles não disponibilizam o código fonte é privado deles eh mas enfim se você quiser depois migrar para outras opções até o pessoal eh passar aqui o o8 e o o zep eh tem que olhar a a documentação de ap deles para ver se atendem e se atenderem vocês também podem Auto
hospedar e vocês têm que se preocupar a nível de vocês tê que Necessariamente se preocupar a nível de de dar manutenção do sistema e garantir que você não vai você vai manter esses dados e eles vão funcionar perfeitamente Então beleza pessoal Seguindo aqui eh Seguindo aqui o que que a gente fez né como eu comentei A gente buscou as perguntas né pergunta principal perguntas secundárias resposta trecho e as Tags o primeiro passo pessoal aqui a gente vai fazer um emagens então a gente faz aqui o imagens eh basicamente aqui eu tô passando o endp aqui
da Open você pode usar o op você pode usar a a própria Gina tem tem várias opções aqui que você pode usar eh autenticação eh autoriz aqui no caso está 100 eu tô utilizando direto aqui no authentication e aqui você vai passar o trecho específico que você quer quer Fazer o in baging e você pode passar também a Dimension né a quantidade de vetores é no caso aqui desse modelo aqui o o text emagens small Trace ele vai ter ele tem de 25 256 dimensões até 372 dimensões quanto mais dimensões Teoricamente mais qualidade né Eh
acaba que a qualidade ela vai ela vai crescendo de forma eh cada cada vez mais decrescente né de forma decrescente com o tempo Então a partir de de de 1224 para 1536 até tem uma evolução bacana mas de 1536 para 372 já não é uma evolução tão tão boa e obviamente o custo disso aumenta então vocês TM que pensar eh vocês T que pensar qual que de fato faz mais sentido para vocês então Eh aqui a gente tá utilizando o modelo da openi para fazer esse esses emagens utilizando aqui m24 dimensões eu até depois vou
aumentar essas dimensões o que eu tava utilizando mais para para Teste mesmo mas eu pretendo pegar o 1 eh aquele de 1500 ou de 3.000 dimensões eh beleza que eu Gero imagens eu vou desconectar aqui só para gerar corretamente então aqui ele passou ele passou dois itens tá agora foi Então pessoal esse aqui é o formato literalmente esses aqui são 1000 dimensões como eu comentei para vocês se vocês quiserem saber onde é que eu tô eu Passo minha minha latitude minha longitude e minha a altitude eh isso seriam três vetores três coordenadas que são 1024
coordenadas é é algo extremamente preciso e difícil de de mensurar eh no nosso Universo de três dimensões Beleza eh ele pegou aqui e aí a gente tem esse esse end Point aqui do esse end Point do do pinecone então ele tá tá inserindo essas informações inclusive pera aí me confir Aqui no servidor da Gina vou da Gina mesmo perfeito aqui esse end Point aqui tu põe a tua a tua URL do pinecone essa seria essa essa URL aqui Vector ups põe a Pake de vocês põe a chave pode botar esse esse valor aqui é opcional
e aqui tu vai passar eh tu vai passar as seguintes informações tu vai passar o ID eh tu pode criar vocês viram que eu criei um ID Mas vocês podem passar um ID existente para atualizar Gina é a irmã da da Ana não a Gina é essa ferramenta de que eu mostrei para vocês que faz a a questão do do Vector Store beleza aqui eu tô passando o ID aqui em valios eu tô passando as coordenadas passando as coordenadas aqui e aqui pessoal eh é outra outra parada que eu tava sentindo muita dificuldade no notify
que notify ele literalmente não Tem pessoal ele não tem a possibilidade de você criar essa meta data tão completa então basicamente eu posso lá adicionar qualquer informação mas aqui eu consigo criar assim qualquer formato de metadata né metadata é um objeto eh um objeto né um objeto JavaScript e eu posso botar dentro dele Strings listas eh eh arrays né listas outros objetos e aí eu consigo aqui botar todas as tags aqui eu consigo botar todas as perguntas aqui No formato de lista também a pergunta principal a resposta o trecho e tudo isso pessoal fica aqui
ó eu D essa Carry aqui ó eh esse é o formato muito mais completo das informações aqui que eu tenho no Picone então aqui eu tenho os valores né as as coordenadas eh aqui eu tenho a resposta a pergunta as perguntas similares o trecho e as tags eh eu posso adicionar qualquer informação de metadata quando vocês Estiverem pegando eh projetos com maor nível de complexidade esse tipo de informação de tu poder filtrar por essas met pessoal começam a ser essenciais então por isso que eu acabei optando por ir mais nesse caminho então beleza e e
aqui a gente faz o o imaging né e aqui a gente fez ens aqui a gente envia e aqui tem um Ezinho só para evitar time out aí vocês põem o limite de vocês e aqui ele vai inserir todos os vetores Basicamente Então se ficou Claro se ficou Claro para entender basicamente que vocês põem a URL do documento que vocês precisam eh http 2 bar r. Ginei bar aurl que vocês querem pegar o documento etc ele vai fazer todo o scrapping ele faz o scrapping eh esse nó aqui ele vai transformar em perguntas e respostas
com altíssima qualidade eh foi deu trabalho para eu ficar satisfeito com isso que eu não tava conseguindo Fazer o bagulho de de qualidade de verdade mas Finalmente consegui fazer essa parada e tô muito feliz com com o resultado e por último ele vai fazer o processo de baging e vai inserir basicamente pessoal eu tô muito satisfeito com essa solução por conta que eu eu tava com ódio do delay que que eu tava tendo anteriormente eu vou mostrar aqui para vocês como tá o delay hoje dessa parada então primeiro que eu fiz uma melhoria no prompt
agora ele não Tá mais consultando por coisas bestas que não tem necessidade então mandar aqui um Olá por exemplo mandei um Olá tá processando aqui Opa bom dia Pedro Tudo tranquilo até foi mais longo do que eu esperava pelo que eu tava fazendo tava mais rápido aqui esse agente que Como falei para vocês chegou a dar 59 segundos aqui a gente tá falando de 170 1713 segundos isso é exceção geralmente estava dando na faixa de 300 400 milos nessa parada e vou fazer um outra pergunta para ver se se volta a entrar idade que dos
Testes que eu tinha feito tudo certo agora voltou tudo certinho e com com você como é que está agora voltou na normalidade na velocidade padrão Beleza se a gente for ver o tempo que esse agente consumiu voltou pra Normalidade dos 500.000 segundos me segundo é o tempo que ele tá demorando para responder isso quando não acesso Vector Store né quando quando não tem necessidade de de acessar o Vector Store usando o grock aqui para ser mais rápido e aqui eu vou fazer uma pergunta pessoal que agora a gente vai ter que acessar a Vector Store
ou seja vai demandar mais tempo e bora ver como é que tá essa latência eu vou perguntar aqui eh quem fundou a Bitfy quem fundou a bitfy a BF Fi finada por Pedro nanciamento e Mateus mebar perfeito 4.7 segundos no total 4.7 segundos no total esse agente aqui Demorou apenas 2000 msos ou seja 2 segundos para para responder para vocês terem noção pessoal se a gente for vir aqui nos logs olha a quantidade de lixo que que vem aqui eu tô retornando se não Eng tô Pedindo cinco ou é se de Top k ou seja
ele pega muitos vetores pega muitos vetores mas a informação que eu quero é só é só é só isso os sonadores da bitfy a São Pedro Nascimento e Mateus é só isso que eu quero é só isso como eu quero só isso de informação eu vou passar s informações adiante para não poluir o prompt do meu agente E se eu vou vir aqui na na Vector Story return eu vou ter só essas Informações ó os fundadores da bitfy S R Nascimento e Mateus meinberg e ele vai utilizar esse agente aqui principal pessoal para responder então
aqui a gente teve eh e a gente foi ver quanto tempo esse ag gente aqui demorou para responder foi 590 msos utilizando aqui eu tô utilizando o que no caso a gente tá usando o GPT 4 om mini aí beleza pessoal uma questão que eu queria é genuinamente o feedback de Vocês eu fiz essa T pessoal eh Eu sempre busco fazer as coisas o na maior otimização possível de de simplicidade e eficiência então quero a coisa mais simples possível para vocês eh e que que resolva o problema que resolv o problema a aí pessoal eu
fiz essa Tour essa T que tá sendo responsável por fazer a busca no Vector stor quando a gente tá tratando do do pinec e desses modelos e desses outros modelos por exemplo o Pinec ele tem uma questão chatinha e que a gente vai est resolvendo isso com com o n8n é que por exemplo eu tenho essee vetor set por exemplo se eu quiser editar e eu editar uma informação aqui eu vou deletar essa informação deletei é esses velhos aqui eles não são alterados não automaticamente eu teria que fazer um novo emagens para atualizar essas informações
e ele voltar a ter a correspondência que ele tinha antes eh aqui eu não tenho como cadastrar um Modelo de imagens para ele ficar fazendo isso automaticamente ao menos não que eu saiba talvez vocês conheçam algum plugin que faça isso mas no meu conhecimento isso não isso não é possível e até aqui como vocês viram nesse fluxo e eu não simplesmente mando o vetor em cim pro prif eu primeiro faço um em bens e depois com valor do BS eu envio pro eu envio pro pro picon E e esse mesmo processo eu tenho que fazer
aqui pessoal na na busca na vect ST então e que o que que que qual o caminho então esse agente aqui se eu vho nesse agente ele vai retornar a a consulta os textos a eh ele vai retornar os os textos a serem buscados na Vector ST então se eu clico aqui aqui ele define isso basicamente um esqueminha super simples texto para o qual geral emagens e pesquisar no pinecone e aqui o texto a ser ser feito a Carry né então ele vai fazer o texto de consulta ele vai passar O texto de consulta aqui
esse texto de consulta eu tenho que fazer a as seguintes etapas eu primeiro tenho que gerar o bagin e usando a Gina usando o open benss e após esse esse primeiro momento eu tenho que pegar esses valores e enviar pro picô para realizar essa busca é isso o que eu tenho que fazer eh tendo que fazer isso pessoal não faz sentido ter duas Tools por exemplo aí ele vai pegar uma Tool para gerar um embs aí o modelo vai ter que escrever Todos esses 1 imagens para para para para gerar a Carry para enviar pro
pro pinec is não seria viável uma possibilidade pessoal teria teria sido talvez vocês tenham essa preferência por fazer um segundo fluxo eh esse segundo fluxo ele ele basicamente acessa tem tem vocês sabem que tem essa Tool que acessa um fluxo externo né que é que a gente tá tá utilizando aqui então a gente tem duas tools que essa event Manager e o Vector Manager Que eles acessam uma T externa com agentes especializados para fazer isso eu poderia eh utilizar essa parada Mas eu gosto de evitar essa essa essas functions que essas essas Tools que acessam
workflow externo Porque na minha visão atrapalha muito na manutenção então tenho que acessar um outro workflow para configurar etc para mim atrapalha bastante e eu gosto de ter tudo num única tela só facilitar minha vida eh Ant antigamente todo o flux Dan tava em único workflow a gente teve que separar muito por questões das execuções mesmo para deixar de poir as execuções Mas eu ainda gostaria de poder ter tudo isso num num uma numa única interface todos os workflows mas não é possível não é possível se a gente quiser ter essa vantagem e aqui pessoal
a forma que eu utilizei foi criar uma Tool de código aqui é um código já script que ele pode parecer um pouco complexo à primeira Vista mas eh eu busquei simplificar ele ao máximo Então o que que ele faz aqui ó eh parâmetro de entrada ele vai buscar o parâmetro de entrada a Carry a ser feito em Bees depois pesquisar no P con aqui eu ponho as credenciais vocês botarem as credenciais de vocês eh nesse segundo aqui ó passo um Geral emagens com Open ai então aqui é o end Point né A URL do do
da Open aqui é o modelo de incorporação aqui é o o texto né de Input que a gente pegou aqui text input aqui as dimensões eh 1024 dimensões e lembrando pessoal que as dimensões vocês têm que usar se vocês geraram inagens com modelo de incorporação e com a quantidade de dimensões para você fazer a busca semântica no no processo do rag vocês T que usar a o mesmo modelo de incorporação mesmo modelo de e a mesma quantidade de dimensões não vai dar incompatibilidade e você não vai ter uma busca semântica de Qualidade então novamente T
passando o mesmo modelo em 3 small da Open o texo de consulta é a quantidade de dimensões e aqui em o cont Type application Jon e authorization tô passando a chave da que eu defini aqui em cima né aqui ele já vai me retornar vai vai me retornar essas informações e aí eu vou paraa segunda etapa consultar o pinecone então aqui eu pego a URL do pinecone Carry né no namespace da da bitfy topal tô definindo Aqui como cinco eh eu tô incluindo o values tô incluindo metadata e eu tô Vector in bings Vector beleza
isso aqui vocês Vocês não precisam mexer eh content Type application Jason e a p que tá definido aqui em cima sem segredo aqui ele faz um filtro nos resultados para que ele ficava retornando os velos que poluíam muito aal de contexto eu tive que fazer esse filtro e aqui ele retorna os dados filtrados fiz o código Mais simples possível é basicamente duas requisições http dentro de um único código JavaScript e que ele faz fazer essa essa vai fazer o embag depois faz buscar da forma mais eficiente possível vocês viram aqui que isso tá ocorreu literalmente
1000 1990 segundos milisegundos extremamente rápido tá funcionando perfeito a gente poderia fazer também acessando um outro workflow Aí teria duas requisições da 4tp uma para fazer emagens outra para fazer a Busca e depois um no de respon para retornar a data só isso Eh eu achei que não valeria a pena fazer um outro nó sair do workflow só para isso achei que seria muito besteira e eu eu preferi essa essa essa possibilidade aí quero depois o feedback de vocês se se tá entendível ou se o código vai mais a a ideia disso pessoal é facilitar
na manutenção que o resultado prático é o mesmo eh mas talvez por ser código talvez atrapalhe Mais na na manutenção do que ajude Então beleza pessoal no mais eh no mais foi isso tô muito feliz is com com a com as respostas com tempo de resposta eh outra adição que a gente fez aqui eu tinha testado na naquela última versão pessoal PR release fazer um agente especializado e em fazer o o o output par de segmentar as respostas Tava tendo resultados bem bem ruins eu tava achando que passar isso pra ai deixaria isso mais natural
mas a prática deixou menos natural e eu Entendi pessoal que a forma mais natural é simplesmente instruir o agente principal que ele tá falando por um dispositivo de mensageria e ele mesmo pessoal ele faz quebra de linha dupla quando é um texto um pouco maior e esse código aqui que eu tô fazendo é um código Super simples ele simplesmente faz um split sempre que tem quebra de linha dupla sem segredo basicamente isso então codigo Zinho super simples fazer esse split contém quebra de linha dupla E nessa forma eh eu tô tendo e repartição das informações
de forma muito mais natural tá tá sendo o ideal dessa forma então a gente tirou o output passa ficou mais simples ficou mais funcional ficou tá tá o ideal essa essa questão de fato