im nächsten kapitel der vorlesung wollen wir uns mit hash verfahren beschäftigen dabei wird es darum gehen in einer menge von daten zu suchen so wie man das bei den such kommen auch schon gemacht haben allerdings wollen noch mal schneller sein wir wollen das einfügen und die suche jetzt möglichst in konstanter zeit schaffen dazu folgende überlegung wir suchen in einer menge von daten jeder eintrag ist charakterisiert durch einen schlüssel die menge aller schlüssel dienen wir k wir stellen uns jetzt vor wir könnten eine funktion f konstruieren die jedem möglichen schlüssel eine natürliche zahl zuordnet und wir
nehmen weiterhin an dass diese funktion die aktiv ist das heißt jeder schlüssel wird genau einer zahl zugeordnet und ich komme von jeder zahl wieder eindeutig zum entsprechenden schlüssel zurück warum bilden wir auf natürliche zahlen ab diese natürlichen zahlen sollen jetzt als indizes in einfeld dienen bedeutet wir speichern jeden eintrag in einem feld an der stelle die uns f von dem entsprechenden schlüssel liefert jetzt haben natürlich ein problem dabei die menge der schlüssel ist unendlich groß nehme die menge der zeichenketten oder auch die menge der ganzen zahlen so unendlich groß abzählbar unendlich groß so oder so
wir kriegen damit auch unendlich viele indizes die möglich sind und bräuchten damit natürlich ein unendlich großes feld als wir nehmen gerade mal an wir hätten das tatsächlich zur verfügung also wir hätten unendlich viel speicher dann haben wir unser sucht problem schon gelöst die speichere meine daten einfach in einer unendlich großen tabelle die ich über den natürlichen zahlen indiziere indem ich jedes mal wenn ich einen eintrag einfüge für den schlüssel den index berechnen den eintrag dort einfügen und umgekehrt wenn ich den eintrag suche für den entsprechenden schlüssel den index berechnen und schaut ob an der stelle
im feld tatsächlich der eintrag auch steht das ist natürlich keine praktische lösung wir haben hier zwei probleme das erste problem ist in der praxis gibt es keine unendlich großen felder sondern unser speicher ist begrenzt das heißt ich kann nur auf eine ähnliche menge von indizes abbilden sprich meine funktion bildet nicht auf die natürlichen zahlen ab sondern auf eine endliche teilmenge ich hab's ja en genannt die an natürlichen zahlen das sind die indizes die mir in meinem feld in meine mary tatsächlich zur verfügung stellen gleichzeitig ist die menge der schlüssel die menge kann aber immer noch
unendlich groß oder zumindest potenziell unendlich groß wie man wir wollen zeichenketten einfügen und haben jetzt eine endliche index mengen feld von handlicher größe wir wissen aber nicht welche zeichenketten da kommen es gibt ab ziel war unendlich viele und selbst wenn es nicht unendlich viele sind müssen wir davon ausgehen dass die anzahl der schlüssel zumindest sehr viel größer ist als die anzahl der einträge im feld also als die anzahl der einträge die wir praktisch speichern können dazu einen jedem bemerkung wenn die anzahl der schlosser größer ist als die anzahl der indizes dann kann unsere abbildung f
natürlich nicht mehr in aktiv sein ich komme ich mir vor und wieder zurück sondern in dem fall gilt das schubfach prinzip wenn ich mehr schlüssel hat als indizes dann müssen wenigstens auf einen index mehr als ein schlüssel abbilden und damit kranke nicht mehr aktiv sein wir werden mit dieser situation umgehen müssen und wir werden das immer betiteln mit es wird so genannte kollisionen geben das heißt verschiedene schlüssel bilden auf den gleichen index ab das erste problem ist ein prinzipielles problem das zweite problem ist wir müssen eine abbildung es für beliebige klassen von schlüsseln konstruieren können
beliebige klassen von schlüsseln bedeutet für beliebige typen und auch für eine beliebig große anzahl von instanzen dieses typen brauchen eine sinnvolle definition dieser abbildung f dieses problem sollten wir irgendwie lösen können denn in der praxis sind die schlüssel wenigstens abzählbar also die menge der möglichen schlüssel ist für uns abzählbar da wir alles auch auf dem rechner speichern können müssen und speichern können wir tatsächlich nur etwas was wir auch als natürliche zahlen kodieren können und wir haben uns im letzten semester schon überlegt die menge der zeichenketten oder die menge der texte ist abzählbar unendlich das heißt
zu jeder möglichen zeichenkette gibt es genau eine natürliche zahl um sie zu kodieren die realen zahlen haben wir gelernt sind über abzählbar wir wollen auch rielle zahlen speichern können damals kurz daran erinnern dass wir alle zahlen tatsächlich im rechner nicht exakt speichern können stattdessen werden sie ab maximiert in java zum beispiel mit den typen float und double durch diese approximation ist auch klar es gibt wieder nur abzählbar viele tatsächlich für 32 bit float oder 64 bit gabel nur endlich viele möglichkeiten reli zahlen darzustellen trotzdem gilt die menge der schlüssel ist immer noch sehr groß sehr
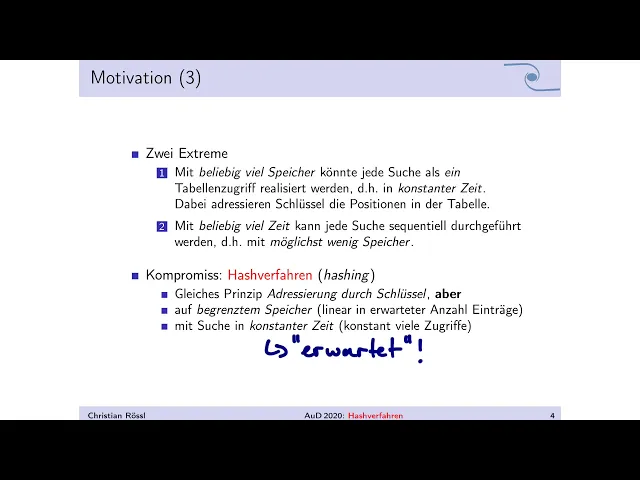
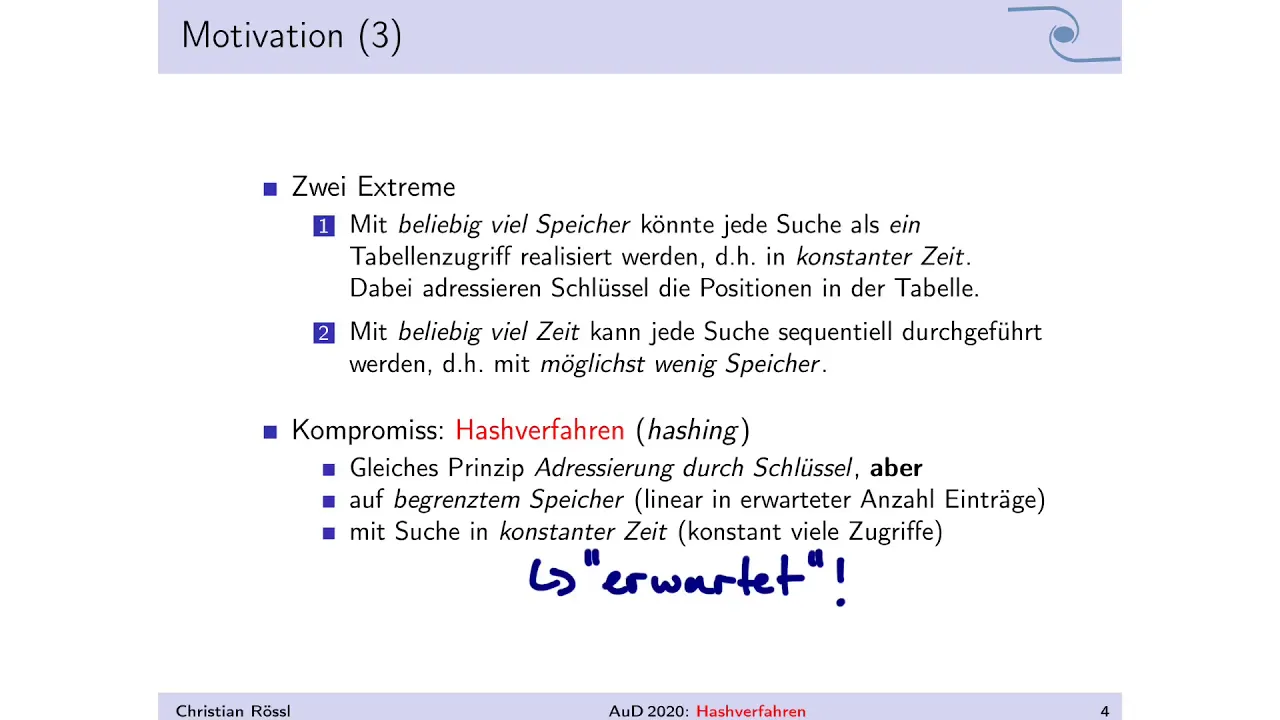
groß bedeutet abzählbar unendlich wenn ich tatsächlich beliebige zeichenketten betrachte im rechner ist immer alles endlich weil ich tatsächlich mit unendlichen objekten nicht umgehen kann so oder so wir wissen es gibt konstruktionen für solche funktionen die mir von abzählbar unendlich großen mengen auf die natürlichen zahlen abbilden denn das war genau die definition der absetzbarkeit also dieses problem wird mir irgendwie in den griff bekommen ausgehend von dieser überlegung sind zwei extreme erstens wenn wir uns vorstellen dass wir beliebig viel speicher zur verfügung hätten dann kümmern mit der überlegung von geben tatsächlich jedes suche als einen tabellen zugriff
realisieren und dieser tabellen zugriff kann in konstanter zeit erfolgen zumindest dann wenn man die funktion fmo von 1 berechnen können bzw wenn diese berechnung nicht abhängig ist von der anzahl einträge in unserer tabelle das heißt alles was wir für die suche machen müssten wir es auswerten das gibt uns den index für den entsprechenden schlüssel und damit adressieren die position des daten wird des eintrags in der tabelle das zweite extrem ist unser speicher ist begrenzt wir wollen so wenig speicher wie möglich benötigen das bedeutet wir müssen auf jeden fall jeden eintrag einmal speicher zb in einem
wir haben aber jetzt beliebig viel zeit na ja beliebig viel zeit braucht man tatsächlich nicht denn wir wissen schon wie man in einem ohne irgendwelche weiteren annehmen annahmen suchen können wir machen einfach das sequenzielle suche und können dann jeden eintrag in lineare zeit finden zwischen diesen beiden extremen wir uns bewegen mit beliebig viel speicher schaffen es auf jeden fall in ufern 1 mit beliebig viel zeit wenn man nie langsamer sein als ufern n wenn man so will sind hash verfahren ein kompromiss zwischen diesen beiden extremen wir verfolgen das gleiche prinzip wir adressieren einträge in einer
tabelle durch unsere schlüssel in dem wir schlüssel auf indizes abbilden aber wir haben jetzt begrenzten speicher und dieser speicher soll nicht nur begrenzt sein sondern der solinger in der erwarteten anzahl der einträge nur wachsen und gleichzeitig wollte eine suche in konstanter zeit ermöglichen das heißt konstant viele zugriffe auf das feld reichen um einen bestimmten eintrag zu finden bzw zu entscheiden ob der eintrag im feld vorhanden ist oder nicht tatsächlich ist es so dass das immer noch eine idealvorstellung ist denn in konstanter zeit können wir zwar suchen aber wir haben dafür keine garantie allerdings ist es
auch nicht so dass wir im mittel konstante zeit kaufen sondern es wird zu dass wir wenn man alles richtig machen erwarten können dass wir in konstanter zeit suchen können erwarten bedeutet bezieht sich hier tatsächlich auf den erwartungswert der kosten warum ist das was anderes wie wenn ich davon spricht dass wir in mittel konstante zeit brauchen weil auch wieder mit der einschränkung wenn wir alles richtig machen dann ist der schlechteste fall also dass wir in ofen in lineare zeit suchen unwahrscheinlich bzw sehr unwahrscheinlich bevor wir uns hash funktionen anschauen ich habe hier ein beispiel und zwar
ich habe einfach die nachnamen von allen leuten in der vorlesung genommen ich habe alles umgewandelt in kleinbuchstaben umlaute und so weiter transkribiert das heißt es gibt 26 mögliche zeichen buchstaben a bis z und ich stelle mir jetzt vor ich sortiere alle namen ein in eine tabelle von null bis 25 also in ein feld mit 26 einträgen genau so geht man auch in der praxis oft vor wenn man was so nennt man halt ein sortieren will in ein register im shop da habe ich dann auch zb anfangsbuchstaben ich sortiere dinge nicht ein sondern legt einfach beim
entsprechenden anfangsbuchstaben ab und bin dann mit der suche entsprechend schneller wie wenn ich den kompletten stapel durchsuchen muss im prinzip nutzen wir genau dieses für cash verfahren allerdings gibt es dabei natürlich den knackpunkt und den zehner hier im experiment wenn ich das so macht wie es gerade beschrieben hat nach dem ersten buchstaben einsortieren dann bekomme ich dieses ist kann hier also das thema hier es gibt sehr viele leute der nachname mit dem es anfängt auch sehr viele der nachname mit einem b oder mit dem h anfängt wir haben diesmal niemanden dabei dessen nachnamen kuh oder
mit einem oder auch mit nicks anfängt vielleicht ein bisschen überraschend das mit dem ixs hätte ich noch gewettet kommen vielleicht auch nicht unbedingt aber so ist es eben gerade was man auf jeden fall sehen hier ist dass die anzahl der einträge nehme das beispiel von dem register also wir haben einen schub mit 26 registern und ich habe jetzt karteikarten eine für jeden von euch eingefügt dann sehen dass diese karteikarten sehr unterschiedlich verteilt sind es gibt buchstaben die kommen häufig vor und es gibt buchstaben die kommen wenig häufig oder gar nicht vor stellen wir uns vor
wir wollen das verwenden um die arbeit zu verteilen und ich darf mir aussuchen welche buchstaben truppen ich bearbeite würde ich wahrscheinlich hier irgendwo xyz nehmen wollen haben ihren wenigsten zu tun wir würden nach den anfangsbuchstaben einsortieren weil das für uns eine sehr einfache funktion ist ja ich muss den namen anschauen ich sehe den anfangsbuchstaben kann einsortieren ich muss da nix rechnen die funktion ist definitiv auch nicht die aktiv weil ich komme ja aus den entsprechenden histogramm bis jetzt nicht mehr eindeutig zurück zu einem bestimmten namen dem rechner ist es egal was er denn für diese
abbildung tatsächlich berechnen muss da können wir auch etwas komplizierteres nehmen auf der rechten seite habe ich das gleiche histogramm mit den gleichen werten aber jetzt eine andere funktion genommen um die indizes von null bis 25 zu berechnen und zwar weiß ich einfach jeden buchstaben einen wert die position im alphabet ich nehme hier von null bis 25 zu und ich suche mir diese werte für alle namen einfach auf es ist immer noch eine sehr einfache funktion im sinne von einer hash funktion wenn man sehen ist nicht unbedingt gut aber es ist eine funktion die man tatsächlich
berechnen könnten aber ja um ein register einzufügen wäre es mir wahrscheinlich zu viel kopf rechnerei den rechner stört das aber nicht also wir berechnen diese summe und nehmen das ergebnis dann einfach modeln 26 um den index zwischen null und 25 zu bekommen und was wir sehen ist dass unter dieser abbildung die einträge sehr viel gleichmäßiger gestreut werden über die einzelnen registerkarten oder in dem fall über die einzelnen bands von dem histogramm und genau das wollen wir gleich erreichen wenn wir hash funktionen konstruieren wir wollen erreichen dass diese funktionen möglichst gut streuen über ein feld hier
als ein histogramm dargestellt möglichst gut streuen bedeutet dass die zahlen die wir hier berechnen oder die höhe der beiden histogramm nicht zu stark variiert und hier sieht man deutlich den unterschied von links zu recht