Jusqu’à présent, nous avons vu des méthodes qui permettaient de décrire des individus variable par variable, telles que les statistiques descriptives ou des tableaux de fréquence. Les méthodes d’analyse multidimensionnelles décrivent les comportements des individus en fonction de plusieurs variables en même temps. Plusieurs variables peuvent exprimer la même idée ou la même dimension.
Ici, par exemple, les retraits et les emprunts cumulés et le nombre de comptes expriment le niveau d’« activité bancaire » d’un individu. Si on calculait les coefficients de corrélation, on constaterait une forte corrélation entre ces trois variables. L’Analayse en Composantes Principales (ACP) va permettre de mettre en évidence les groupes de variables exprimant une même dimension et de réduire ainsi le nombre de variables de l’étude.
Dans notre exemple, trois variables expriment la même idée d’« activité bancaire ». Au lieu de considérer les trois variables séparément, on n’en considérera qu’une seule qui résume l’idée d’« activité bancaire ». Mais pourquoi on cherche à réduire le nombre de variables ?
La réponse est simple : c’est pour simplifier nos analyses. On peut facilement comparer les individus en fonction d’une seule variable, en utilisant le positionnement sur un axe. On peut aussi aisément représenter le positionnement d’individus en fonction de deux variables.
Au-delà de deux variables, la représentation est moins aisée, voire impossible. Certains logiciels permettent de visualiser un nuage de point en trois dimensions, mais il faut faire tourner le nuage pour avoir une bonne perception du positionnement des individus. L’ACP permet de positionner les individus en fonction de plusieurs variables sur un graphique en utilisant des variables synthétiques, appelées dimensions.
La construction des dimensions se fait à partir de variables quantitatives ou de variables qualitatives ordinales, comme des variables d’échelle. Idéalement, les variables quantitatives sont distribuées selon une loi normale. Les variables peuvent être exprimées dans des unités très différentes (salaire en euros, expérience en années, absence pour maladie en jours, …) mais pour éviter les effets d’échelle et assurer que chaque variable ait le même poids dans l’étude, les variables doivent être standardisées (on dit aussi centrées réduites).
Standardiser une variable signifie lui enlever sa moyenne et diviser le résultat par l’écart-type. Toutes les variables centrées réduites ont ainsi pour moyenne 0 et pour écart-type 1 et sont en quelque sorte exprimées dans une même unité. Comment fonctionne l’analyse en composantes principales et plus particulièrement comment sont construites les nouvelles dimensions ?
Prenons un exemple avec 5 étudiants pour lesquels on dispose de la note dans 3 matières. On peut représenter ces 5 individus dans un espace à trois dimensions. Avec un peu d’imagination on visualise un nuage de points en trois dimensions.
On peut voir par exemple que Marie et Lenny ont des notes globalement plus faibles que Bob, Kevin et John. L’ACP consiste à tracer une droite passant par la direction où le nuage de point est le plus allongé. Cet axe est donc construit à partir des variables les plus dispersées, c’est-à-dire celles qui font « le plus la différence » entre les individus.
Cet axe va restituer la plus grande partie de la variance des données. C’est notre première dimension. L’équation de l’axe est une combinaison linéaire des variables d’origine.
Ici, l’axe est une combinaison linéaire des trois variables Maths, Drit et Eco. Les variables ayant le plus de poids sur cette dimension sont celles qui font le plus la différence entre les individus. Dans ce cas il s’agit des matières Drit et Eco.
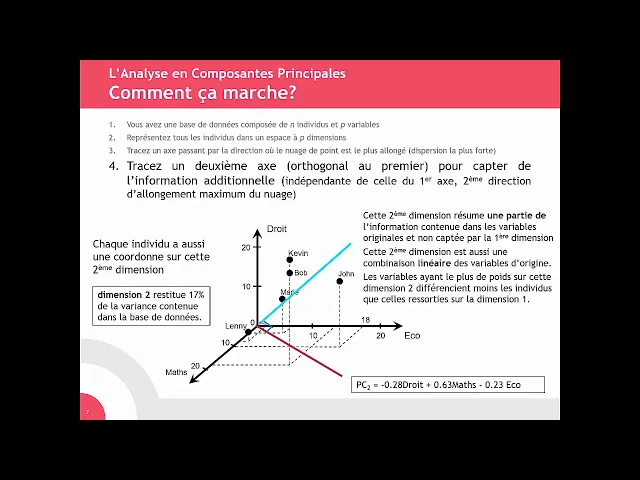
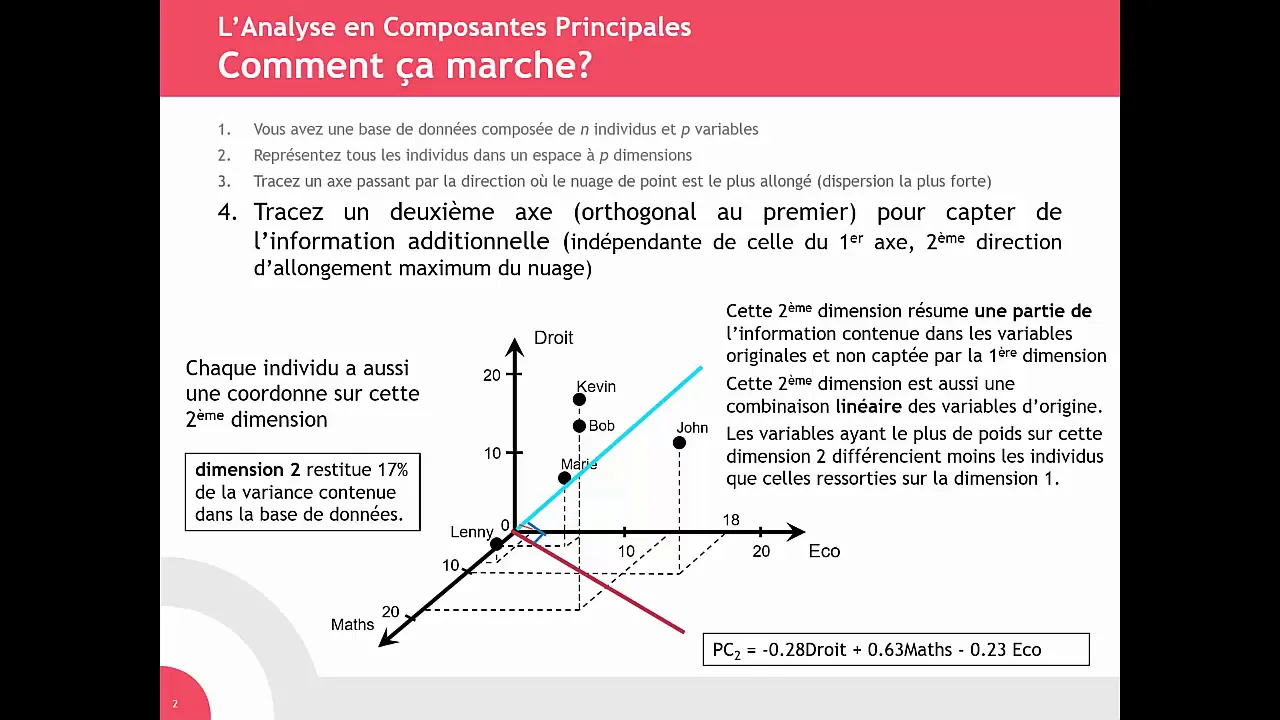
Chaque individu a un score sur cette dimension en fonction des valeurs des variables d’origine. Par exemple, sur cette dimension John aura un score plus important que Marie. La dimension 2 est construite selon le même principe que la dimension 1.
Elle passe par la deuxième direction d’allongement maximum du nuage. Elle est donc construite à partir de variables un peu moins dispersées que celles ayant contribué à la création du premier axe. Cette dimension 2 est construite aussi de manière à être perpendiculaire à la dimension 1.
Ainsi, sur un graphique, l’information apportée par les deux dimensions est indépendante et on pourra la combiner pour expliquer le positionnement et les caractéristiques d’un individu. Dans notre exemple la variable qui contribue le plus à la dimension 2 est la variable « Maths ». L’algorithme de l’ACP identifie autant d’axes qu’il y a de variables dans la base de données.
S’il y a sept variables dans votre base de données, l’algorithme extraira sept dimensions. Alors, combien de dimensions faut-il garder ? On se base sur un indicateur appelé « valeur propre » ou « eigenvalue » en anglais.
Une variable d’origine a une valeur propre de 1. Comme nous cherchons des dimensions qui font la synthèse de plusieurs variables, on retient les dimensions dont les valeurs propres sont supérieures à 1. Une deuxième approche consiste à étudier le graphique des valeurs propres et à retenir toutes les dimensions jusqu’à observer une forte diminution de la valeur propre.
Revenons à notre exemple. Nous avons élargi notre base de données à 12 élèves décrit sur 7 matières. On retient les deux premières dimensions.
Compte tenu des valeurs propres, la deuxième dimension n’apporte qu’une information marginale par rapport à la première. Les deux premières restituent 92% de la variance contenue dans les données. En d’autres termes, en passant de sept variables d’origine à deux variables synthétiques, on conserve 92% de l’information !
L‘étude des valeurs propres nous dit combien d’axes ou dimensions retenir, mais il faut maintenant décrire ces dimensions. Il faut relever en s’aidant du tableau les variables qui sont les plus corrélées à chacune des dimensions. La coordonnée d’une variable sur une dimension est aussi le coefficient de corrélation entre cette variable et cette dimension.
La corrélation peut être positive ou négative. On relève pour chaque dimension les variables ayant un coefficient de corrélation supérieur à 0,5 en valeur absolue. Dans notre exemple, les variables Math, Physique, Biologie et Chimie sont corrélées positivement avec la dimension 1.
Les variables Anglais et Histoire sont corrélées négativement. La dimension 1 oppose ainsi les étudiants qui ont des notes élevées en Math, Physique, Biologie et qui seront à droite de l’axe, car la corrélation est positive, aux étudiants qui ont des notes élevées en Anglais et Histoire et qui seront à gauche de l’axe, car la corrélation est négative. La dimension 1 peut se nommer : « opposition entre les littéraires aux scientifiques ».
La matière Sport est positivement corrélée à la dimension 2. C elle-ci oppose les étudiants ayant de bonnes notes en sport (en haut de l’axe) aux autres (en bas de l’axe). La dimension 2 peut se nommer « capacités en sport ».
L’ACP calcule les coordonnées ou scores des individus sur ces nouvelles dimensions que l’on peut représenter avec un graphique en nuage de points. Le centre du graphique représente l’individu moyen. Par exemple, Edward a un score positif sur l’axe 1, c’est donc plutôt un scientifique.
Il a un score négatif sur l’axe 2 donc ses notes en sport sont en dessous de la moyenne. A l’opposé, John est plutôt littéraire et a de bonnes notes en sport. A l’opposé, John est plutôt littéraire et a de bonnes notes en sport.
Pour résumer, l’ACP est utilisée pour réduire un grand nombre de variables dans une base de données à un nombre plus petit de dimensions synthétiques. Elle est utile pour résumer les données et cartographier les individus selon les dimensions clés.